
AI 網關與 AI 安全網關:同一段鏈路上的兩種承諾,爲什麼不能合併成一個組件
先說清楚這篇文章要解決的問題。這兩類產品在 PPT 上長得幾乎一樣:都插在應用和模型之間,都畫在同一個位置,都聲稱「統一入口」。所以採購時最常見的錯誤不是選錯了產品,是把兩種承諾當成一種,以爲買了一個就有兩個。
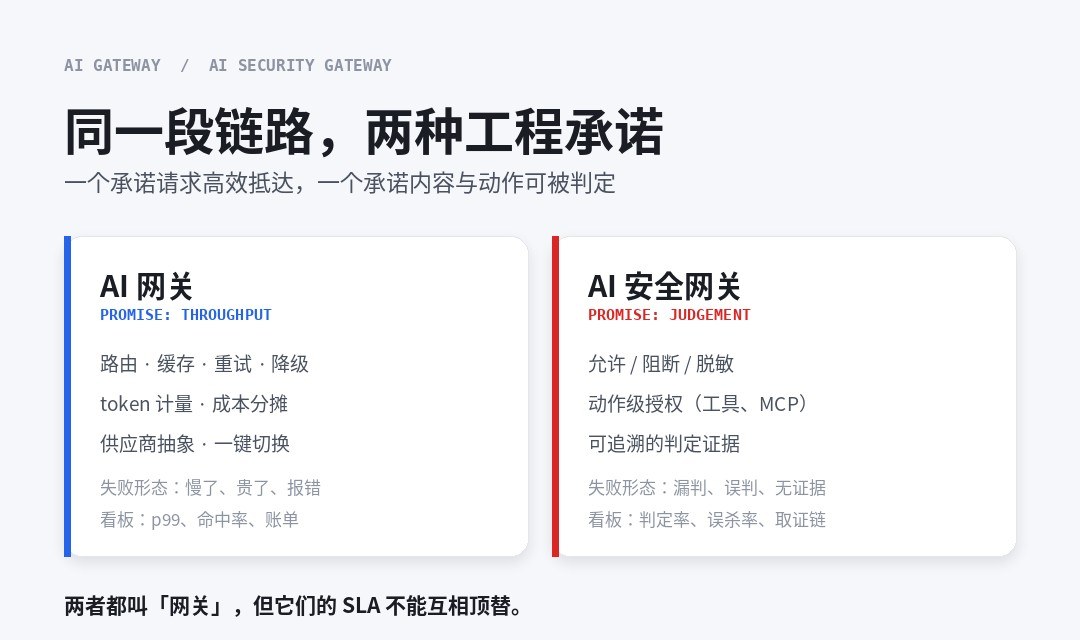
它們確實跑在同一段鏈路上。但承諾的東西完全不同:一個承諾請求高效抵達,一個承諾內容與動作可被判定、阻斷與追溯。前者失敗了是「慢了、貴了、報錯」,後者失敗了是「放過了一個不該放的」——而第二種失敗,你的監控通常不會報警。
下面不按功能清單對比,按三處結構性衝突來拆。這三處衝突不是我編的,是兩家廠商的官方文檔裏自己寫出來的。
一、四個詞,先分開
這一行的名詞已經通脹到沒法直接用了。API 網關、LLM 網關、AI 網關、AI 安全網關,經常在同一個方案裏混着出現,而寫方案的人自己也不一定分得清。
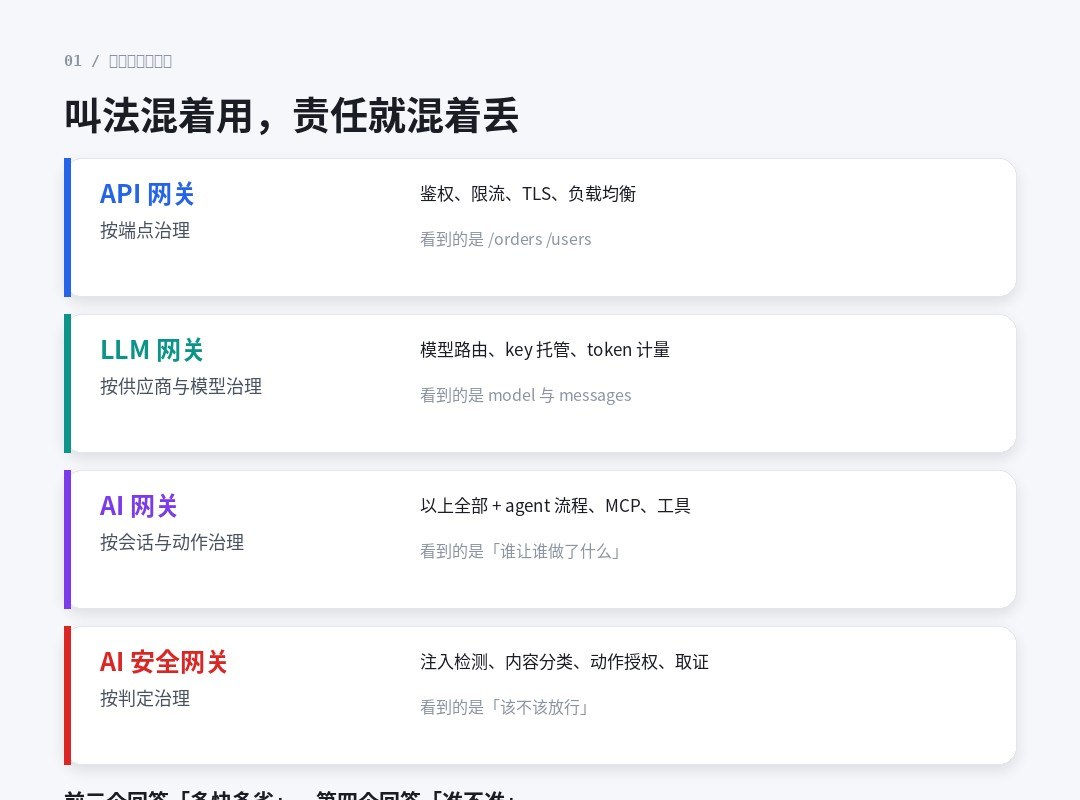
| 名稱 | 治理的對象 | 典型能力 | 它「看見」什麼 |
|---|---|---|---|
| API 網關 | 按端點 | 鑑權、限流、TLS 終止、負載均衡、轉發 | /orders、/users |
| LLM 網關 | 按供應商與模型 | 模型路由、key 託管、token 計量、流式格式轉換 | model 字段與 messages 數組 |
| AI 網關 | 按會話與動作 | 以上全部 + agent 工作流、MCP、工具調用、成本歸集 | 誰讓誰做了什麼 |
| AI 安全網關 | 按判定 | 注入檢測、內容分類、動作授權、取證留痕 | 該不該放行 |
這張表裏最關鍵的一列是最後一列。前三行看的是「請求長什麼樣」,第四行看的是「這個請求該不該被允許」。前者是轉發問題,後者是判斷問題。轉發可以做到 99.99% 可用,判斷做不到——因爲判斷本身就有誤判率。
API7 那篇對比文章裏有句話說得挺準:真正的區別不在誰更「正確」,而在它們被設計來理解哪種流量。傳統 API 流量是端點式的,LLM 流量是模型與 token 式的,agentic 流量是「一次用戶請求觸發多次模型調用、MCP 工具調用、內部 API 調用、檢索和業務動作」。層級越往下,能看見的東西越多,責任也越重。
二、衝突一:緩存會繞過判定
這是我認爲最值得寫的一條,因爲它是結構性的,不是實現缺陷。
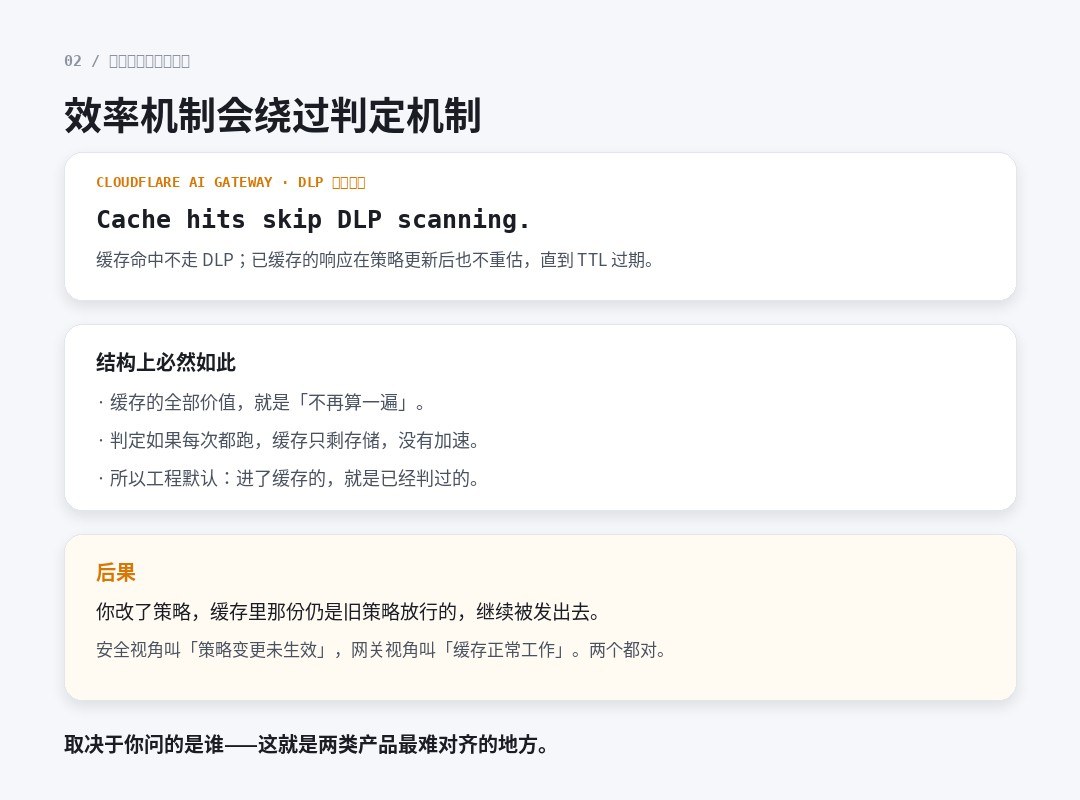
Cloudflare 的 AI Gateway DLP 文檔裏有一句原話,很短:
Cache hits skip DLP scanning.跟着還有一句更要緊的:如果你在響應被緩存之後更新了 DLP 策略,那份緩存不會被重新評估,它會繼續被發出去,直到 TTL 過期。
爲什麼會這樣?因爲不難理解:緩存的全部價值就是「不再算一遍」。如果每次命中都要重新跑一遍判定,緩存就只剩存儲,沒有加速了。所以在工程上,「進了緩存 = 已經判過」是一個必然的默認假設。
這個假設在性能語境下完全成立,在安全語境下有一個洞:策略是會變的。你今天加了一條規則,昨天緩存的響應不受影響。安全團隊管這個叫「策略變更未生效」,網關團隊管這個叫「緩存正常工作」。兩個說法都對,取決於你問的是誰。
Cloudflare 的處理算是比較老實的:Flag 的響應照常進緩存,Block 的響應不進。但它同時承認了策略更新後的重估缺口。要消掉這個缺口,只能縮短 TTL,而縮短 TTL 又直接削弱緩存的價值——這是一對天生的矛盾,沒有兩全的配置。
三、衝突二:流式與判定不能同時滿足
第二個衝突更直觀,而且直接體現在用戶能感知的延遲上。
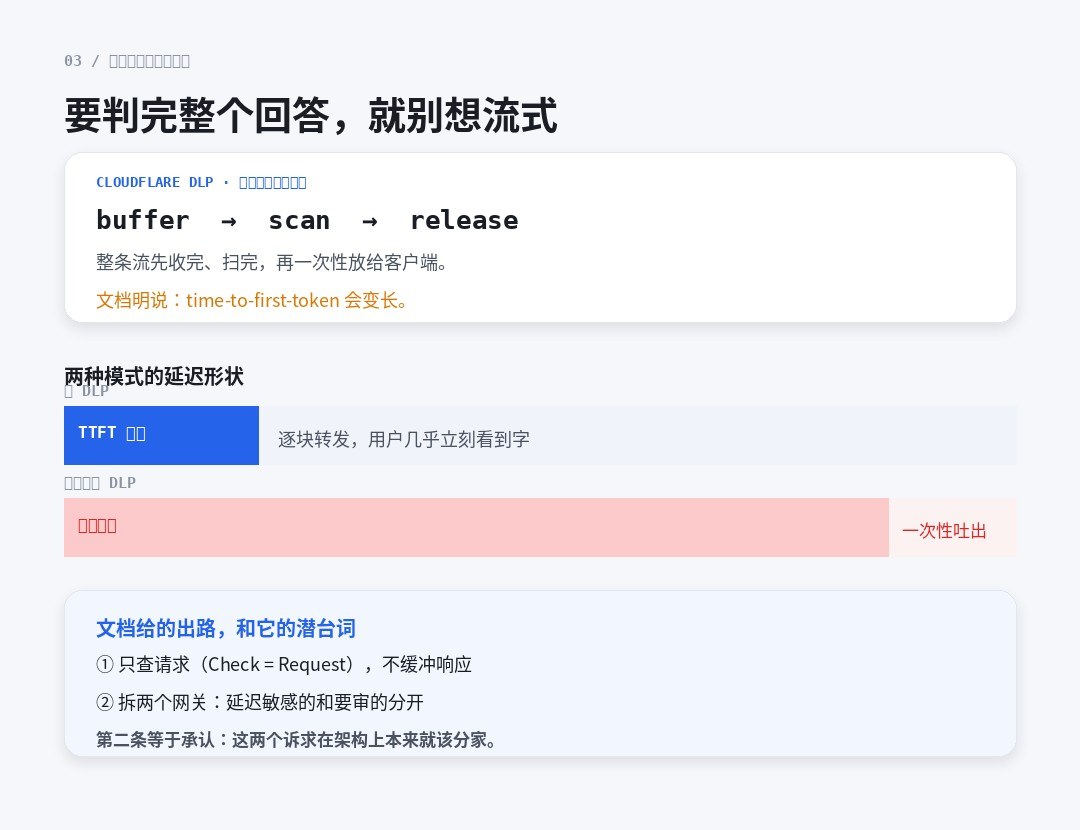
Cloudflare 的 DLP 文檔寫得很清楚:開了響應側掃描,遇到 SSE 流式請求時,網關會把整條響應緩衝完、掃完,再一次性放給客戶端,文檔裏明確提示 time-to-first-token 會變長。
這就是「緩衝」這個動作的代價。你要判定一整段內容,就必須先拿到一整段內容。而流式的全部意義,就是不必等一整段。兩者在物理上衝突。
文檔給了兩條出路,我覺得第二條纔是真話:
- 只查請求(Check 設爲 Request),響應側不做緩衝掃描——請求側不緩衝,對延遲沒有影響。
- 拆兩個網關:延遲敏感的流量走一個,需要審的流量走另一個。
第二條等於承認了一件事:「快」和「可審」在架構上本來就該分家。硬塞進同一個組件裏,最終一定是某一方讓步——要麼用戶等着,要麼審查跳過。
順帶說一個很多人沒注意的細節:Cloudflare 的 DLP 策略是網關級的,沒有 per-request 的開關可以選不同的 DLP profile,也不能針對單個請求繞過。文檔的建議是按用途建多個網關。這進一步說明「一個網關管所有事」這個模型本身就有問題。
四、衝突三:失敗的時候往哪邊倒
第三個衝突是最容易出事、也最少被討論的:組件掛掉的時候,默認是放行還是拒絕。
網關的工程傳統是 fail open。理由很實在:網關是鏈路中間的一跳,它掛了整條業務就斷了,而大多數時候「斷業務」比「少一層檢查」更嚴重。安全產品的傳統反過來,是 fail closed:檢查不了,就別放過去。
這兩個傳統撞在一起,結果通常是誰的代碼在鏈路上誰說了算。
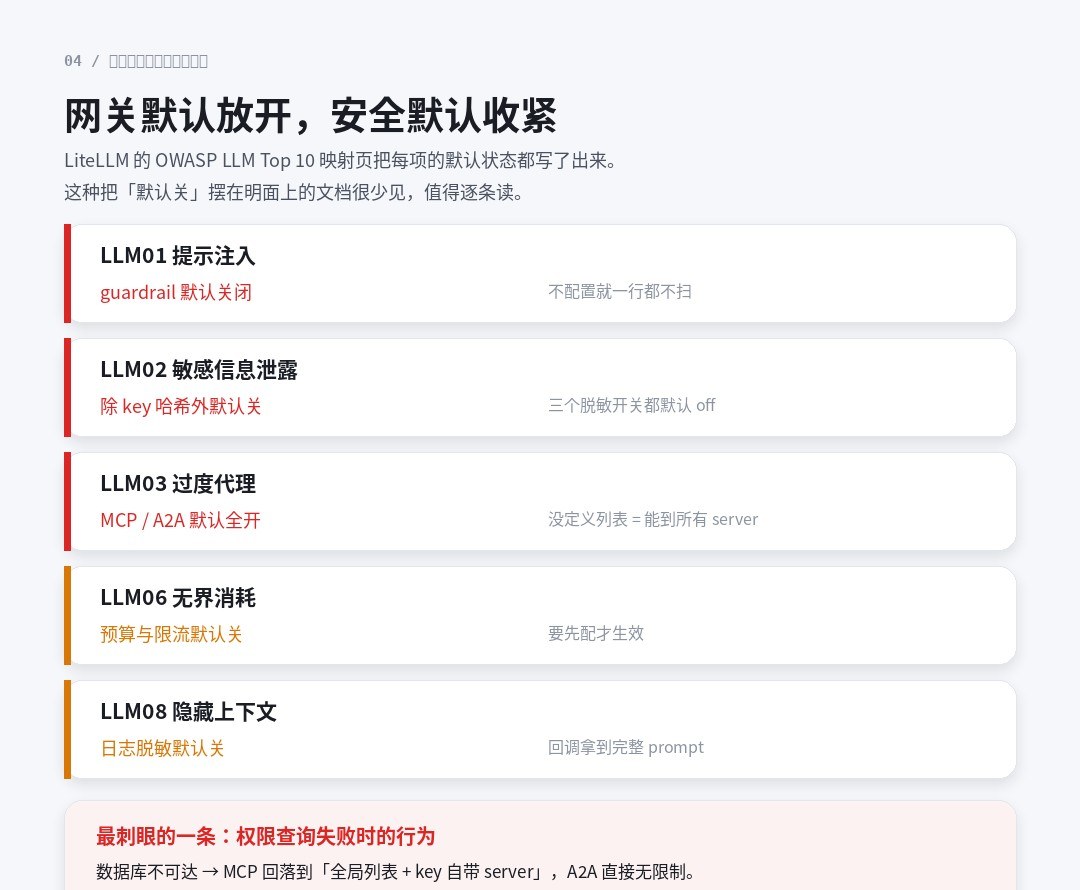
LiteLLM 那份 OWASP LLM Top 10(2026)映射文檔,是我見過最誠實的材料之一:它把每一項的默認狀態逐條列了出來,而且明說「幾乎每個控制在你配置之前都是關的」。
| OWASP 項 | 默認狀態 |
|---|---|
| LLM01 提示注入 | Off(不配置 guardrail 就一行都不掃) |
| LLM02 敏感信息泄露 | Off,除 key 哈希之外 |
| LLM03 過度代理 | Open until granted(沒定義列表 = 能到所有 MCP server) |
| LLM04 供應鏈 | On |
| LLM06 無界消耗 | Off |
| LLM08 隱藏上下文曝光 | Off |
| LLM10 輸出處理不當 | Off |
這份表裏有一行我必須單獨拎出來,因爲它的後果比「默認關」嚴重一個量級:
「當權限查詢失敗、因爲數據庫不可達時,MCP 會回落到全局列表加 key 自己提交的 server,A2A 則返回無限制訪問。」
翻一下:安全組件掛了,本應全拒,這裏是全放。而且是在「過度代理」這個 2026 年剛往前挪了三名的風險項上。文檔沒有掩飾這一點,還附了待處理的 PR 編號——這種透明度值得肯定,但也說明它現在就是這樣。
這條對架構的啓示很直接:如果安全判定和流量轉發是同一個進程、同一個失敗域,那麼轉發的可用性要求會污染判定的嚴格性。要判定不該跟着轉發一起 fail open,最乾淨的辦法就是讓它跑在另一個失敗域裏。
五、衝突的根源:兩個 SLA 無法同時滿足
把上面三條放在一起看,會發現它們不是三個孤立的 bug,是同一個矛盾的三次顯形。
| 維度 | AI 網關 | AI 安全網關 |
|---|---|---|
| 優化目標 | 吞吐、延遲、成本 | 判定準確率、可追溯性 |
| 可接受延遲 | 越多越快越好,p99 是核心指標 | 單次判定幾十毫秒是可接受成本 |
| 失敗方向 | 傾向放行(保可用) | 傾向拒絕(保正確) |
| 策略變更 | 配置後漸進生效即可 | 必須立即、全局生效 |
| 緩存 | 核心能力 | 會繞過判定 |
| 流式 | 必須支持 | 與整段判定衝突 |
| 驗收方式 | 壓測、命中率、賬單 | 繞過測試、誤殺率、取證完整性 |
注意「策略變更」那一行。這一行是我認爲最能區分兩類產品的地方:網關的策略是配置,安全網關的策略是承諾。配置改錯了可以回滾,承諾失效了要寫事故報告。所以前者能接受「幾分鐘後生效」,後者不能。
當一件事既要求「儘可能快」,又要求「一次都不能漏」,它就不是一個組件能同時滿足的需求。
六、怎麼分工:按「失敗了誰背」切
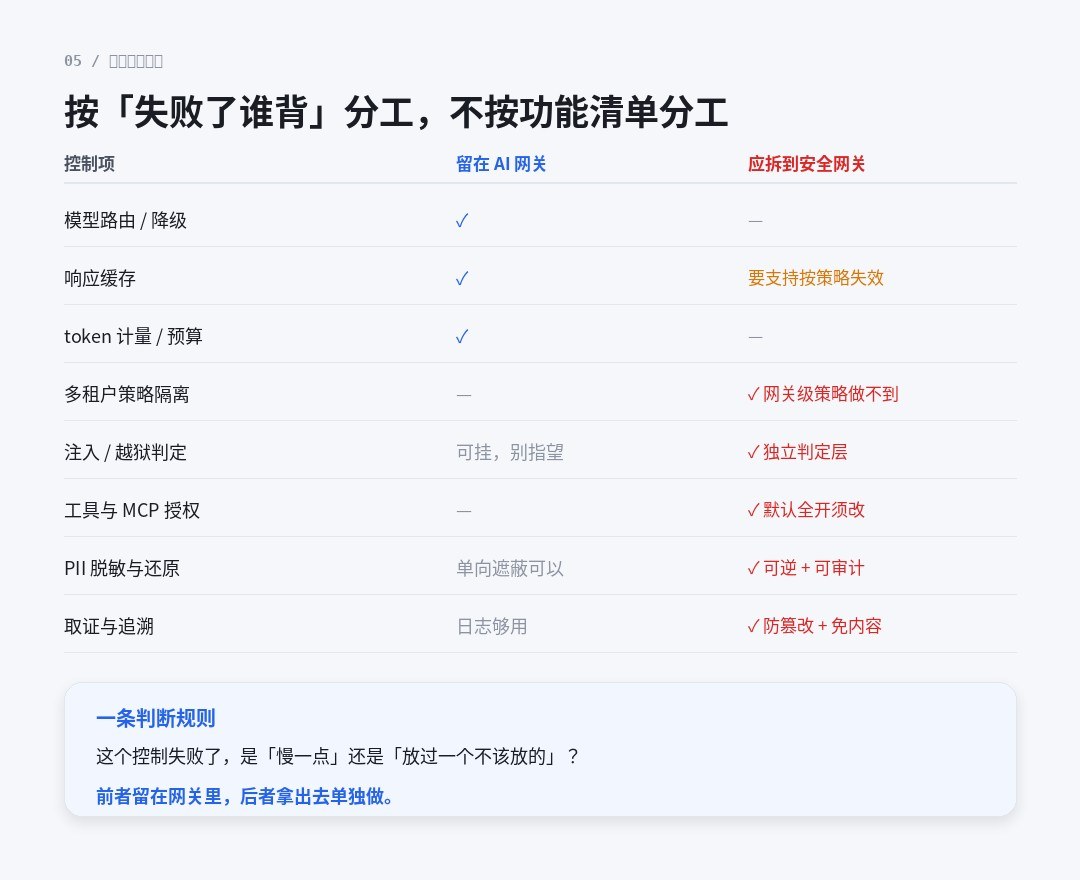
我不建議按功能清單分工,因爲功能清單永遠是重疊的。按一個問題切更清楚:這個控制失敗了,是「慢一點」,還是「放過一個不該放的」?
前者留在 AI 網關裏,後者拿出去單獨做。落到具體項上:
| 控制項 | 留在 AI 網關 | 應拆到安全網關 |
|---|---|---|
| 模型路由 / 降級 | ✓ | — |
| 響應緩存 | ✓ | 需支持按策略主動失效 |
| token 計量 / 預算 | ✓ | — |
| 多租戶策略隔離 | — | ✓ 網關級策略做不到 |
| 注入 / 越獄判定 | 可掛接,別當主防線 | ✓ 獨立判定層 |
| 工具與 MCP 授權 | — | ✓ 默認全開須改 |
| PII 脫敏與還原 | 單向遮蔽可以 | ✓ 可逆 + 可審計 |
| 取證與追溯 | 日誌夠用 | ✓ 防篡改 + 免內容存儲 |
三項值得展開的地方
- 多租戶策略隔離。Cloudflare 的 DLP 策略是網關級的,要按租戶區分只能建多個網關。如果你的業務是多租戶 SaaS,這一條會直接決定架構形狀。
- 可逆脫敏。傳統 DLP 是「檢測—阻斷」,而 AI 場景常常需要「檢測—脫敏—還原」:把 PII 在出站前抹掉,在響應回來時還原成用戶自己的數據。這是單向遮蔽做不到的。
- 免內容取證。爲了取證而存原始 prompt,等於自己造了一個合規雷區。元數據 + 被檢內容的哈希,既滿足審計又不製造新的數據資產——這一條我認爲是安全網關和普通網關日誌的分水嶺。
七、如果只做一件事
很多團隊的現狀是:AI 網關已經上了,安全網關還在預算裏。這種狀態下的風險不在「沒有安全網關」,而在「以爲有了」。
所以如果只能做一件事,我建議做這個:先把默認值全部翻一遍。
理由很直接:上面那些 Off,不是配置錯了,是出廠就是 Off。你的網關跑在生產上,流量是真的在過,但絕大多數控制項從來沒被打開過。這件事不需要採購、不需要新預算、不需要架構評審,只需要半天時間和一份清單。
- 列出你網關上所有 guardrail / 策略項,以及它們當前的開關狀態。
- 把「默認關」的逐條標註業務影響,至少把 LLM01(注入)、LLM03(工具授權)、LLM02(脫敏)三項打開。
- 檢查失敗方向:模擬一次權限查詢失敗,看它是放行還是拒絕。這一條最容易被忽略,也最致命。
- 確認緩存 TTL 與策略變更的關係:策略改了,舊緩存多久失效。把這個數字寫進變更流程。
- 確認響應側掃描對流式的處理:如果開了,用戶感知的 TTFT 是多少;如果關了,等於放棄了輸出側判定。
做完這五條,你會得到一個比任何對比表都準確的結論:你現在擁有的到底是「一個網關」還是「一個安全網關」。
八、最後:這兩種承諾爲什麼不能合併
回到標題裏那個說法——同一段鏈路上的兩種工程承諾。
我想強調的不是「它們不一樣」,而是「它們不一樣,而且這個不一樣是結構性的,不會隨着產品成熟而消失」。
緩存必然繞過判定,因爲緩存的定義就是不再計算。流式必然與整段判定衝突,因爲判定的前提是先有全部內容。轉發必然傾向放行,因爲它的職責是保可用性。這三條裏沒有一條是工程水平問題,全是目標函數的差異。
所以正確的做法不是找一個「兩個都做得好」的產品,而是承認這是兩層,然後把它們放在不同的失敗域裏,各自優化各自的目標。中間用明確的接口連起來:網關負責「送到」,安全網關負責「準不準放」。
這也是爲什麼我不太相信「一體化 AI 安全網關」這類說法。一體化的產品確實存在,也確實好用,但當它同時宣稱高吞吐和零漏判時,通常意味着其中一項是在特定條件下成立的——而那個條件,往往不會寫在對比表裏。
能送到,和該不該送到,是兩件事。把它們放進同一個組件,遲早要有一個讓步。