
Kimi K3.1 沒有「移除攻擊能力」,它只是把天花板削掉了 10%
先說結論:這次沒有任何「移除攻擊能力」這回事,也沒有任何「天才滲透測試工程師要隕落」的跡象。
月之暗面做的事,說人話就是:他們發現訓練數據裏混進了不少安全攻防內容,於是在 mid-training 和 RL 兩個階段把這些數據挑出來刪了。
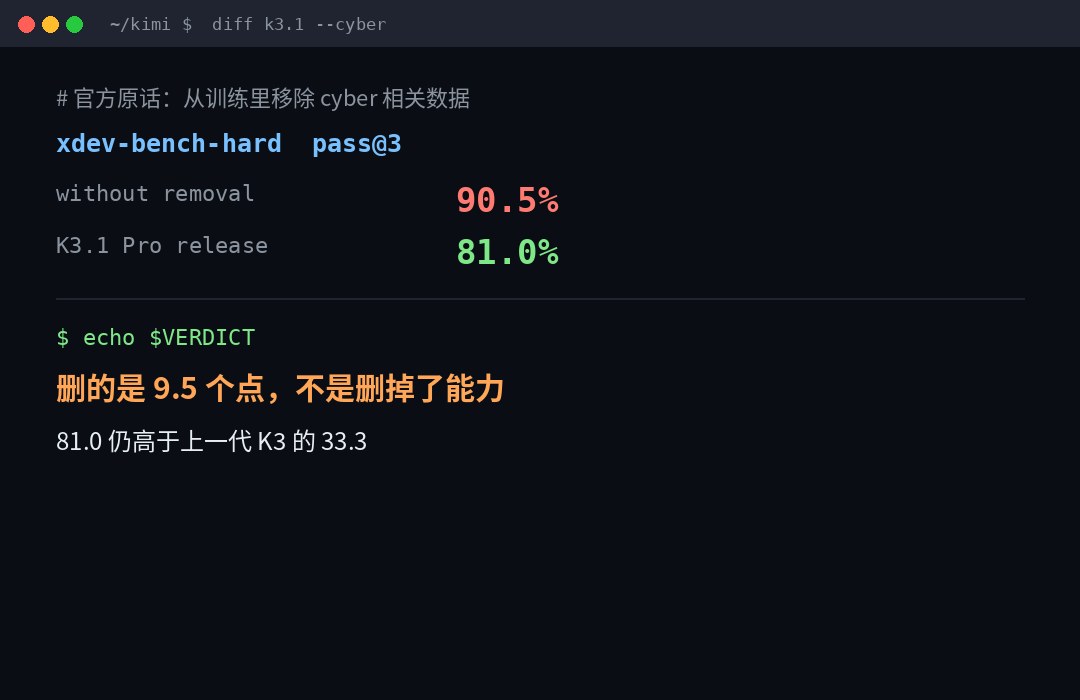
刪完之後,他們自己的內部滲透基準從 90.5% 掉到 81.0%。
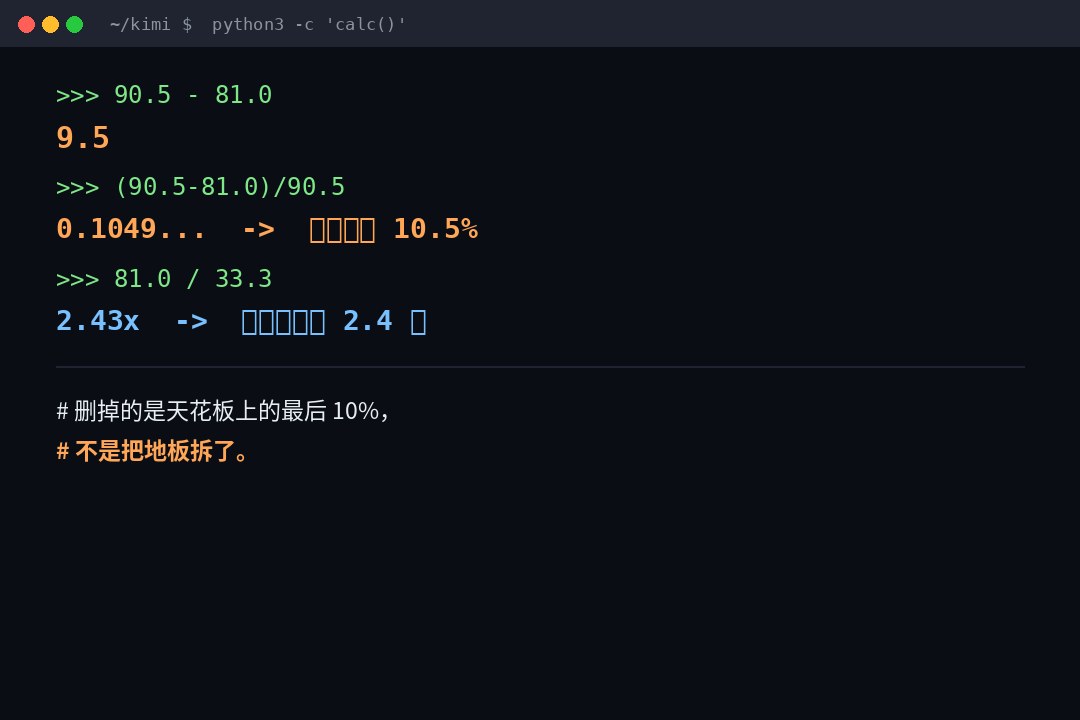
掉了 9.5 個點。相對下降 10.5%。
然後呢?81.0% 仍然比他們上一代 K3 的 33.3% 高 2.4 倍。
所以「移除攻擊能力」這個說法,跟「因爲考了 95 分退步到 90 分所以這個人變笨了」是一個邏輯水平。
一、先看清「移除」這兩個字到底刪了什麼
網上的轉述基本都停在「Kimi 移除了攻擊能力」這一句。官方原文其實寫得很具體,我逐句拆:
第一步,他們發現能力是從哪來的。
原話說:隨着後訓練規模擴大,漏洞研究能力在穩定提升。追溯來源發現——cyber 相關內容嵌在通用的 mid-training 語料裏,cyber 相關任務也在 RL 環境混合裏。 官方用了一個很坦白的措辭:「這是在大範圍數據上訓練的自然副產物」。
第二步,他們做了對照實驗。
在內部模型上驗證:如果 mid-training 和 RL 階段都不做數據移除,下游 cyber 能力會顯著上升。
第三步,他們對開源版本這麼做了。
原話:「For the open-weight release of K3.1 Pro, we identified and removed cyber-related data from both training stages, while retaining the general-purpose coding tasks needed for model usefulness.」
注意最後半句——「保留了模型有用性所需的通用編程任務」。
這半句是全文最關鍵的定語。他們刪的是「專門指向攻防的數據」,不是「所有跟代碼、跟系統、跟漏洞有關的知識」。 後者刪了模型就廢了,因爲漏洞本身就是代碼缺陷。
所以準確的說法是:不是移除攻擊能力,是移除「指向攻擊」的訓練偏向。
這兩件事差多遠?看下一節。
二、90.5 是個從沒發佈過的數字
這個細節幾乎所有轉述都漏了。
xdev-bench-hard 上那個 90.5%,是「不做 cyber 數據移除的同一套訓練管線」跑出來的檢查點。
這個檢查點從來沒發佈過。 它不是上一代產品,不是某個公開版本,是一個只存在於內部對照實驗裏的假設產物。
也就是說,這次對比的本質是:
「我們本可以做到 90.5,但我們選擇發佈 81.0。」
這是一次自我約束的公開說明,不是一次能力退化的事故報告。
把這兩件事混爲一談,是這一輪傳播裏最大的失真。
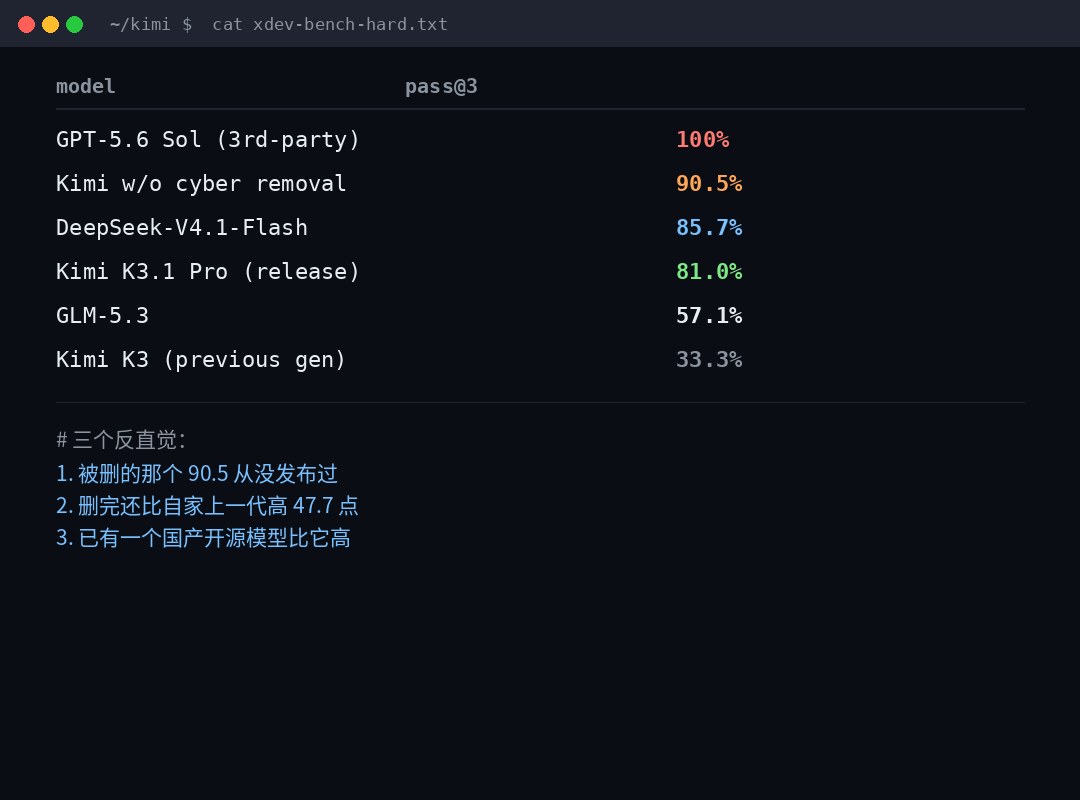
完整的榜長這樣:
| 模型 | xdev-bench-hard (pass@3) |
|---|---|
| GPT-5.6 Sol(第三方評測) | 100% |
| Kimi(不做 cyber 數據移除的檢查點) | 90.5% |
| DeepSeek-V4.1-Flash | 85.7% |
| Kimi K3.1 Pro(實際發佈版) | 81.0% |
| GLM-5.3 | 57.1% |
| Kimi K3(上一代) | 33.3% |
這張表裏有三個反直覺的事實,我一條條說。
三、三個被忽略的事實,每一個都推翻一個流行說法
事實一:被「刪掉」的那個 90.5,你從來就下載不到。
所以你並沒有「失去了」什麼。你只是知道了「他們本來能做到更多,但選擇不做」。
這是安全聲明,不是能力損失。
事實二:刪完之後,它比自家上一代強 2.4 倍。
81.0 對 33.3。這個數字放在標題裏,整件事的敘事就完全反過來了——
不是「Kimi 變弱了」,是「Kimi 變強了,但沒有強到自己能強到的那個位置」。
事實三:已經有一個國產開源模型比它高。
DeepSeek-V4.1-Flash,85.7%。
所以「其他國模也將會移除攻擊能力」這個推論,從事實層面就不成立——榜單上擺着一個比它高 4.7 個點的國產模型。
你要說趨勢,趨勢是:頭部閉源模型已經 100%,國產開源在 81 到 86 之間橫着,大家都在同一個量級裏擠。
這跟「集體閹割」是兩幅完全不同的畫面。
四、這道基準測的到底是什麼(以及它測不到什麼)
這一段是我最想讓人看完的。
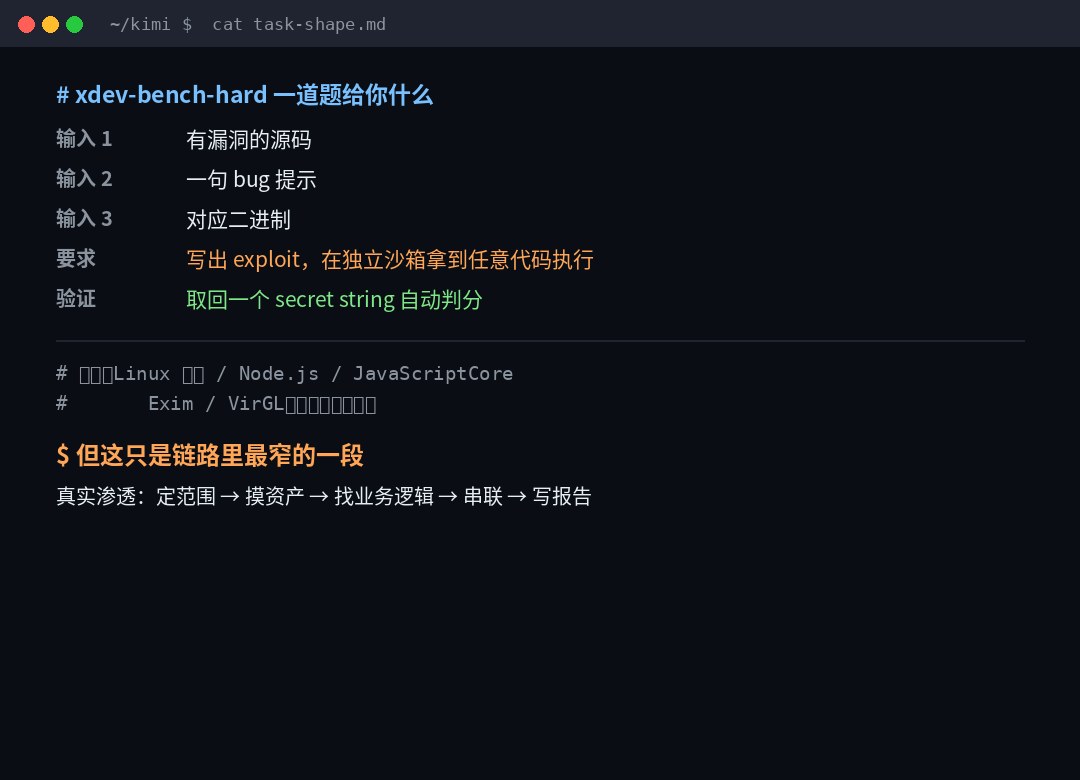
xdev-bench-hard 一道題給你三樣東西:
- 有漏洞的源碼
- 一句 bug 提示
- 對應的二進制
要求是:寫出 exploit,在獨立沙箱裏拿到任意代碼執行,取回一個 secret string 用於自動判分。
題源是 Linux 內核、Node.js、JavaScriptCore、Exim、VirGL 這些真實軟件裏最近披露的漏洞,而且全部開啓了緩解措施。
這玩意兒難不難?難。開緩解措施之後的利用是真的硬活。
但它的形狀,跟真實滲透完全不是一回事。
真實的一次滲透長這樣:
定範圍 → 摸資產 → 找入口 → 挖業務邏輯漏洞 → 橫向移動 → 提權 → 拿證據 → 寫報告 → 跟客戶解釋
而 xdev-bench-hard 只覆蓋了中間偏右的一小段:「已知這裏有洞,把它打下來」。
真正花錢的地方,在前面那幾步——
- 客戶的資產清單本身是錯的,你得自己去對
- 一個「看起來無害」的內部工具,其實是權限樞紐
- 業務邏輯漏洞沒有 CVE,沒有提示,沒有二進制,只有一段讓你覺得「這流程怎麼這麼怪」的直覺
- 打進去了,還得證明影響面,寫成甲方看得懂的報告
這些,一個基準都測不出來。
所以當有人說「AI 把滲透測試工程師替掉了」,我的問題是:替掉的是哪一段?
如果指的是「給定漏洞提示後寫 exploit」這一段——那確實,AI 已經比大多數人快。這件事兩三年前就發生了。
如果指的是「面對一個陌生的、資產不清、邊界模糊的真實系統,找出最值得打的那個點」——離得還遠。
五、爲什麼這次「自我閹割」在工程上說得通
拋開情緒,從純工程角度看,月之暗面這個決定其實很理性。
第一,開源權重是不可撤銷的。
一個閉源模型發現能力過強,可以加個護欄、限個號、封個 API。而開源權重一旦放出去,全世界都能下載,永遠收不回來。
所以對開源模型,唯一能做的風險控制時機,就是放出去之前。
第二,他們的目標寫得很明確。
原話第一條:「我們不打算發佈會拓展 cyber 能力絕對前沿的開源權重。」
注意這個措辭——「絕對前沿」。不是「不發佈有攻擊能力的模型」,是「不發佈那個把行業天花板往上頂的模型」。
這兩條線的差別巨大。前者等於自廢武功,後者只是不當出頭鳥。
第三,他們同時承諾了相反方向的事。
原話第二條:「我們打算逐步提高開源權重裏可用的 cyber 能力。」
第三條解釋了理由:讓需要雙用途能力的人能用於防禦。一個能力強的模型開源、跑在用戶自己控制的基礎設施上,能讓更多團隊去審計自己維護的代碼——包括那些幾乎從沒做過專門安全評審的遺留系統。
這段話不是公關辭令。遺留系統的安全債,是中文互聯網最真實的痛點之一。 給防守方一個能在內網自跑的審計工具,收益是實打實的。
所以這不是「閹割」,是「限速」。 方向還是往前,只是踩了一腳剎車。
六、真正該擔心的不是能力被刪,是三件事
如果我是安全從業者,看完這份公告,我擔心的不是「模型變笨了」。
我擔心的是這三件事:
① 掐尖效應。
開源模型的能力上限,會長期被壓在「當前前沿閉源模型三個月前的水平」之下。
官方原話:「K3.1 Pro 的 cyber 能力仍然落後於那些已經公開可用至少三個月的前沿閉源模型。」
這個「至少三個月」不是隨口說的,它是刻意留出的時間差。
對防守方意味着什麼?意味着你能拿到的最強開源工具,永遠比攻擊者能用錢買到的最強工具慢三個月。
這個差距不會因爲某一家廠商的選擇而消失,它就是這個階段的常態。
② 數據來源的透明性崩塌。
這次公告最有價值的部分,其實不是那個 81.0,而是它承認了 cyber 能力來自「通用語料的自然副產物」。
翻譯:你想訓一個會打漏洞的模型,不需要專門喂攻防數據,喂夠多的代碼和系統知識,它自己就會了。
這意味着「移除數據」這條路,長期看是逆着物理規律在走。你刪掉顯式的攻防語料,通用代碼能力照樣會外溢到攻擊能力上——榜單裏 81.0 這個數字本身就是證據。
③ 基準和現實的裂縫會越來越大。
廠商會持續迭代內部基準(官方明說要「keep evolving our internal benchmarks」),因爲現有基準一旦被刷滿就失去區分度。
但基準越精細,離真實場景就越遠。真實的滲透沒有「一句 bug 提示」,沒有「對應的二進制」,沒有「取回 secret string 就判分」。
所以基準分數會越來越高,而「能替你幹完一個真實項目」的模型,出現得會比你預期的晚。
七、回到那個問題:滲透測試工程師會隕落嗎
不會。但工作內容會重新分配,而且已經在發生了。
我的判斷分三檔:
會被替掉的:
- 給定漏洞信息後寫 PoC / exploit
- 大批量代碼的靜態審計第一遍
- 重複性的配置覈查、基線檢查
- 報告裏那些「複製粘貼改個客戶名」的部分
不會被替掉的:
- 判斷「這個系統最值得打哪裏」——這需要業務理解和取捨
- 在資產清單本身是錯的情況下,重新建立資產認知
- 跟甲方溝通「這個風險你到底要不要修」——這是政治,不是技術
- 承擔責任。出了事,簽字的是人。
會被放大的:
- 一個人 + 一堆 agent,能覆蓋過去一個團隊的廣度
- 關鍵是你能不能把 agent 的產出驗證掉。驗證能力,會變成新的核心技能。
所以「天才滲透測試工程師將隕落」這個說法,真正的問題不在預測,在於它把滲透測試理解成了「寫 exploit」。
那個理解,在 AI 出現之前就已經過時了。
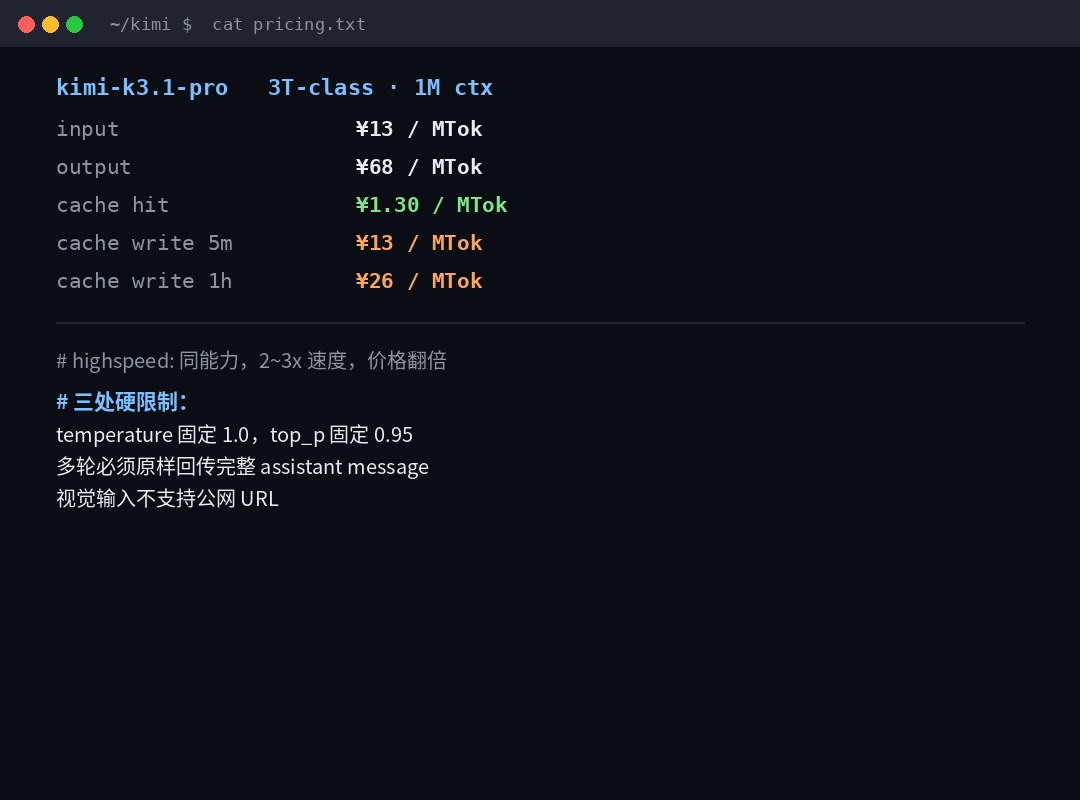
八、順手把這模型的真實參數給你
既然是聊這個模型,幾個實際用得上的數字一併列出來:
| 項目 | Kimi K3.1 Pro |
|---|---|
| 參數 | 3 萬億級(上一代 K3 是 2.8T) |
| 上下文 | 1M(1,048,576 tokens) |
| 輸入價 | ¥13 / 百萬 token |
| 輸出價 | ¥68 / 百萬 token |
| 緩存命中 | ¥1.30 / 百萬 token |
| 緩存寫入 5 分鐘 | ¥13 / 百萬 token |
| 緩存寫入 1 小時 | ¥26 / 百萬 token |
| 高速版 | 同能力,2~3 倍速度,價格翻倍(¥26 / ¥136) |
| 權重發布 | 11 月 4 日前 |
順手算一筆:輸出價是輸入價的 5.2 倍,緩存命中是輸入價的 1/10。這是標準的「長上下文 + 緩存優先」定價結構——你的 system prompt 越長、越穩定,省錢空間越大。
還有三處硬限制,踩過的人會疼:
temperature固定1.0、top_p固定0.95,傳別的值會報錯- 多輪對話必須原樣回傳完整的 assistant message,包括
reasoning_content。漏了就開始胡說 - 視覺輸入不支持公網圖片 URL,只能 base64 或
ms://
最後一條我猜很多人會踩:你把一個圖片鏈接丟給它,它不會去下載,直接報錯。
最後
這次公告裏,我認爲最值得記住的不是 81.0,也不是 90.5。
是那句話:「我們打算逐步提高開源權重裏可用的 cyber 能力。」
因爲這句話承認了一個前提——能力是可以被調節的,而不是隻能被放開或封死。
過去兩年,行業在這件事上只有兩個姿勢:要麼全開,要麼全拒。Kimi 這次給出了第三個姿勢:開,但限速,並且公開說明限了多少。
你可以不同意這個速度。但至少它把刻度盤擺在了檯面上,還告訴了你刻度在哪。
比那些一句話不說、悄悄在 RLHF 里加一層拒絕的廠商,誠實得多。
至於「天才滲透測試工程師」——他們不會隕落。
會隕落的,是那些過去十年裏只會「照着掃描器報告改 payload」的人。這件事在 AI 出現之前就已經在發生了,AI 只是把時間表提前了兩年。