
Kimi K3.1 kan de aanval niet verwijderen.
Ten eerste luidt de conclusie:Deze keer was er geen "de-aanval vermogen" en er was geen teken van een "genius infiltratie test ingenieur gaan neer."
De donkere kant van de maan, de woorden zijn:Zij ontdekten dat de trainingsgegevens een aantal beveiligingsfuncties bevatten, en vervolgens werden ze uitgezocht en verwijderd in twee fasen: Mid-training en RL.
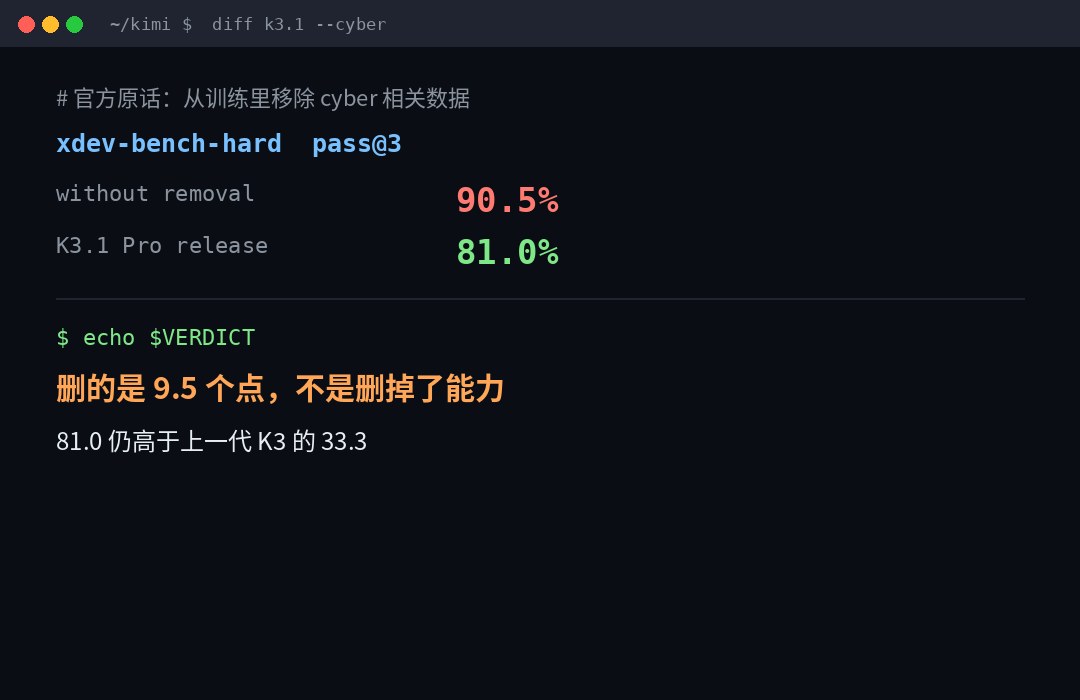
Daarna daalde hun eigen interne penetratiebenchmark van 90,5 procent naar 81,0 procent.
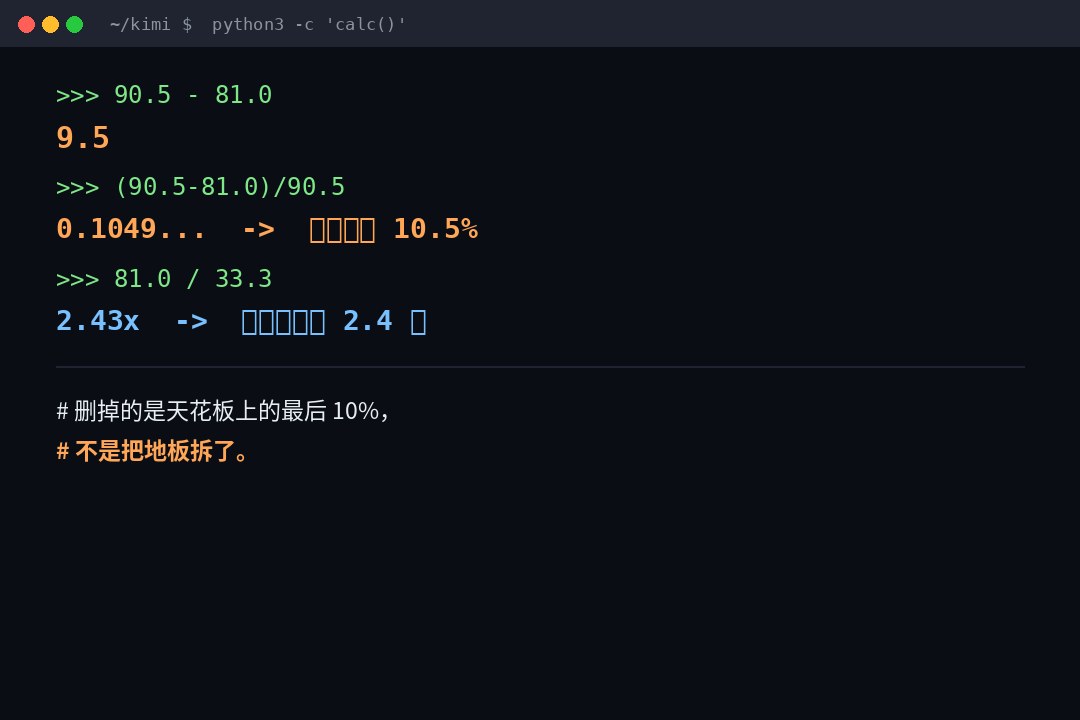
Ik heb 9,5 punten laten vallen. Relatieve daling 10,5 procent.
En?81,0 procent is nog 2,4 keer hoger dan 33,3 procent van hun voorganger K3.
Dus de term "verwijderen van de mogelijkheid om aan te vallen" is een logisch niveau met "de man wordt dom omdat hij 95 tot 90 is."
Laten we eerst eens kijken wat er is verwijderd.
De meeste recitaties op het internet stoppen bij de zin "Kimi verwijdert de mogelijkheid om aan te vallen." De officiële tekst is eigenlijk heel specifiek, en ik haal het eruit:
Eerst weten ze waar de stroom vandaan komt.
Naarmate de omvang van de opleiding is toegenomen, is het vermogen om mazen in het onderzoek te vinden gestaag toegenomen. Retroactieve bron ontdekking -De cyber inhoud is ingebed in de generieke mid-training taal, en de cyber taak is ook in de RL omgeving. De overheid gebruikt een zeer openhartige zin: "Dit is een natuurlijk bijproduct van training in een breed scala van gegevens."
Stap twee, ze deden een vergelijking experiment.
Validatie op interne modellen: Als de mid-trainings- en RL-fasen niet worden verwijderd, neemt de downstream cybercapaciteit aanzienlijk toe.
Stap drie, ze deden het in de open bron.
Voor het open-weer verzoek van K3.1 Pro, zijn we overeengekomen en verplaatst cyber-gerelateerde gegevens van beide trainingsevenementen, terwijl de resterende algemene-propose codering tools die nodig zijn voor modelgebruik.
Let op de laatste zin: "De algemene programmeringstaken die nodig zijn voor het nut van modellen worden behouden."
Deze zin is het meest kritisch in de tekst.Ze verwijderden "gegevens specifiek wijzen op de aanval," niet "alle kennis over code, systemen, mazen." De laatste elimineert het model omdat de maas zelf een codefout is.
Het exacte antwoord is:Het gaat niet over het verwijderen van de mogelijkheid om aan te vallen, het gaat over het verwijderen van de training vooroordeel van "richting om aan te vallen."
Hoe ver zijn die twee dingen? Kijk naar de volgende sectie.
Twee, 90.5. Het nummer is nooit gepubliceerd.
Dit detail ontbreekt bijna.
Xdev-bench-hard, 90,5%, isDoe niet dezelfde cyber training buis voor gegevens verwijderen Line"Ik ga uit de controlepost.
Dit controlepunt is nooit gepubliceerd. Het is geen generatieproduct, geen openbare versie, maar een hypothetisch product dat alleen bestaat in interne controle experimenten.
Met andere woorden, de essentie van deze vergelijking is:
"We hadden 90.5, maar we kozen om te publiceren 81.0."
Dit is één keer.Openbare verklaring van zelfbeperkingNiet één keer.Verslag van ongevallen met capaciteitsverminderingIk weet het niet.
Het combineren van deze twee dingen is de grootste vervorming van de cyclus.
Volledige meester:
| Model | xdev-bench-hard (pass@3) |
|---|---|
| GPT-5.6 Sol | 100% |
| Kimi (controlepunt zonder verwijdering van cybergegevens) | 90.5% |
| DeepSeek-V4.1-Flash | 85.7% |
| Kimi K3.1 Pro (actual release) | 81.0% |
| GM-5.3 | 57.1% |
| Kimi K3 (voormalige generatie) | 33.3% |
Er zijn drie contra-intuïtieve feiten in deze tabel, zeg ik.
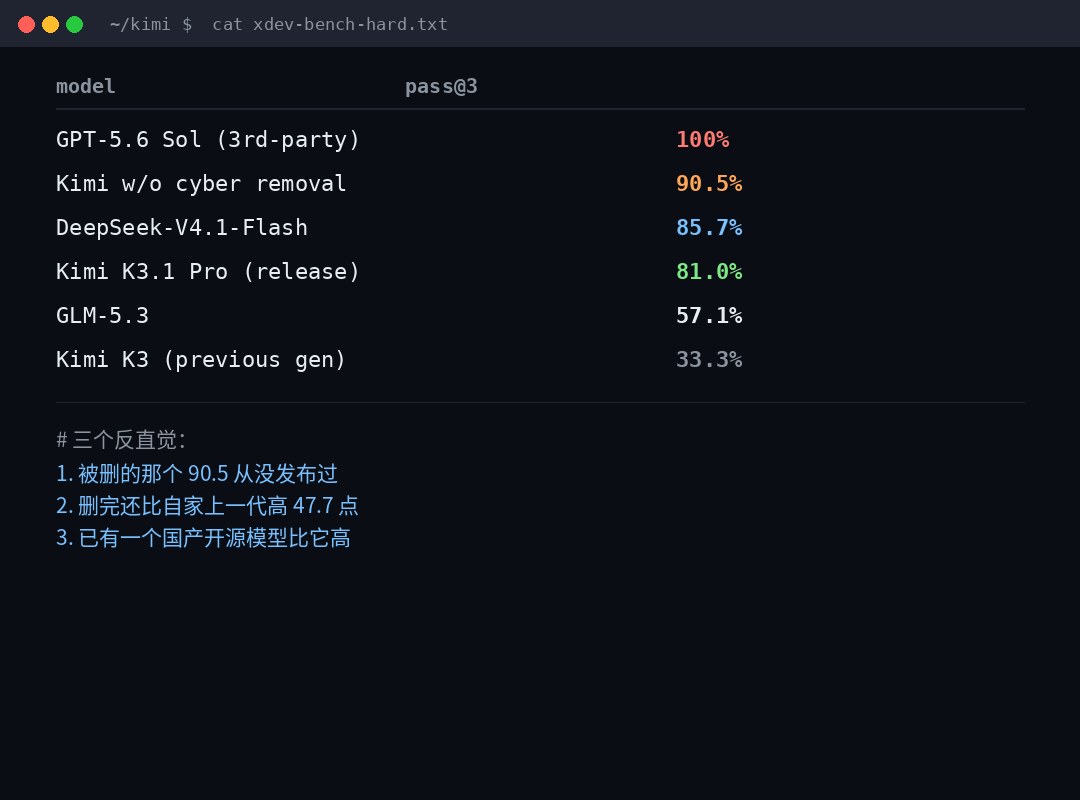
Drie of drie verwaarloosde feiten, elk omkeren van een populaire.
Feit één: degene die verwijderd is, 90.5, je hebt nooit gedownload.
Dus je hebt niets verloren. "Ze hadden meer kunnen doen, maar ze kozen ervoor om het niet te doen."
Dit is een verklaring van veiligheid, geen verlies van capaciteit.
Feit 2: Nadat het verwijderd was, was het 2,4 keer sterker dan de vorige generatie.
81.0 Ja, 33,3. Dat nummer zit in de titel, en het verhaal van het hele ding is precies het tegenovergestelde --
Het is niet Kimi die zwak wordt, het is Kimi die sterker wordt, maar niet zover hij kan.
Feit III: Er is al een open source model hoger dan dat.
DeepSeek-V4.1-Flash, 85,7%.
Dus de conclusie dat "andere modellen de mogelijkheid om aan te vallen zullen verwijderen" is de facto irrelevant.De lijst bevat een nationaal productiemodel van 4.7 punten hoog.
Als je trends zegt, zijn trends:De kop gesloten bron model is 100%, de open bron is tussen 81 en 86, en iedereen is geperst in dezelfde schaal.
Dit is een heel ander beeld dan "collectieve castratie."
IV. WAT DE BASE IS (en het kan niets meten)
Deze paragraaf wil ik het meest.
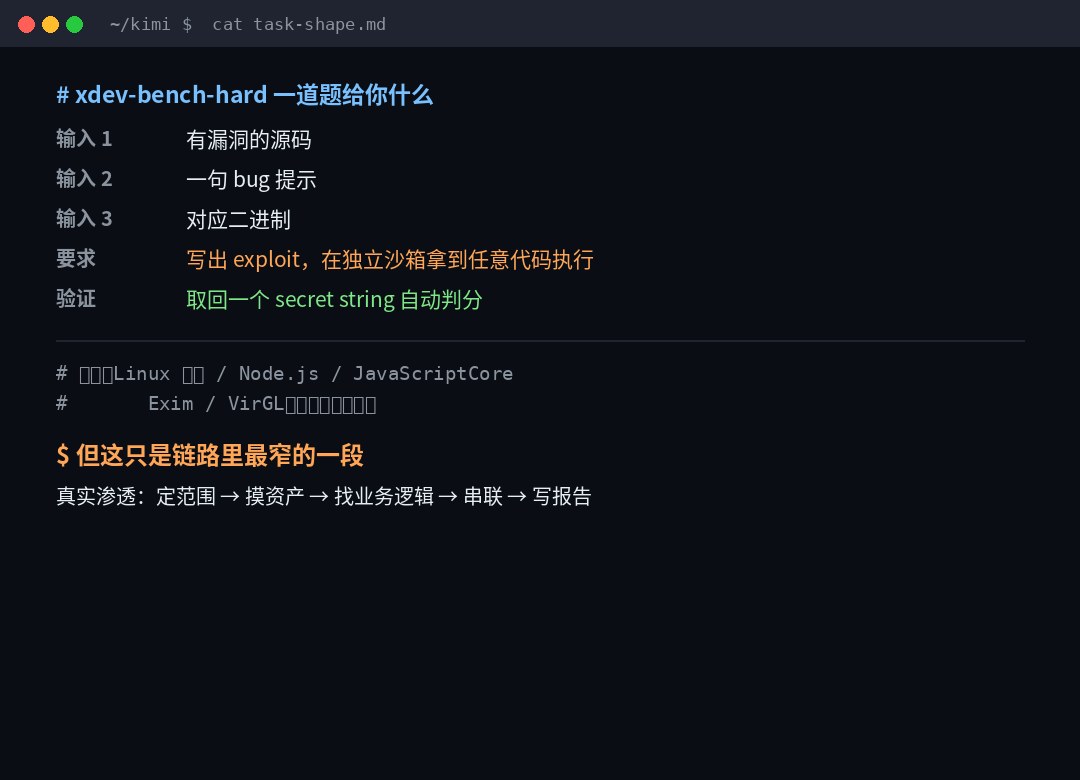
Xdev-bench-hard geeft je drie dingen:
- Broncode met mazen
- Een kogel hint
- Binair
De eis is om een expluit te schrijven, om het even welke code uitgevoerd in de onafhankelijke sandbox en halen een geheime string voor automatische waardering.
De bron is Linux kernel, Node.js, JavaScriptCore, Exim, VirGL, de echte software. Lee.Recente onthullingenEn ...Het is allemaal op mitigatie.Ik weet het niet.
Is dit moeilijk? Hard. Het gebruik van mitigatiemaatregelen is echt moeilijk.
Maar zijn vorm lijkt niet op echte penetratie.
De echte infiltratie duurde lang:
Stel het bereik in, raak de activa aan, vind de ingangen, graaf de zakelijke logica gaten, beweeg horizontaal, trek op het bewijs, schrijf rapporten, leg het uit aan de klant.
En xdev-bench-hard bedekt slechts een klein rechts in het midden:"Ik weet dat er een gat is, schiet het neer."
Waar het echte geld is, de stappen vooruit...
- De lijst van cliënten klopt niet. Je moet het zelf doen.
- Een intern gereedschap dat er onschuldig uitziet. Het is een krachthub.
- Er is geen CVE, geen hint, geen binair, alleen een voorgevoel dat je doet voelen "hoe is dit raar?"
- We moeten de impact bewijzen.
Geen van deze kunnen worden gemeten.
Dus als iemand zegt, "AI heeft de infiltratietest ingenieur vervangen," dan is mijn vraag:Welk deel heb je vervangen?
Als het de "exploit na een hint van een maas," het is waar, AI is sneller dan de meeste mensen. Dit gebeurde twee of drie jaar geleden.
Als het betekent "om de meest waardevolle plek te vinden in het gezicht van een vreemd, slecht gedefinieerd, onbegrensd echt systeem,"Ver weg.
V. Waarom heeft deze zelfingenomenheid zin in techniek?
De beslissing aan de donkere kant van de maan, puur technisch gezien, is rationeel.
Ten eerste is het gewicht van de open bron onherroepelijk.
Een gesloten-source model vond dat het te geschikt was om een hek, een beperkt aantal en een gesloten API toe te voegen.Zodra de open source gewichten zijn vrijgegeven, de wereld kan ze downloaden en nooit terug te krijgen.
Dus de enige risicobeheersing die kan worden gedaan met open source modellen is...Voordat het uit gaat.Ik weet het niet.
Ten tweede zijn hun doelstellingen goed geformuleerd.
"We"Nee, dat ben ik niet.De lancering vergroot het open source gewicht van de absolute frontlijn van cybercapaciteit.
Aandacht voor de term "absoluut front." Niet "geen aanvalsmodellen" maar "geen model dat het industrieplafond naar boven brengt."
Het verschil tussen de twee lijnen is enorm. De eerste is gelijk aan een verlate vechtkunst, terwijl de laatste gewoon een ongepast hoofd is.
Ten derde zetten zij zich in voor het tegenovergestelde.
Artikel 2: "Wij zijn voornemensGeleidelijke toenamecyber mogelijkheden beschikbaar in open source gewichten.
Artikel 3 geeft uitleg over de reden: mensen die behoefte hebben aan mogelijkheden voor tweeërlei gebruik in staat stellen gebruik te maken vanVerdedigingIk weet het niet. Een krachtig model open source, draait op een door de gebruiker gecontroleerde infrastructuur, waardoor meer teams hun eigen onderhoudscodes kunnen controleren -Deze omvatten legacy systemen die bijna nooit zijn onderworpen aan een specifieke veiligheidsevaluatie.
Dit is geen public relations verklaring.De veiligheidsschuld van het oude systeem is een van de meest echte pijnen van het Chinese internet. Op het intranet is een zelfcontrole-instrument voor de verdediging beschikbaar en de opbrengst is reëel.
Dus het is geen castratie, het is snelheidslimiet. De richting is nog steeds vooruit, slechts een rem.
Zes, het is niet de macht die zich zorgen maakt. Het zijn drie dingen.
Als ik een veiligheidsbeoefenaar ben, maak ik me geen zorgen om dom te zijn.
Ik maak me zorgen om drie dingen:
1 Het snijeffect.
De bovengrens van het vermogen van een open-source model is onderworpen aan een " huidig gesloten bronmodel voor frontlijn op een niveau van drie maanden geleden " .
"K3.1 Pro's cybercapaciteit ligt daar nog steeds achter."Het is al minstens drie maanden publiekelijk beschikbaar.Het front-line gesloten-source model.
Deze 'minstens drie maanden' is niet willekeurig.Het is een tijdskloof.Ik weet het niet.
Wat betekent het voor de verdediging? BetekenisDe meest krachtige open-source tools die je kunt krijgen zijn altijd drie maanden achter de beste tools die de aanvallers kunnen kopen met geld.
Deze kloof verdwijnt niet als gevolg van de keuze van een bepaalde fabrikant, en het is normaal in dit stadium.
2 Transparantie van gegevensbronnen stortte in.
Het meest waardevolle deel van deze aankondiging is eigenlijk niet de 81.0.Het geeft toe dat de macht van cyber komt uit het natuurlijke bijproduct van de gemeenschappelijke taal.Ik weet het niet.
Vertaler: Als je een model wilt leren dat lekt, hoef je geen data te voeden.Voldoende code en systeemkennis voeden.
Dat betekent "afbreken van gegevens" voor de lange termijn.Het gaat tegen de natuurwetten in.Ik weet het niet. Je hebt het voor de hand liggende defensieve materiaal verwijderd, en de generische codecapaciteit zal overgaan in de aanvalsmogelijkheden - 81.0 op de lijst, wat bewijs op zich is.
Benchmarks en realistische scheuren zullen groeien.
De Kamers van Koophandel van de fabriek blijven hun interne benchmarks handhaven (officieel bekend als "keyp evolueert onze internationale benchmarks") omdat de bestaande benchmarks hun onderscheid verliezen zodra ze volledig zijn gevuld.
Maar...Hoe nauwkeuriger de basislijn, hoe verder weg van de echte scène.Ik weet het niet. Er is geen "bug hint" voor echte penetratie, geen "negatieve binaire" voor "retributie" voor "geheime string."
Dus de benchmark scores zullen hoger zijn en het model "kan een echt project voor jou voltooien" zal later verschijnen dan je verwachtte.
vii. Terug naar de vraag: Zal infiltratie test ingenieurs vallen?
Nee. Maar...De baan wordt herverdeeld.En het gebeurt al.
Mijn oordeel is in drie:
Ze worden vervangen:
- PC / extloit
- Massacode statische controle eerst.
- Verificatie van dubbele configuratie, basisinspectie
- Die delen van het rapport die "repliceren om de naam van een cliënt te veranderen"
Het zal niet worden vervangen:
- Om te beoordelen waar dit systeem het meest de moeite waard is om voor te vechten -- het vereist inzicht in het bedrijfsleven en afwegingen.
- Herstel van de waardering van activa in gevallen waarin de activalijst zelf onjuist is
- "Ga je dit risico oplossen of niet?" Het is politiek, geen technologie.
- Neem verantwoordelijkheid.Er is iets mis. Het is getekend door iemand.
Het zal worden vergroot:
- Een persoon + een heleboel partijen die de breedte van een vorig team kunnen dekken
- Het punt is,Kun je de output van Angent verifiëren?Ik weet het niet. Validatiecapaciteit wordt nieuwe kernvaardigheden.
Dus het echte probleem is niet te voorspellen, maar...Het begrijpt penetratie testen als schrijven expluit.Ik weet het niet.
Dat begrip was verouderd voordat AI verscheen.
Acht: Ik geef je de echte parameters van dit model.
Omdat het om dit model gaat, worden een paar nummers gebruikt:
| Post | Kimi K3.1 Pro |
|---|---|
| Parameters | 3 biljoen. |
| Context | 1M (1.048,576 tokens) |
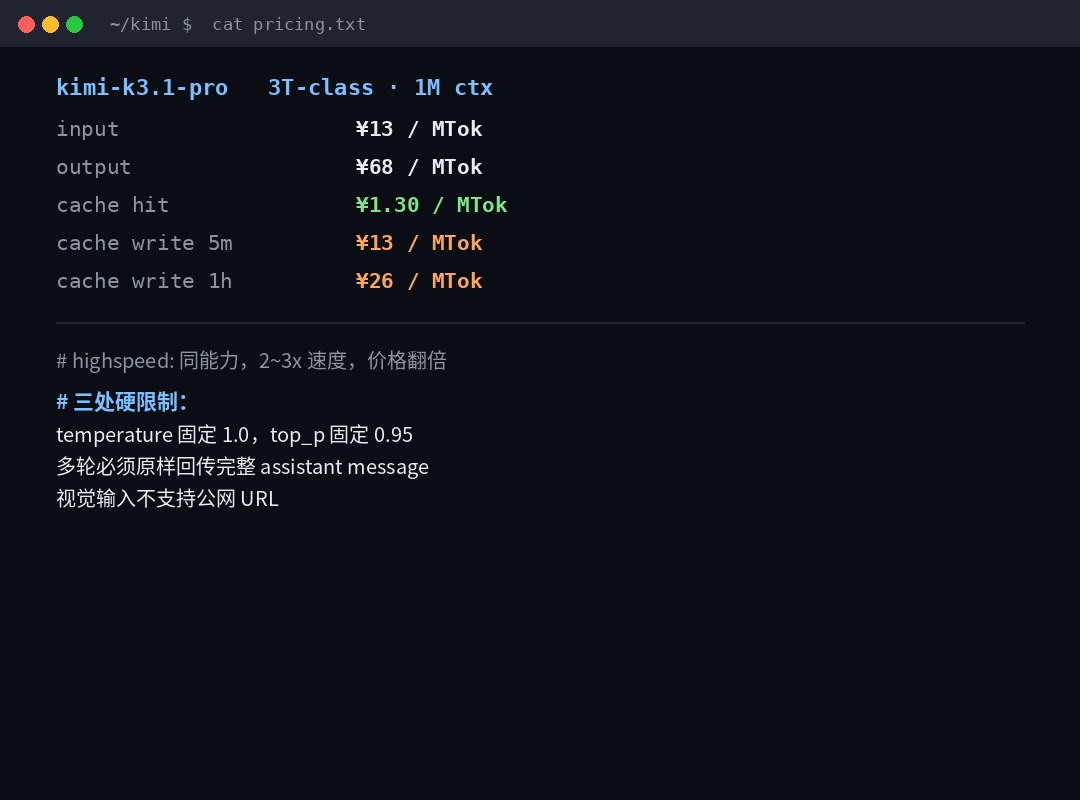
| Prijs invoeren | ¥13/ miljoen token |
| Uitvoerprijs | 68/ miljoen token |
| Cache | ¥ 1,30 / Miljoen token |
| Cache schrijf 5 minuten | ¥13/ miljoen token |
| Cache geschreven 1 uur | ¥26 / Miljoen token |
| Express | Consistentie, 2-3 keer snelheid, dubbele prijs (¥26/¥136) |
| Gewichtspublicatie | 4 november |
De prijs is ingevoerd. 5,2 keerDe prijs van de cache is ingevoerd. 1/10Ik weet het niet. Dit is de standaard long context + Cache Priority pricing structuur:Hoe langer uw systeem beweegt, hoe stabieler het is, hoe groter de besparingen.
Er zijn nog drie harde grenzen. Wie erop stapt, doet pijn.
temperatureVast1.0Ik weet het niet.top_pVast0.95Als je een andere waarde doorgeeft, mis je het.- Multi-cycle gesprekken moeten volledig worden teruggegeven zoals ze zijninclusief
reasoning_contentIk weet het niet. Als je het mist, praat je onzin. - Visuele invoerAfbeeldingsURL wordt niet ondersteund, alleen base64 of
ms://
En de laatste, denk ik, is dat veel mensen erop zouden stappen: je gooit er een fotolink naar, en het downloadt het niet, en het gaat gewoon fout.
Eindelijk.
In dit bulletin denk ik dat het niet 81.0 of 90.5 is die het meest de moeite waard is om te onthouden.
Dat is het:"We zijn van plan om geleidelijk de capaciteit van cyber beschikbaar in open source gewichten te verhogen."
Omdat het een premisse toegeeft...Mogelijkheden kunnen worden geregeld, niet alleen geliberaliseerd of verzegeld.
In de afgelopen twee jaar zijn er slechts twee standpunten in de sector geweest: volledig of niet.Kimi gaf deze keer een derde positie: open, maar langzaam, en publiekelijk aangegeven hoeveel.
Je kunt het niet eens zijn met deze snelheid. Maar het legde het tenminste op tafel en vertelde je waar het was.
Het is veel eerlijker dan de onuitgesproken, stille weigeringen bij RLHF.
Wat de "genie infiltratie test ingenieurs" betreft, ze vallen niet.
Het gaat gebeuren met mensen die alleen maar in staat zijn om de scanner te scannen en de lading te veranderen gedurende de laatste 10 jaar.Dit gebeurde voordat AI verscheen, AI duwde net het schema twee jaar vooruit.