
Kimi K3.1 non ha la capacità di rimuovere l'attacco.
Innanzitutto, la conclusione è che:Questa volta non c'era una "capacità di attacco" e non c'era traccia di un "genio ingegnere di prova di infiltrazione che scendeva."
Il lato oscuro della luna, le parole sono:Hanno scoperto che i dati di formazione incorporavano una serie di caratteristiche di sicurezza, e poi sono stati raccolti e cancellati in due fasi: Mid-training e RL.
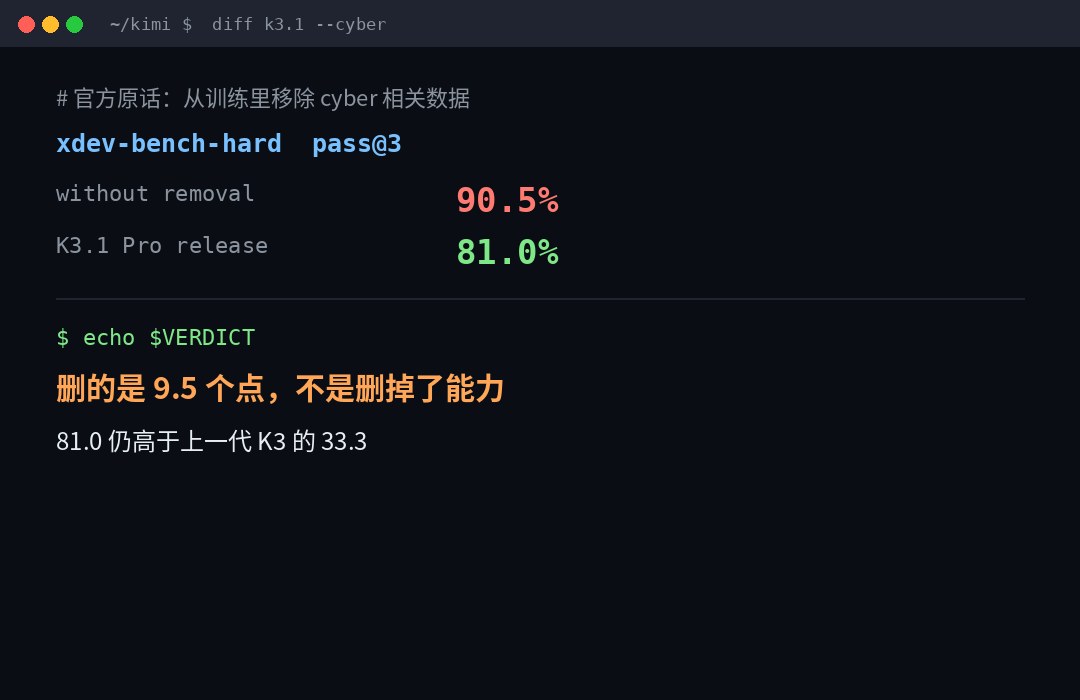
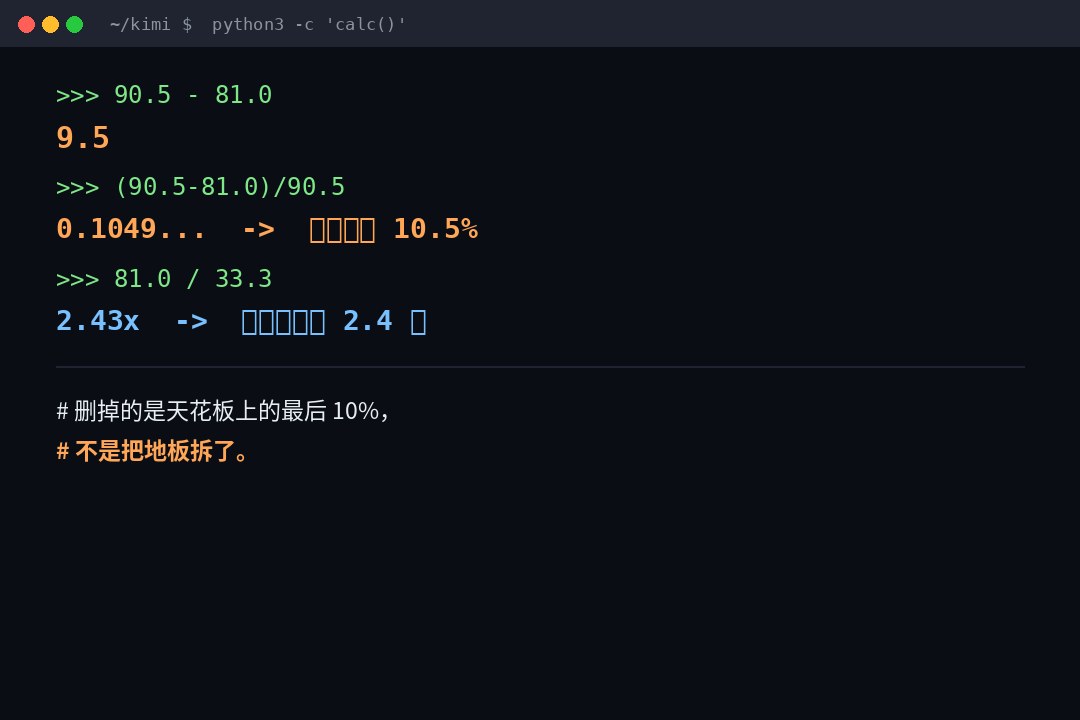
Dopo di che, il proprio benchmark di penetrazione interna è sceso dal 90,5 per cento all'81.0 per cento.
E' caduto 9,5 punti. Riduzione relativa 10,5 per cento.
E?L'8,0 per cento è ancora 2.4 volte superiore al 33,3 per cento del loro predecessore K3.
Quindi il termine "rimuovere la capacità di attaccare" è un livello logico con "l'uomo diventa stupido perché è giù 95 a 90".
In primo luogo, vediamo cosa è stato cancellato.
La maggior parte delle recitazioni su Internet si ferma alla frase "Kimi rimuove la capacità di attaccare". Il testo ufficiale è in realtà molto specifico, e lo abbandonerò:
In primo luogo, scoprono da dove viene il potere.
Poiché l'entità della formazione si è ampliata, la capacità di ricerca delle scappatoie è costantemente aumentata. Riscoperta di sorgenti rettive -Il contenuto informatico è incorporato nel linguaggio generico di media formazione, e il compito informatico è anche nell'ambiente RL. Il governo usa una frase molto franca: "Questo è un sottoprodotto naturale della formazione in una vasta gamma di dati."
Il secondo passo, hanno fatto un esperimento di confronto.
Validazione sui modelli interni: Se le fasi intermedie e RL non vengono rimosse, la capacità informatica a valle aumenta significativamente.
Terzo passo, l'hanno fatto nella fonte aperta.
Per la richiesta open-weather di K3.1 Pro, abbiamo concordato e spostato i dati relativi al cyber da entrambi gli eventi di formazione, rimanendo gli strumenti di codifica generici necessari per l'uso del modello.
Notare l'ultima frase, "I compiti di programmazione generici richiesti per l'utilità dei modelli sono mantenuti".
Questa frase è la più critica nel testo.Hanno cancellato "dati specificatamente puntando all'attacco", non "tutte le conoscenze su codice, sistemi, scappatoie". Quest'ultimo elimina il modello perché la scappatoia stessa è un difetto di codice.
Quindi la risposta esatta è:Non si tratta di rimuovere la capacità di attaccare, si tratta di rimuovere il bias di allenamento di "direzione per attaccare".
Quanto distano queste due cose? Guarda la sezione successiva.
Due, 90,5. E' un numero mai pubblicato.
Questo dettaglio è quasi scomparso.
Xdev-bench-hard, 90,5%, èNon fare lo stesso tubo di formazione informatica per la rimozione dei dati Linea"Sto uscendo dal posto di blocco.
Questo checkpoint non è mai stato pubblicato. Non è un prodotto di generazione, non una versione pubblica, ma un prodotto ipotetico che esiste solo negli esperimenti di controllo interno.
In altre parole, l'essenza di questo confronto è:
"Avremmo potuto fare 90.5, ma abbiamo scelto di pubblicare 81.0."
E' una volta.Dichiarazione pubblica di autodisciplinaNon una volta.Relazione sugli incidenti di degrado della capacitàNon lo so.
Combinare queste due cose è la più grande distorsione del ciclo.
Maestro completo:
| Modello | xdev-bench-hard (pass@3) |
|---|---|
| GPT-5.6 Sol | 100% |
| Kimi (checkpoint senza rimozione dei dati informatici) | 90.5% |
| DeepSeek-V4.1-Flash | 85.7% |
| Kimi K3.1 Pro (rilascio effettivo) | 81.0% |
| GM-5.3 | 57.1% |
| Kimi K3 (ex generazione) | 33.3% |
Ci sono tre fatti controintuitivi in questa tabella, dico.
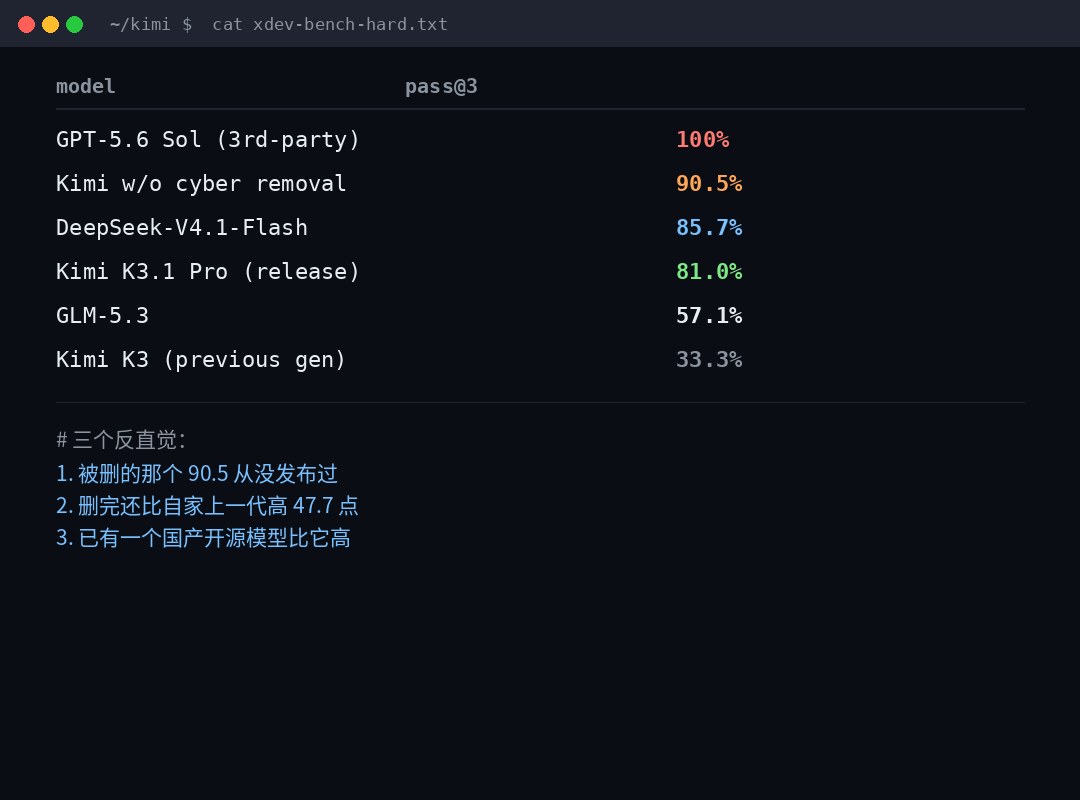
Tre o tre fatti trascurati, ciascuno invertendo uno popolare.
Fatto uno: Quello che è stato cancellato, 90.5, non hai mai scaricato.
Quindi non hai perso niente. Sai, "avrebbero potuto fare di più, ma hanno scelto di non farlo".
Questa è una dichiarazione di sicurezza, non una perdita di capacità.
Fact 2: Dopo che è stato cancellato, è stato 2.4 volte più forte della generazione precedente.
81.0 Sì, 33.3. Quel numero è nel titolo, e la narrazione dell'intera cosa è esattamente l'opposto --
Non e' Kimi che si indebolisce, e' Kimi che diventa piu' forte, ma non al punto in cui puo'.
Fact III: C'è già un modello open source più alto di quello.
DeepSeek-V4.1-Flash, 85.7 per cento.
Quindi l'inferenza che "altri modelli rimuoveranno la capacità di attaccare" è di fatto irrilevante.La lista contiene un modello di produzione nazionale di 4,7 punti.
Se si dice tendenze, le tendenze sono:Il modello di sorgente chiuso testa è 100%, la fonte aperta è tra 81 e 86, e tutti sono spremuti nella stessa scala.
Si tratta di un'immagine completamente diversa dalla "catarazione collettiva".
IV. Che cosa è il BASE (e non può misurare nulla)
Questo paragrafo è quello che voglio di più.
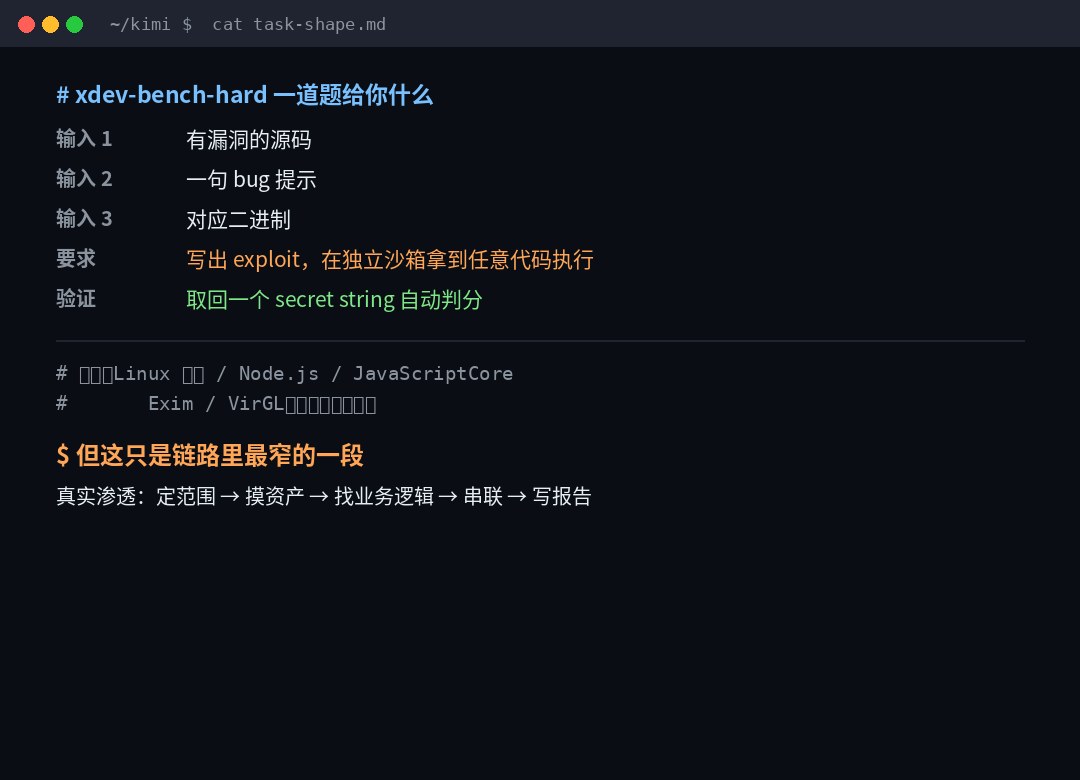
Xdev-bench-hard vi dà tre cose:
- Codice sorgente con scappatoie
- Un suggerimento di proiettile
- Corrispondenza Binary
Il requisito è quello di scrivere un expluit, ottenere qualsiasi codice eseguito nella sandbox indipendente e recuperare una stringa segreta per la valutazione automatica.
La fonte è Linux kernel, Node.js, JavaScriptCore, Exim, VirGL, il vero software. Lee.Rivelazioni recentiE...E' tutto sulla mitigazione.Non lo so.
E' difficile? Difficile. L'uso di misure di mitigazione è davvero difficile.
Ma la sua forma non è niente come una vera penetrazione.
La vera infiltrazione ha richiesto molto tempo:
Impostare la portata, toccare i beni, trovare gli ingressi, scavare le lacune di logica aziendale, muoversi orizzontalmente, disegnare le prove, scrivere report, spiegare al cliente.
E xdev-bench-hard copre solo una piccola destra al centro:"So che c'è un buco qui dentro, sparate giù."
Dove sono i soldi veri, i passi avanti...
- La lista patrimoniale del cliente e' sbagliata. Devi farlo da solo.
- Uno strumento interno che sembra innocuo. E' un hub di potere.
- Non c'è CVE, nessun suggerimento, nessun binario, solo una sensazione che ti fa sentire "come sta questo strano?"
- Dovremo dimostrare l'impatto.
Nessuno di questi può essere misurato.
Quindi, quando qualcuno dice: "AI ha sostituito l'ingegnere del test di infiltrazione", la mia domanda è:Quale parte ha sostituito?
Se è l'"esplosione dopo un accenno di una scappatoia", è vero, l'intelligenza artificiale è più veloce della maggior parte delle persone. E' successo due o tre anni fa.
Se significa "trovare il punto più utile di fronte a un sistema reale strano, mal definito e senza confini",Lontano.
V. Perché questo autoabbraccio ha senso in ingegneria?
La decisione sul lato oscuro della luna, da un punto di vista puramente ingegneristico, è razionale.
In primo luogo, il peso open source è irrevocabile.
Un modello open source ha scoperto che era troppo capace per aggiungere una recinzione, un numero limitato e un API chiuso.Una volta che i pesi open source vengono rilasciati, il mondo può scaricarli e mai recuperarli.
Quindi l'unico controllo del rischio che può essere fatto con i modelli open source è...Prima che esca.Non lo so.
In secondo luogo, i loro obiettivi sono ben articolati.
"Noi"No, non lo sono.Il lancio espande il peso open source della linea frontale assoluta della capacità informatica.
Attenzione al termine "fronte assoluto". Non "no modelli attaccabili" ma "nessun modello che mette il soffitto del settore in alto."
La differenza tra le due linee è enorme. Il primo equivale a una derelizione delle arti marziali, mentre quest'ultimo è semplicemente una testa impropria.
In terzo luogo, si sono impegnati al contrario.
Articolo 2: "Noi intendiamoAumento gradualecapacità informatiche disponibili nei pesi open source.
L'articolo 3 spiega la razionalità: consentire alle persone che hanno bisogno di una doppia capacità d'usoDifesaNon lo so. Un potente modello open source, in esecuzione su un'infrastruttura controllata dall'utente, che consente a più team di controllare i propri codici di manutenzione -Questi includono sistemi legacy che non sono stati quasi mai soggetti a una specifica revisione di sicurezza.
Questa non è una dichiarazione di pubbliche relazioni.Il debito di sicurezza del sistema legacy è uno dei dolori più reali di Internet cinese. Uno strumento di controllo autogestito per la difesa è disponibile sull'Intranet, e i proventi sono reali.
Quindi non e' castrazione, e' limite di velocita'. La direzione è ancora in avanti, solo un freno.
Sei, non e' il potere che si preoccupa. Sono tre cose.
Se sono un professionista della sicurezza, non sono preoccupato di essere stupido.
Sono preoccupato per tre cose:
1 L'effetto di taglio.
Il limite superiore della capacità di un modello open source è soggetto ad un "modello sorgente chiuso anteriore-linea attuale a un livello di tre mesi fa ".
"La capacità informatica di K3.1 Pro è ancora dietro quelle."E' disponibile per almeno tre mesi.Il modello open source a prima linea.
Questo "almeno tre mesi" non è casuale.E' un gap temporale.Non lo so.
Cosa significa per la difesa? SignificatoI più potenti strumenti open-source che puoi ottenere sono sempre tre mesi dietro i migliori strumenti che gli aggressori possono acquistare con soldi.
Questo divario non scompare a causa della scelta di un particolare produttore, ed è normale in questa fase.
2 La trasparenza delle fonti di dati è crollata.
La parte più preziosa di questo annuncio non è in realtà l'81.0.Ammette che il potere del cyber proviene dal sottoprodotto naturale della lingua comune.Non lo so.
Traduttore: Si desidera insegnare un modello che sta perdendo, non è necessario alimentare i dati.Nutrire abbastanza codice e conoscenze di sistema, lo fa.
Ciò significa "smantellare dati" per il lungo termine.Sta andando contro le leggi della fisica.Non lo so. Hai cancellato l'ovvio materiale difensivo, e la capacità di codice generico si riverserà nella capacità di attacco -- 81.0 sulla lista, che è la prova in sé.
Benchmarks e crepe realistiche cresceranno.
Le camere di commercio della fabbrica continuano a mantenere i loro benchmark interni (ufficialmente noto come “keyp evolvendo i nostri benchmark internazionali”) perché i benchmark esistenti perdono la loro distinzione una volta completamente riempiti.
Ma...Più precisamente la linea di base, più lontano dalla scena reale.Non lo so. Non c'è "bug suggerimento" per la penetrazione reale, nessun "negativo binario" per "restribuzione" per " stringa segreta".
Così i punteggi di benchmark saranno più alti e il modello "può finire un vero progetto per voi" apparirà più tardi di quanto previsto.
Vii. Torna alla domanda: Gli ingegneri del test di infiltrazione cadranno?
No. Ma...Il lavoro sarà ridistribuito.E sta gia' accadendo.
Il mio giudizio è in tre:
Saranno sostituiti:
- PC / extloit
- Controllo statico del codice di massa prima.
- Verifica di configurazione duplicata, ispezione di base
- Quelle parti del rapporto che "riplicano di cambiare il nome di un cliente"
Non sarà sostituito:
- Per giudicare dove questo sistema vale la pena lottare per -- richiede la comprensione aziendale e trade-off.
- Ristabilimento del riconoscimento patrimoniale nei casi in cui la lista patrimoniale stessa è sbagliata
- "Stai per risolvere questo rischio o no?" E' politica, non tecnologia.
- Si prenda la responsabilità.Qualcosa non va. E' firmato da qualcuno.
Sarà magnificato:
- Una persona + un gruppo di partiti che possono coprire l'ampiezza di una squadra precedente
- Il punto e'...Puoi verificare l'output di angent?Non lo so. La capacità di convalida diventa nuove competenze chiave.
Quindi il vero problema non e' prevedere, ma...Comprende i test di penetrazione come expluit di scrittura.Non lo so.
Questa comprensione è stata superata prima che l'IA apparisse.
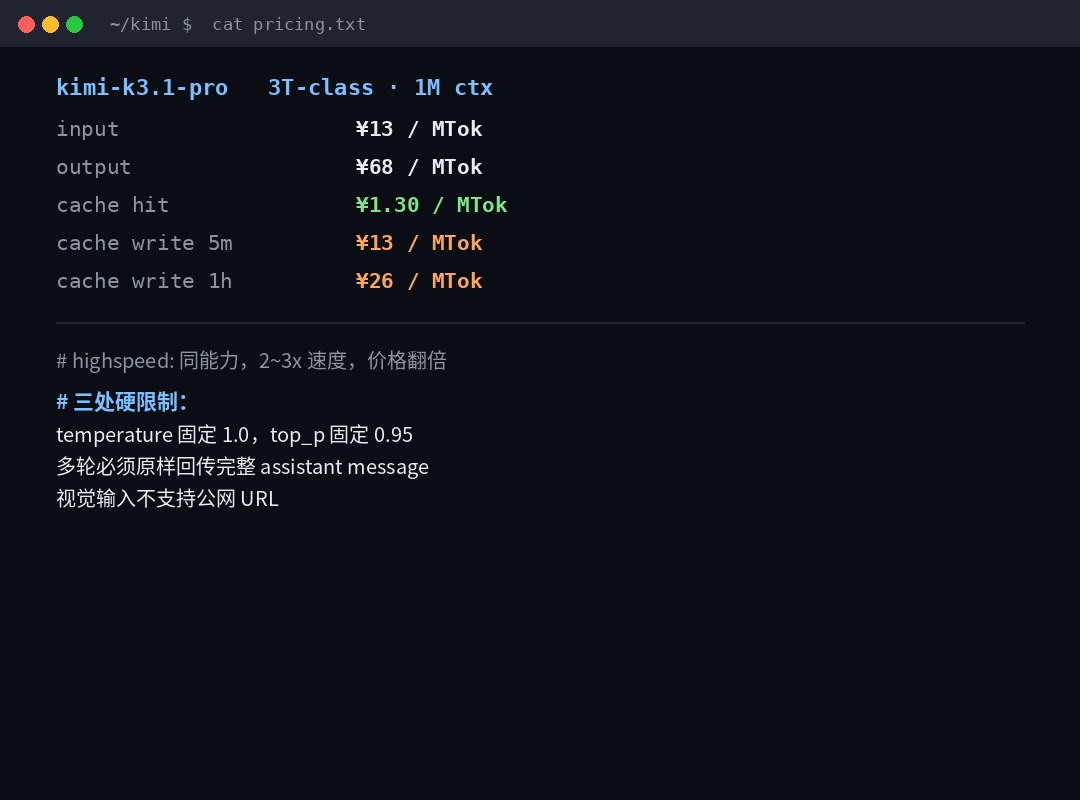
Otto: Vi darò i veri parametri di questo modello.
Poiché si tratta di questo modello, alcuni numeri sono effettivamente utilizzati:
| Articolo | Kimi K3.1 Pro |
|---|---|
| Parametri | 3 trilioni. |
| Contesto | 1M (1.048,576 gettoni) |
| Inserisci il prezzo | ¥13/ Milioni di token |
| Prezzo di uscita | 68/ milioni di tonnellate |
| Cache | ¥ 1.30 / Milioni di token |
| Cache Scrivere 5 minuti | ¥13/ Milioni di token |
| Cache scritto 1 ora | ¥26 / Milioni di token |
| Express | Consistenza, velocità 2-3 volte, doppio prezzo (¥26/¥136) |
| Pubblicazione del peso | 4 novembre |
Il prezzo è inserito. 5.2 volteIl prezzo della cache è inserito. 1/10Non lo so. Questo è il contesto lungo standard + Cache Priority struttura dei prezzi:Più il vostro sistema si muove, più stabile è, maggiore è il risparmio.
Ci sono altri tre limiti. Coloro che lo calpestano faranno male.
temperatureFisso1.0Non lo so.top_pFisso0.95Se passi un altro valore, ti mancherà.- Le conversazioni multi-ciclo devono essere restituite in pieno come sonoincluso
reasoning_contentNon lo so. Se ti manca, inizia a parlare di sciocchezze. - Ingresso visivoURL immagine non supportato, solo base64 o
ms://
E l'ultimo, credo, è che un sacco di gente si metterebbe su di esso: si getta un collegamento di foto ad esso, e non lo scarica, e va solo male.
Finalmente.
In questo bollettino, penso che non sia 81.0 o 90.5 che vale la pena ricordare.
Ecco."Abbiamo intenzione di aumentare gradualmente la capacità del cyber disponibile nei pesi open source."
Perche' ammette una premessa...Le capacità possono essere regolate, non semplicemente liberalizzate o sigillate.
Negli ultimi due anni, ci sono state solo due posizioni nell'industria su questa materia: piena o no.Kimi ha dato una terza posizione questa volta: aperto, ma lento, e pubblicamente indicato quanto.
Non puoi essere d'accordo con questa velocità. Ma almeno l'ha messo sul tavolo e ti ha detto dov'era.
E' molto piu' onesto dei rifiuti inespressi e silenziosi di RLHF.
Per quanto riguarda i geniali ingegneri del test di infiltrazione, non cadono.
Succederà a persone che sono state in grado di "scanning lo scanner e cambiare il carico utile" per gli ultimi 10 anni.Questo è successo prima che l'IA apparisse, l'AI ha appena spinto il programma due anni avanti.