
Kimi K3.1 n'a pas la capacité de retirer l'attaque.
Premièrement, la conclusion est la suivante :Cette fois, il n'y avait pas de « capacité de désattaque » et il n'y avait aucun signe d'un « ingénieur d'essai d'infiltration de génie qui descendait ».
Le côté sombre de la lune, les mots sont:Ils ont constaté que les données de formation comprenaient un certain nombre de caractéristiques de sécurité, puis ils ont été choisis et supprimés en deux étapes : la formation moyenne et la RL.
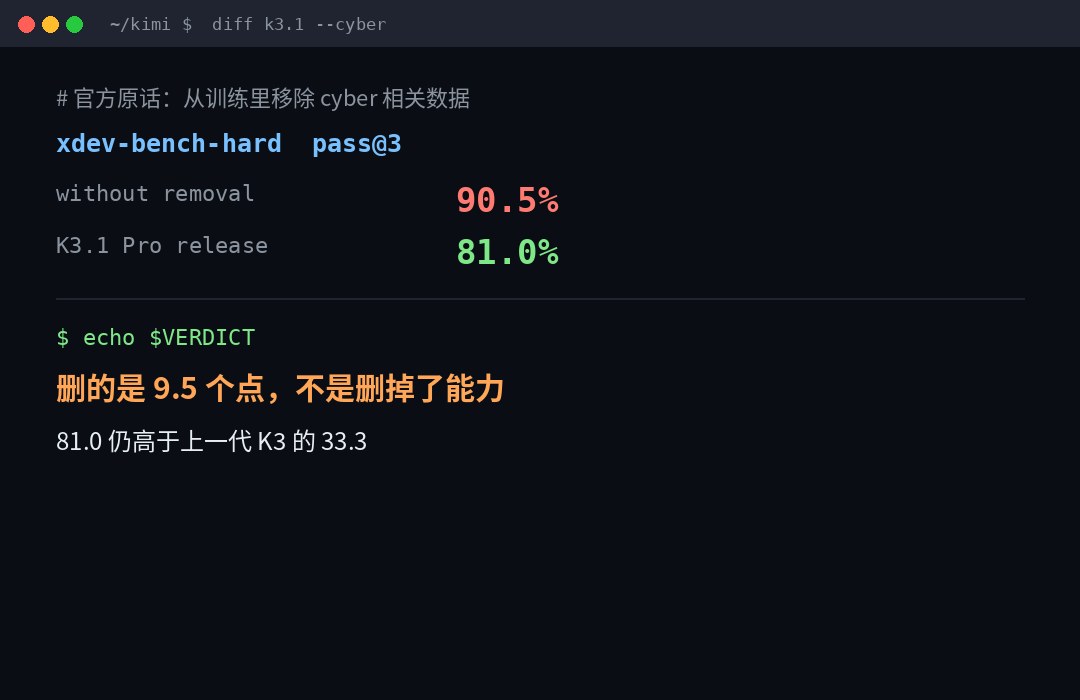
Après cela, leur propre indice de pénétration interne est passé de 90,5 % à 81,0 %.
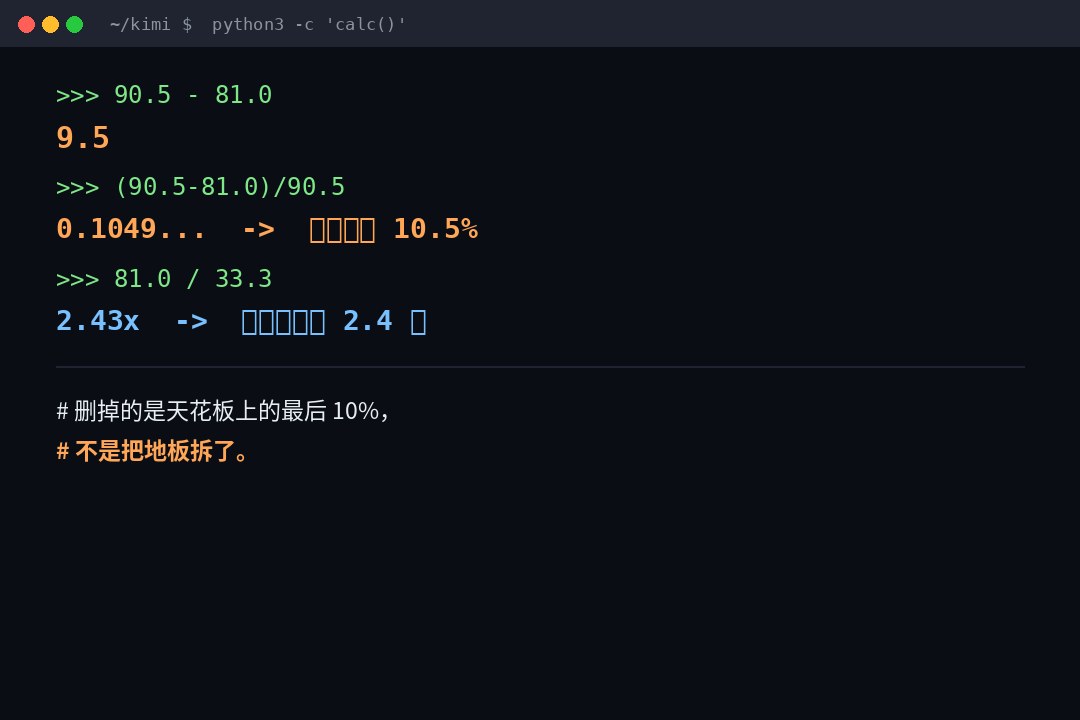
A baissé de 9,5 points. Baisse relative de 10,5 %.
Et alors ?81,0 % sont encore 2,4 fois supérieurs à 33,3 % de leur prédécesseur K3.
Donc le terme « enlever la capacité d'attaquer » est un niveau logique avec « l'homme devient stupide parce qu'il a moins de 95 à 90 ans ».
D'abord, voyons ce qui a été supprimé.
La plupart des récitations sur Internet s'arrêtent à la phrase "Kimi supprime la capacité d'attaquer." Le texte officiel est en fait très spécifique, et je vais le retirer:
D'abord, ils découvrent d'où vient le pouvoir.
Au fur et à mesure que l'ampleur de la formation s'est élargie, la capacité de recherche a constamment augmenté. Découverte rétroactive de sources -Le contenu électronique est intégré dans le langage générique de la formation moyenne, et la tâche cyber est également dans l'environnement RL. Le gouvernement utilise une phrase très franche : « C'est un sous-produit naturel de la formation dans un large éventail de données ».
Deuxième étape, ils ont fait une expérience de comparaison.
Validation sur modèles internes: Si les phases mi-formation et RL ne sont pas supprimées, la cybercapacité en aval augmente considérablement.
Troisième étape, ils l'ont fait en open source.
Pour la demande en temps libre de K3.1 Pro, nous avons accepté et déplacé les données relatives à la cyberactivité des deux événements de formation, tout en demeurant les outils de codage généraux nécessaires pour l'utilisation du modèle.
Notez la dernière phrase, « Les tâches de programmation génériques requises pour l'utilité des modèles sont conservées ».
Cette phrase est la plus critique du texte.Ils ont supprimé "données pointant spécifiquement sur l'attaque", pas "toutes les connaissances sur le code, les systèmes, les failles." Ce dernier élimine le modèle parce que la faille elle-même est un défaut de code.
La réponse exacte est donc :Il ne s'agit pas de supprimer la capacité d'attaquer, il s'agit d'éliminer le biais d'entraînement de "direction à attaquer".
Jusqu'où sont ces deux choses ? Regardez la section suivante.
Deux, 90.5. C'est un numéro jamais publié.
Ce détail manque presque.
Xdev-bench-hard, 90,5 %, estNe pas faire le même tube de cyberformation pour l'enlèvement des données Ligne"Je sors du poste de contrôle.
Ce point de contrôle n'a jamais été publié. Ce n'est pas un produit de génération, pas une version publique, mais un produit hypothétique qui n'existe que dans les expériences de contrôle interne.
En d'autres termes, l'essence de cette comparaison est :
"Nous aurions pu faire 90,5, mais nous avons choisi de publier 81,0."
C'est une fois.Déclaration publique d'autoréflexionPas une fois.Rapport sur les accidents de dégradation des capacitésJe ne sais pas.
Combiner ces deux choses est la plus grande distorsion du cycle.
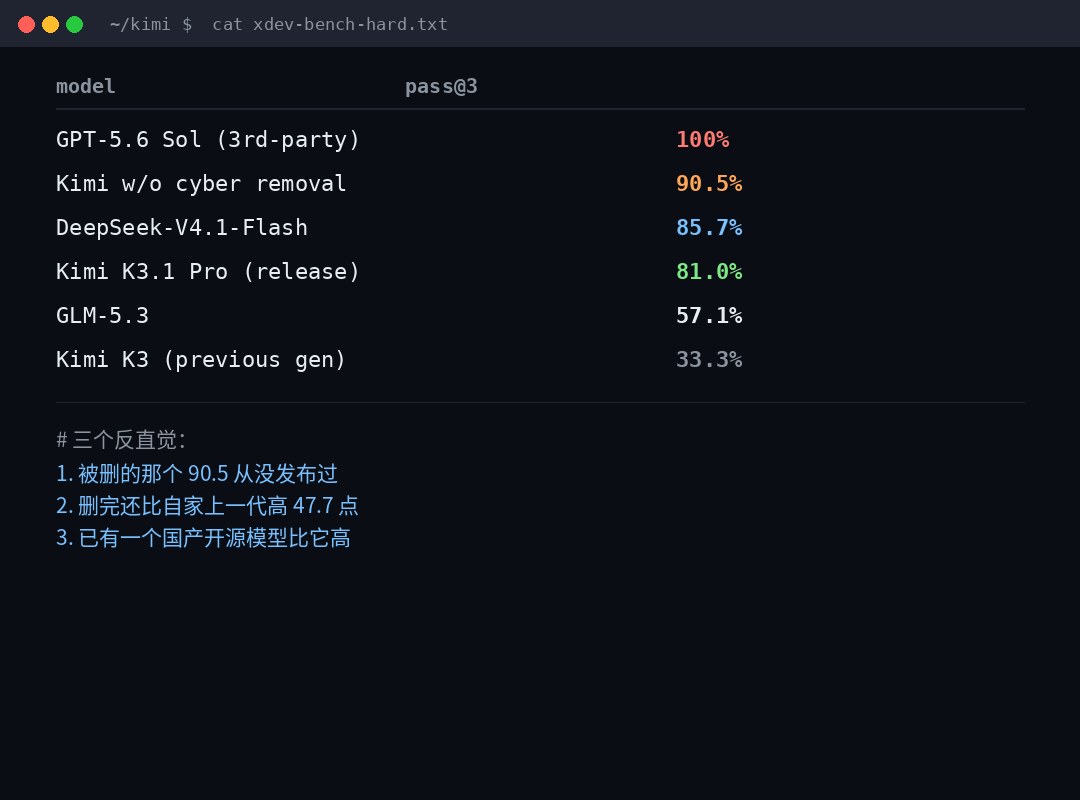
Maître complet :
| Modèle | xdev-bench-hard (pass@3) |
|---|---|
| GPT-5.6 Sol | 100% |
| Kimi (point de contrôle sans suppression de données informatiques) | 90.5% |
| DeepSeek-V4.1-Flash | 85.7% |
| Kimi K3.1 Pro (libération effective) | 81.0% |
| GM-5.3 | 57.1% |
| Kimi K3 (ancienne génération) | 33.3% |
Il y a trois faits contre-intuitifs dans ce tableau, je dis.
Trois ou trois faits négligés, chacun inversant un populaire.
Fait premier : celui qui a été supprimé, 90.5, vous n'avez jamais téléchargé.
Donc tu n'as rien "perdu". Tu sais, "Ils auraient pu faire plus, mais ils ont choisi de ne pas le faire."
Il s'agit d'une déclaration de sécurité, et non d'une perte de capacité.
Fait 2: Après avoir été supprimé, il était 2,4 fois plus fort que la génération précédente.
81.0 Oui, 33.3. Ce nombre est dans le titre, et le récit de tout est exactement le contraire.
Ce n'est pas Kimi qui devient faible, c'est Kimi qui devient plus fort, mais pas au point où il peut.
Fait III : Il y a déjà un modèle open source supérieur à cela.
DeepSeek-V4.1-Flash, 85,7 %.
Ainsi, l'inférence selon laquelle "d'autres modèles supprimeront la capacité d'attaquer" est de facto sans importance.La liste contient un modèle national de production de 4,7 points de haut.
Si vous dites tendances, les tendances sont:Le modèle de source de tête fermée est 100%, la source ouverte est entre 81 et 86, et tout le monde est pressé dans la même échelle.
C'est une image complètement différente de la « castration collective ».
IV. QUELLE EST LA BASE (et elle ne peut rien mesurer)
Ce paragraphe est celui que je veux le plus.
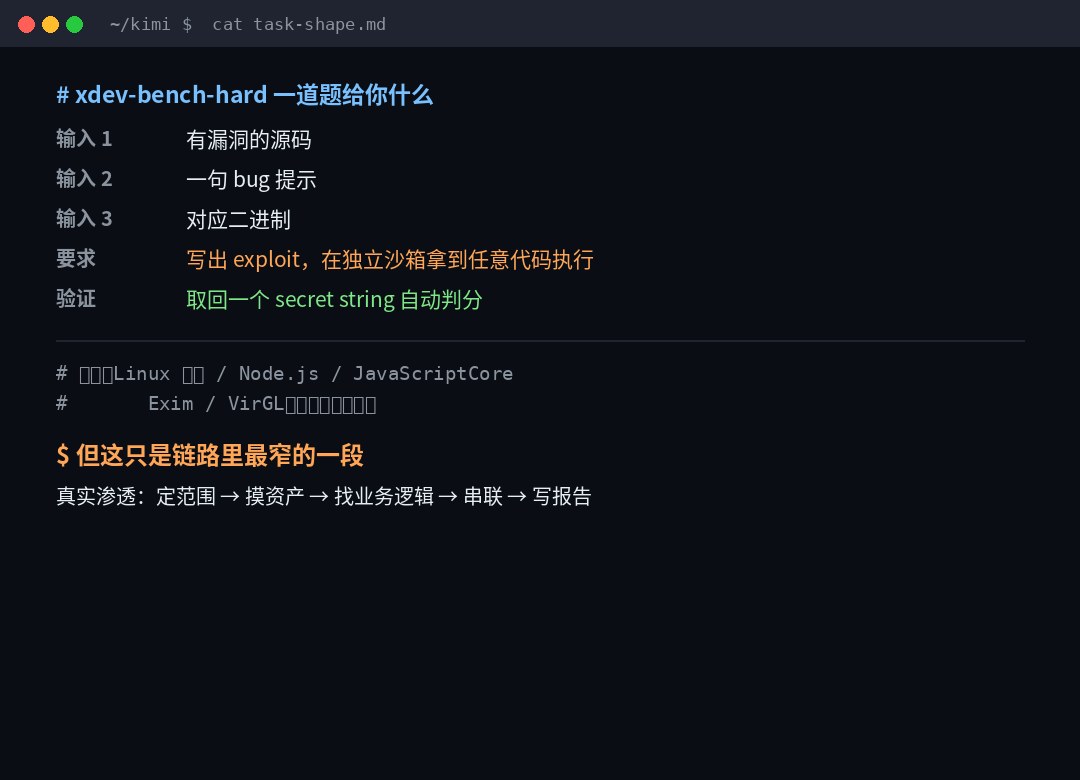
Xdev-bench-hard vous donne trois choses :
- Code source avec échappatoires
- Un indice de balle
- Correspondance binaire
L'exigence est d'écrire un exemplaire, obtenir tout code exécuté dans le bac à sable indépendant et récupérer une chaîne secrète pour la notation automatique.
La source est le noyau Linux, Node.js, JavaScriptCore, Exim, VirGL, le vrai logiciel. Lee.Révélations récentesEt...Tout est sur l'atténuation.Je ne sais pas.
C'est dur ? Difficile. L'utilisation de mesures d'atténuation est vraiment difficile.
Mais sa forme n'est pas comme une véritable pénétration.
La véritable infiltration a pris beaucoup de temps :
Réglez la portée, touchez les actifs, trouvez les entrées, creusez les lacunes de la logique d'affaires, déplacez-vous horizontalement, puisez dans les preuves, rédigez des rapports, expliquez au client.
Et xdev-bench-hard ne couvre qu'une petite droite au milieu :"Je sais qu'il y a un trou ici, abattre."
Où est l'argent réel, l'avance...
- La liste des actifs du client est erronée. Tu dois le faire toi-même.
- Un outil interne qui semble inoffensif. C'est une centrale électrique.
- Il n'y a pas de CVE, pas d'indice, pas de binaire, juste une intuition qui vous fait sentir "comment est-ce bizarre?"
- Nous devrons prouver l'impact.
Aucune de ces mesures ne peut être mesurée.
Donc, quand quelqu'un dit, "AI a remplacé l'ingénieur de test d'infiltration", ma question est:Quelle partie avez-vous remplacée ?
Si c'est "l'exploitation après un soupçon d'échappatoire", c'est vrai, l'IA est plus rapide que la plupart des gens. C'est arrivé il y a deux ou trois ans.
Si cela signifie "trouver l'endroit le plus intéressant face à un système réel étrange, mal défini, sans frontières",Loin.
V. Pourquoi cet auto-embraillage a-t-il un sens en ingénierie ?
La décision du côté obscur de la lune, d'un point de vue purement technique, est rationnelle.
Premièrement, le poids libre est irrévocable.
Un modèle à source fermée a constaté qu'il était trop capable d'ajouter une clôture, un nombre limité et une API fermée.Une fois que les poids open source sont libérés, le monde peut les télécharger et ne jamais les récupérer.
Donc le seul contrôle des risques qui peut être fait avec les modèles open source est...Avant qu'il ne sorte.Je ne sais pas.
Deuxièmement, leurs objectifs sont bien définis.
"Nous"Non, pas du tout.Le lancement étend le poids open source de la première ligne absolue de cybercapacité.
Attention au terme « front absolu ». Pas "pas de modèles attaquables" mais "pas de modèle qui mette le plafond de l'industrie en haut."
La différence entre les deux lignes est énorme. Le premier équivaut à une dévalorisation des arts martiaux, tandis que le second est simplement une mauvaise tête.
Troisièmement, ils se sont engagés à l'inverse.
Article 2: «Nous avons l'intention deAugmentation progressivecyber-capacités disponibles en poids open source.
L'article 3 explique la raison d'être: permettre aux personnes qui ont besoin d'une capacité à double usage d'utiliserDéfenseJe ne sais pas. Un modèle puissant open source, fonctionnant sur une infrastructure contrôlée par l'utilisateur, permettant à plus d'équipes de vérifier leurs propres codes de maintenance -Il s'agit notamment de systèmes anciens qui n'ont presque jamais fait l'objet d'un examen de sécurité spécifique.
Ce n'est pas une déclaration de relations publiques.La dette de sécurité du système legs est l'une des douleurs les plus réelles de l'Internet chinois. Un outil de vérification autonome pour la défense est disponible sur l'intranet, et les recettes sont réelles.
Donc ce n'est pas la castration, c'est la limite de vitesse. La direction est toujours en avant, juste un frein.
Six, ce n'est pas le pouvoir qui s'inquiète vraiment. C'est trois choses.
Si je suis praticien de la sécurité, je ne m'inquiète pas d'être stupide.
Je m'inquiète pour trois choses :
1 L'effet de coupe.
La limite supérieure de la capacité d ' un modèle de source ouverte est soumise à un < < modèle de source fermée de première ligne actuel à un niveau d ' il y a trois mois > > .
"K3.1 La cybercapacité de Pro est toujours derrière eux."Elle est accessible au public depuis au moins trois mois.Le modèle de source fermée de première ligne.
Ce "au moins trois mois" n'est pas aléatoire.C'est un délai.Je ne sais pas.
Que signifie pour la défense ? SignificationLes outils open-source les plus puissants que vous pouvez obtenir sont toujours trois mois derrière les meilleurs outils que les attaquants peuvent acheter avec de l'argent.
Cette lacune ne disparaît pas du fait du choix d'un constructeur particulier, et elle est normale à ce stade.
2 La transparence des sources de données s'est effondrée.
La partie la plus précieuse de cette annonce n'est en fait pas la 81.0.Il admet que le pouvoir du cyber vient du sous-produit naturel du langage commun.Je ne sais pas.
Traducteur: Vous voulez enseigner un modèle qui fuit, vous n'avez pas besoin de nourrir des données.En nourrissant suffisamment de code et de connaissances du système, il le fait.
Cela signifie "distiller des données" à long terme.C'est contraire aux lois de la physique.Je ne sais pas. Vous avez supprimé le matériel défensif évident, et la capacité de code générique se déversera dans la capacité d'attaque -- 81.0 sur la liste, ce qui est une preuve en soi.
Des repères et des fissures réalistes se développeront.
Les chambres de commerce de l'usine continuent à maintenir leurs repères internes (officiellement connus sous le nom de «keyp évolution de nos repères internationaux») parce que les repères existants perdent leur distinction une fois qu'ils sont remplis.
Mais...Plus la ligne de base est précise, plus la scène réelle est éloignée.Je ne sais pas. Il n'y a pas de "bug conseil" pour la pénétration réelle, pas de "binaire négatif" pour "rétribution" pour "chaîne secrète".
Les scores de référence seront donc plus élevés et le modèle « peut terminer un vrai projet pour vous » apparaîtra plus tard que prévu.
Oui. Retour à la question: Les ingénieurs d'essai d'infiltration tomberont-ils?
Pas du tout. Mais...Le travail sera redistribué.Et ça arrive déjà.
Mon jugement est en trois :
Ils seront remplacés :
- PC / extloit
- Vérification statique du code de masse d'abord.
- Vérification de configuration en double, inspection de base
- Les parties du rapport qui « redoublent pour changer le nom d'un client »
Il ne sera pas remplacé :
- Pour juger où ce système vaut le plus la peine de se battre, il faut comprendre les affaires et faire des compromis.
- Rétablissement de la comptabilisation des actifs dans les cas où la liste des actifs elle-même est erronée
- "Tu vas réparer ce risque ou pas ?" C'est la politique, pas la technologie.
- Prenez vos responsabilités.Quelque chose ne va pas. C'est signé par quelqu'un.
Elle sera agrandie :
- Une personne + un groupe de fêtes qui peuvent couvrir l'étendue d'une équipe précédente
- Le fait est,Pouvez-vous vérifier la sortie de l'agent ?Je ne sais pas. La capacité de validation devient de nouvelles compétences de base.
Donc le vrai problème n'est pas de prévoir, mais...Il comprend les tests de pénétration comme l'écriture.Je ne sais pas.
Cette compréhension était dépassée avant que l ' AI n ' apparaisse.
Huit : Je vais vous donner les vrais paramètres de ce modèle.
Étant donné qu'il s'agit de ce modèle, quelques chiffres sont effectivement utilisés:
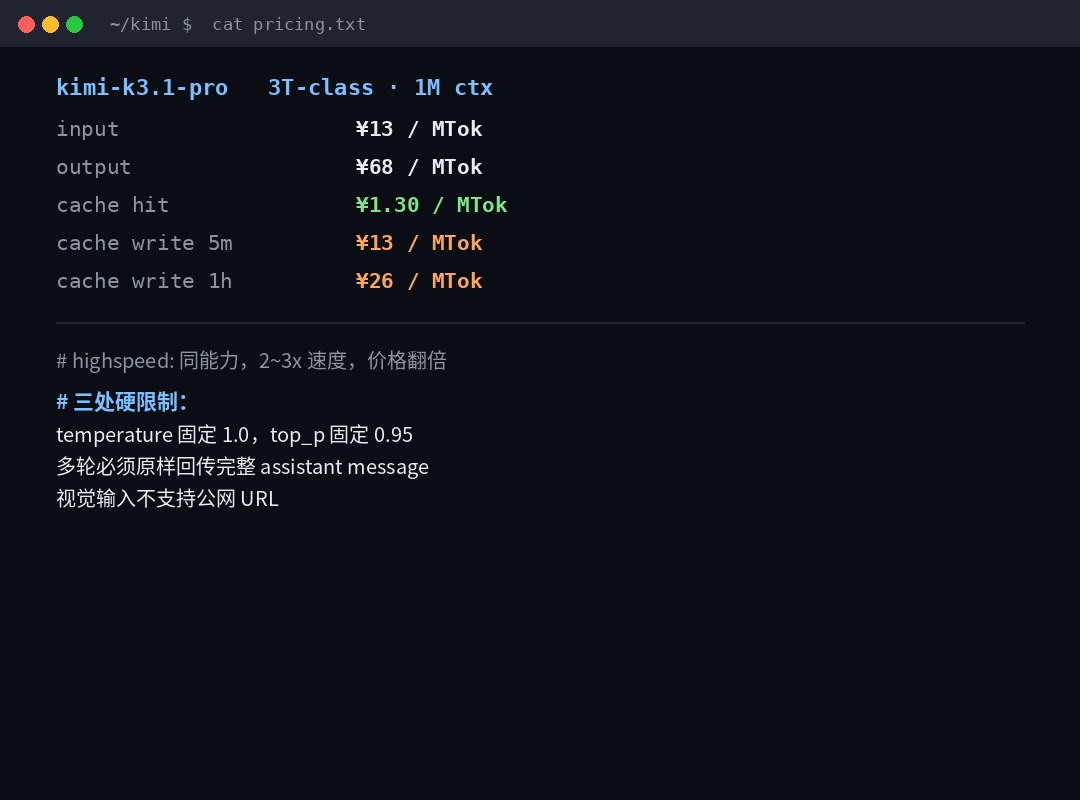
| Point | Kimi K3.1 Pro |
|---|---|
| Paramètres | 3 billions. |
| Contexte | 1M (1 048 576 jetons) |
| Entrez le prix | ¥13/ Millions de jetons |
| Prix à la production | 68/ million de jetons |
| Cache | ¥ 1,30 / Millions de jetons |
| Cache écrit 5 minutes | ¥13/ Millions de jetons |
| Cache écrite 1 heure | ¥26 / Millions de jetons |
| Expression | Cohérence, vitesse 2-3 fois, prix double (¥26/¥136). |
| Publication du poids | 4 novembre |
Le prix est indiqué. 5,2 foisLe prix du cache est entré. 1/10Je ne sais pas. C'est le contexte long standard + Structure des prix prioritaires de Cache :Plus votre système se déplace, plus il est stable, plus les économies sont importantes.
Il y a trois autres limites. Ceux qui marchent dessus souffriront.
temperatureCorrection1.0Je ne sais pas.top_pCorrection0.95Si vous transmettez une autre valeur, vous la manquerez.- Les conversations multi-cycles doivent être retournées dans leur intégralitéy compris
reasoning_contentJe ne sais pas. Si ça te manque, tu commences à dire des bêtises. - Entrée visuelleURL de l'image non prise en charge, seulement base64 ou
ms://
Et le dernier, je suppose, c'est que beaucoup de gens y passeraient : on y jette un lien photo, et ça ne le télécharge pas, et ça tourne mal.
Enfin.
Dans ce bulletin, je pense que ce n'est pas 81,0 ou 90,5 qui mérite le plus d'être rappelé.
Voilà."Nous avons l'intention d'augmenter progressivement la capacité de cyberdisponibilité en poids libres."
Parce qu'elle admet une prémisse...Les capacités peuvent être réglementées, pas simplement libéralisées ou scellées.
Au cours des deux dernières années, il n'y a eu que deux positions dans l'industrie à ce sujet : pleine ou non.Kimi a donné une troisième position cette fois : ouverte, mais lente, et a indiqué publiquement combien.
Vous ne pouvez pas être d'accord avec cette vitesse. Mais au moins il l'a mis sur la table et vous a dit où il était.
C'est beaucoup plus honnête que les refus muets de RLHF.
Quant aux "ingénieurs de test d'infiltration de génie", ils ne tombent pas.
Ça va arriver à des gens qui n'ont pu « scanner le scanner et changer la charge utile » que depuis 10 ans.Cela s'est produit avant la parution de l'IA, l'IA vient de repousser le calendrier deux ans plus tard.