
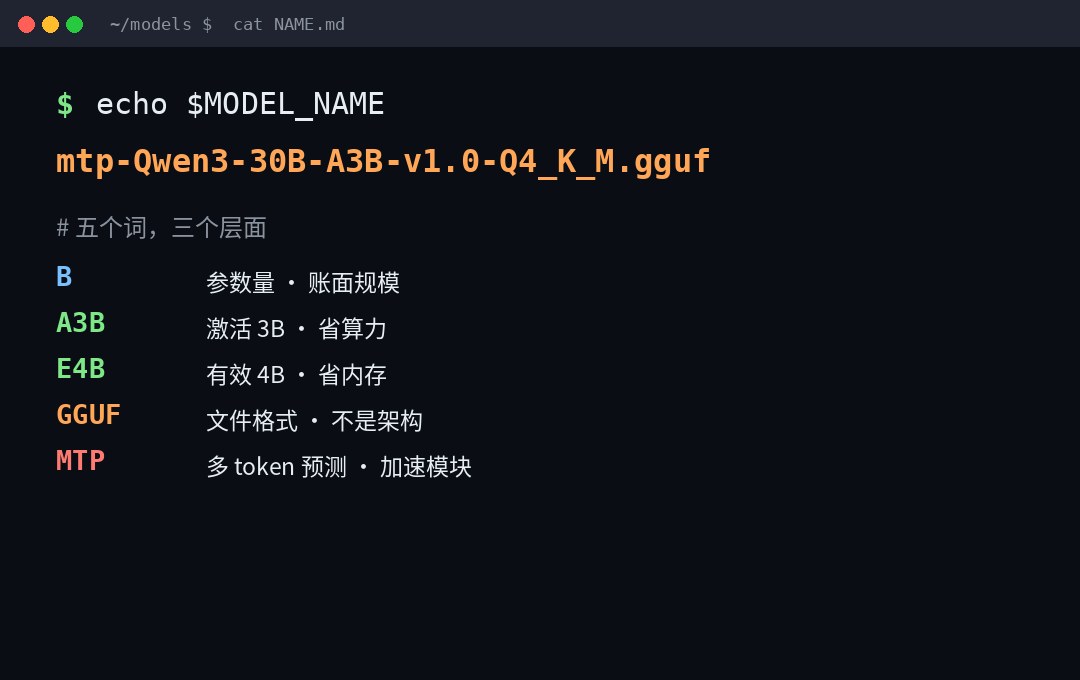
B, GGUF, MTP, A3B, E4B: Model adındaki beş karakter değil. Evet.
karışıklıkın yarısını kurtaran bir sonuçla başlayalım:Bu beş şey aynı boyutlarda değil.B kelimesi, A3B ve E4B "kahkadarlık", GGUF konteyner, MTP eklentidir. Aslında, tamamen farklı bir soruya cevap verirler.
Çalışmanın özel bölümü aşağıdaki gibidir:"B," "How big", "A3B", "How much work", "E4B", "How much is really in the memory," "GGUF" "What is in it", "MTP" "How does it speed."Dört veya beş belge aynı anda ortaya çıkıyor çünkü aynı tür bilgi olarak tedavi edildiğinde karışıklık sık sık ortaya çıkıyor.
Bir, B: Sadece bir milyar.
B milyarlarca, bir milyar.7B 7 milyar dolarlık bir parametre.235B Bu 235 milyar. GGUF adı kodunda bazı ölçek ekleri:K Binlerce binM Milyonlarca milyon,B Bir milyar.T trilyon dolar,Q Milyarlar.
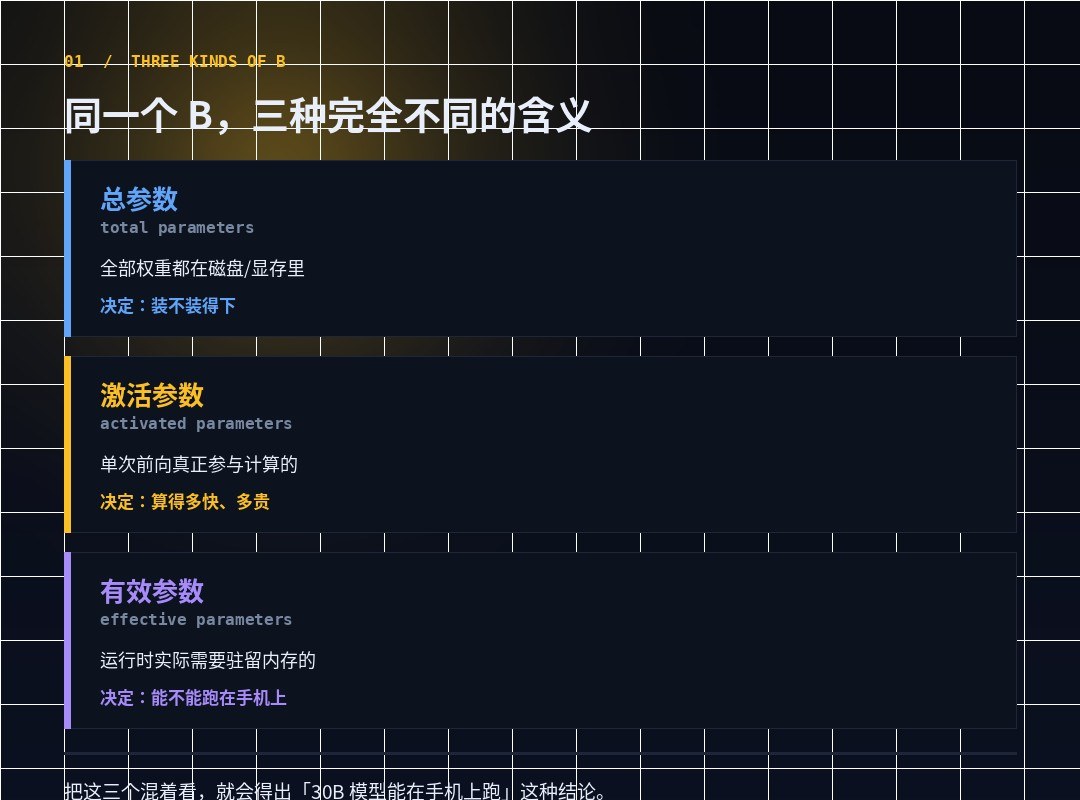
En basit olanı gibi görünüyor, aslında üç farklı anlamı var. Bu açık olması gereken ilk şey:
| Yazma Yazısı | Anlam | Ne karar? |
|---|---|---|
30B | Genel parametreler: tam ağırlık | Bunu oynayabilir misiniz?(disk, görünür) |
30B-A3B | Toplam 30B, tek aktivasyon 3B | Ne kadar hızlı? Ne kadar pahalı? |
E4B | Geçerli parametreler: Operasyon zamanında gerçek varlık | Telefonda koşabilir misiniz? |
Bu üç çizgiye birlikte bakarsanız, 30B modelinin bir cep telefonunda çalıştırabileceği sonucuna varacaksınız.Doğru olabilir, ancak bunun olduğunu düşündüğünüz 30B ile aynı değil.
II. A3B: Genel parametreler ve aktivasyon parametreleri bir kez Evet değildir.
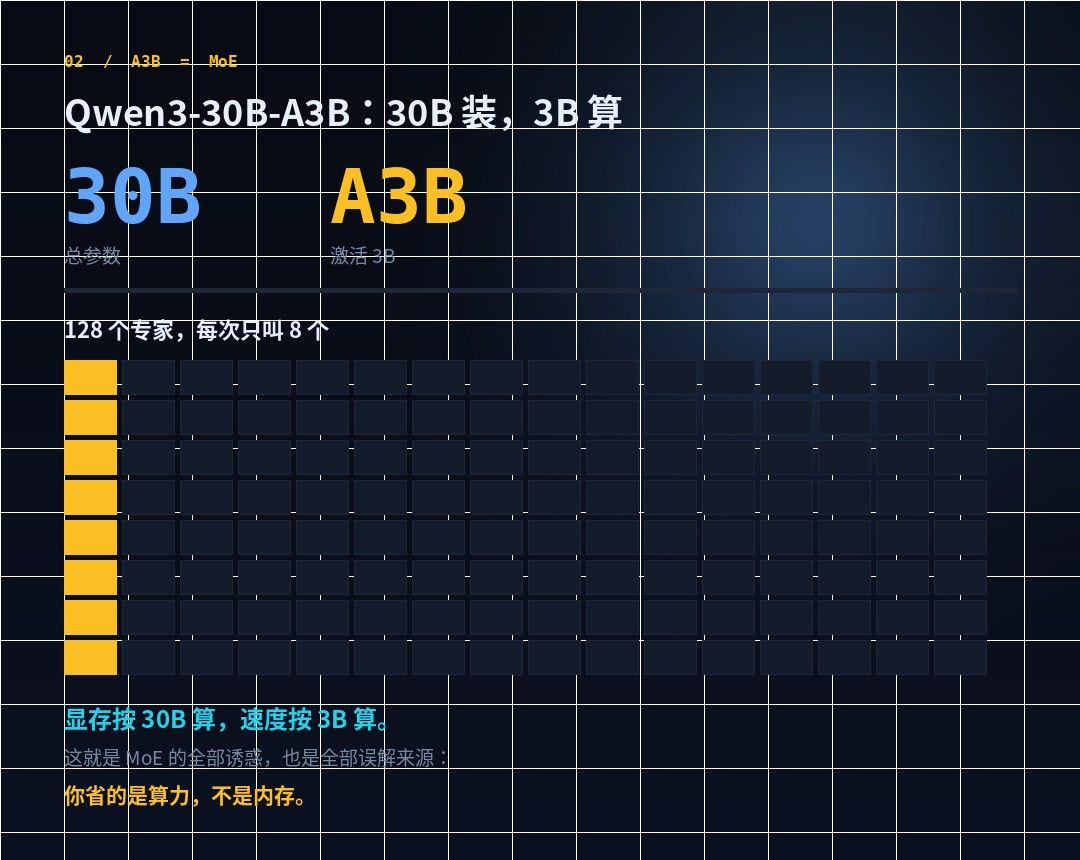
Bu MoE. Qwen3 modellerin isimleri hakkında çok açık:Qwen3-235B-A22B, "233.5 milyar toplam parametre, 22 milyar aktif parametre" ve Qwen3-30B-A3B, "30 milyar toplam parametre, 3 milyar aktif parametredir."
Teknik detaylar da özeldir: 30B-A3B 48 kata sahiptir, Q/KV başı 32/4 say128 uzmandan 8'i aktive etti, context 128K. 235B-A22B 94. kat, 64/4 kafa, ayrıca 128 uzman aktif 8.
Yani, A3B, bu işaretin gerçek anlamı:30B, hız 3B.
Bu, MoE’nin bütün günahlarını, yanlış anlamanın tüm kaynaklarıdır.Para biriktiriyorsunuz, hafıza değil.Birçok kişi A3B'yi görüyor ve 4GB makinesine yüklenen 3B modeli olduğunu düşünüyor ve sonra yüklemeyi imkansız buluyor. Kiloların hiçbiri küçük değildir, ancak tüm ileri hesaplamalar değil.
Yazmayı görmezden gelmek kolay: GGF BoyutLabel <expertCount>x<count><scale-prefix>Ve böylece 8x7B Bu, toplam 56B için "8 uzman x 7B" olarak adlandırılır.Bu ya bir multiplikasyon elpsi veya bir multiplikasyon.Mixtral-8x7B genellikle "7B modeli" olarak yanlış yorumlanır ve gerçek toplam parametre 56B'dir.
III. E4B:E effictive, "küçük" değil
Bu tamamen okumak için en kolay biridir. Gemma 3n'in belgesi açık:
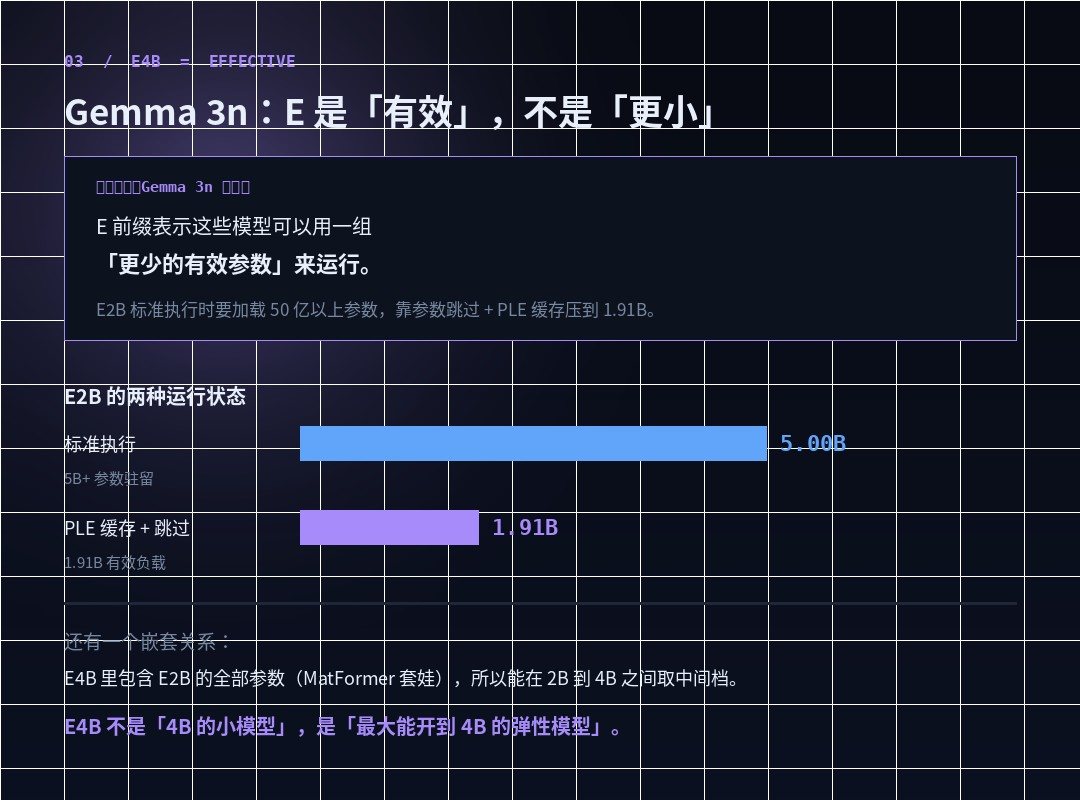
Gemma 3n modeli için parametre işaretleri (e. g. E2B, E4B)Daha azToplam parametrelerin miktarı aslında modele dahil edilmiştir. E prefix, bu modellerin "daha az aktif parametreler" setiyle çalıştırılabileceğini gösteriyor.
Ne ölçüde? Belge sayıyı verir:E2B standartları 5 milyardan fazla parametre yükleyerek, aktif hafıza yüklerini 1.91B'ye basın.
Bu cümlenin ana sözlerini unutmayın:Modelin kendisi daha küçük olmadı, çalışırken varlığı açısından daha küçük oldu.
Bu iki mekanizma aracılığıyla elde edilebilir:
- PLE Cache (Per-Layer Embeding).Her gömülü parametre katmanı, model bellekten ayrı olarak oluşturulabilir ve çalışan her katmanına eklenebilir.Bu, hafızadan parametrenin bu bölümünü sormak için eşit.
- MatFormer.Büyük bir model içinde gömülü birkaç küçük model var, bu da ortaya çıktığında dış parametreleri aktive etmek zorunda değil. Bu yüzden 2B ve 4B arasında herhangi bir orta alabilirsiniz.
Bu, karşıt bir gerçeğe yol açıyor:E4B tüm E2B parametreleri içerir.İki stand-alone model değil, aynı elastik model için iki yuva. Yani tam terim "E4B 4B küçük bir model" değil, "E4B."E4B, 4B'ye giden maksimum güçle elastik bir modeldir.Her yere gidiyorum gibi değil.
Bu, "benim ekipmanımda koşacağım" yargı üzerinde büyük bir etkiye sahiptir:E4B, düşük bütçeli ekipmana E2B gibi koşabilir ve 4B'ye yüksek çözünürlüklü ekipmanlar üzerinde genişleyebilir.Ve A3B bu elastikliğe sahip değil - 30B, sadece maliyet tasarrufu.
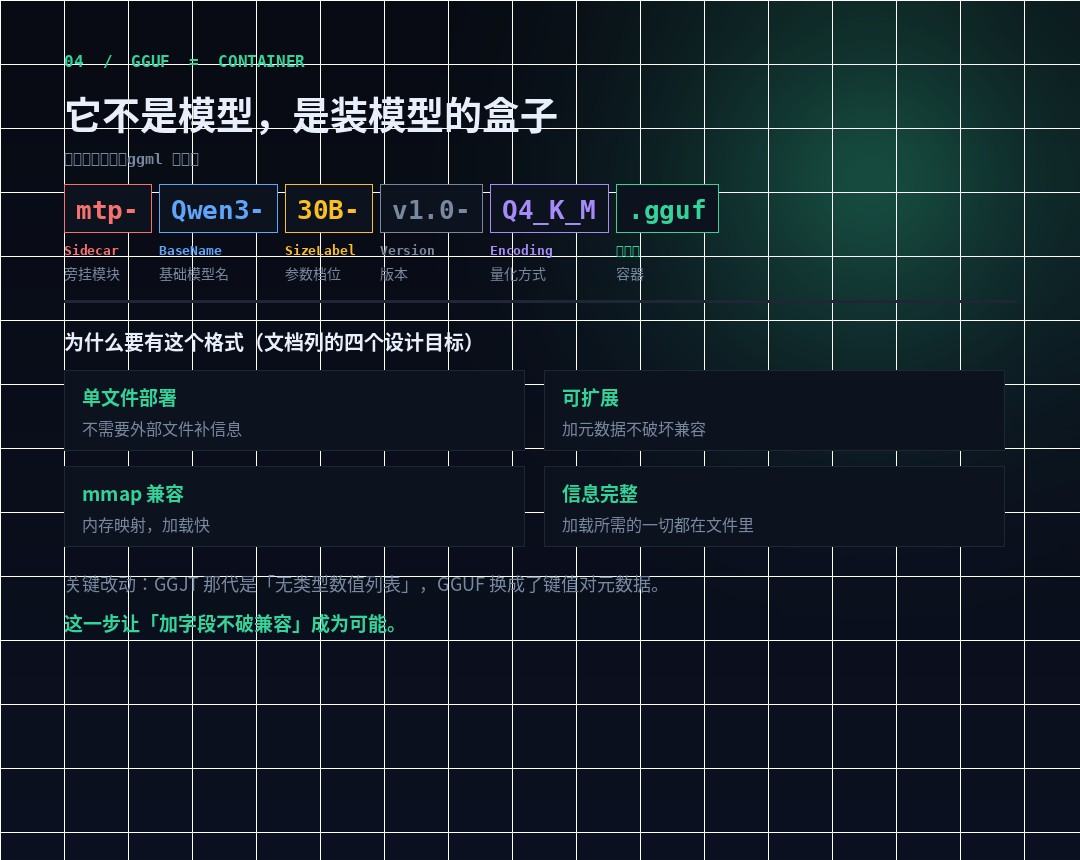
IV. GGUUF: Bir model değil, bir model kutusu.
İlk üçü, GGUF'den boyutları değiştiren modelin büyüklüğüdür:Bu dosya formatıdır.Kesin olmak için, GGUUF GGML ve uygulamacı (llama.cpp).
GGML, GGMF, GGJT, üç nesil formatını değiştiriyor. Resmi tasarım hedefleri dört, her biri geçmiş bir ağrı noktasına karşılık geliyor:
| Tasarım hedefleri | Ne ile anlaşma? |
|---|---|
| Single file deployment | Gerekli ek belgeler, doğrudan dağıtım ve yükleme |
| genişletilebilir | Yeni metadata eklemek eski modellerin uyumlulukını zayıflatmıyor |
mmap Uyumluluk | Memory Map Yükleniyor, hızlı |
| Tamamlanan bilgi | Yüklemeniz gereken her şey dosyada. Kullanıcılar bunu sağlamak zorunda değildir. |
GGJT'nin son nesli arasındaki önemli fark sadece bir cümledir, ancak anahtardır:hiperparametre, metadata'nın anahtarına sahip olmayan değerlerin bir listesinden değiştirilir.Bu adım "add field incompatability" için mümkün oldu - bir kez bir alan eklendi, tüm eski çözücüler değiştirildi.
Nasıl yazdın?
Resmi adlandırma kodu:
[].ggufGerçek bir örnek alın.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-• Sidecar (byline modülü, bir sonraki bölüm bakınız)Qwen3→ BaseName (base model adı)27B→ BoyutLabel (parametre slot)v1.0Version (vers)Q4_K_MEncoding (weight encoding / niceification)
Sık sık tanınmayan iki bileşen vardır:
- Tip.:
LoRABu, tam bir model değil bir adaptör olduğu anlamına gelir;vocabKelime dosyasını gösterir. - Shad.:
00003-of-00009Kesmeleri gösterir, 9 Dikkatin 3.Sayılama 00001'de başlıyor00000 değil.
Ayrıca normda önemli bir feragat vardır:Bu, " vahşide tamamen memnun olmayacak" diye adlandırılır.Çünkü mevcut gguf dosyası çok farklı.Bu yüzden dosya adındaki şeylerin normal bir tahminini yazmayın, metadata okuyun.Dosya general.basenameBilmiyorum.general.size_labelBilmiyorum.general.finetune Bu otoritedir.
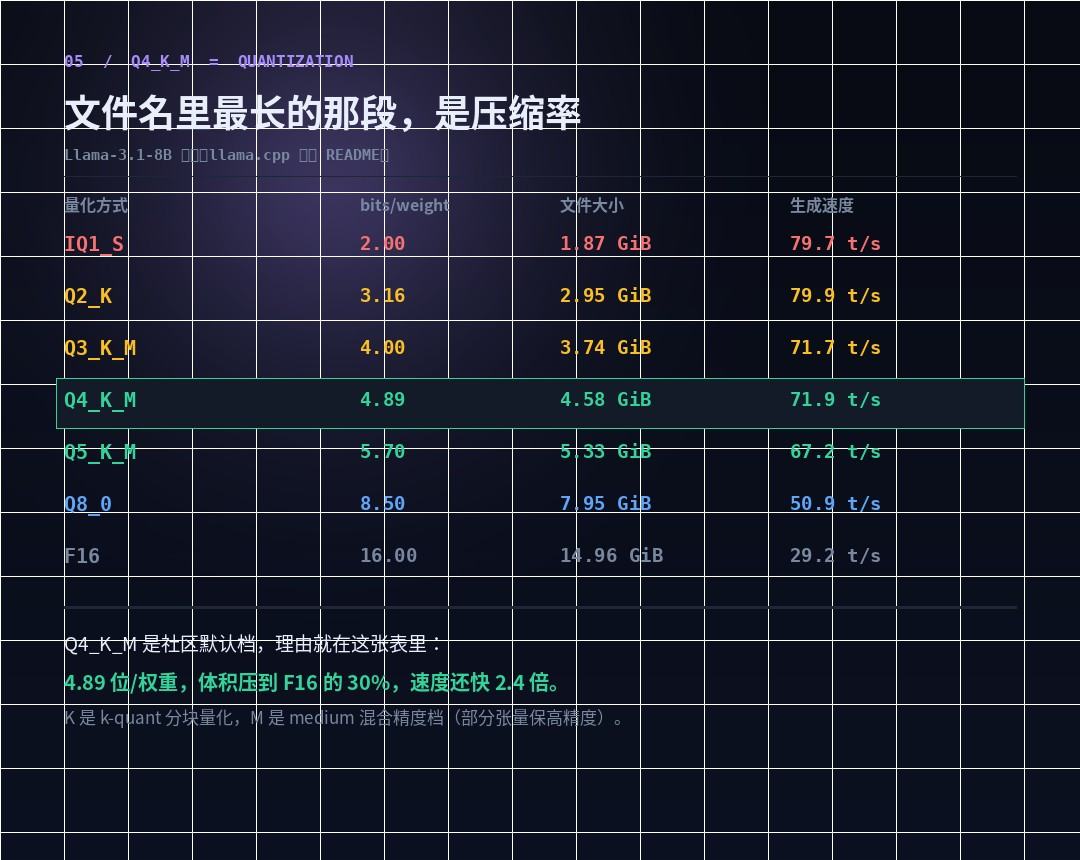
V. Q4 K M: Dosya adının en uzun kısmı sıkıştırma oranıdır
Bu, çoğunuzun uygulamadaki deneyiminizi etkilediği ve kimsenin açık olmadığı bir şeydir.Ne kadar ağırlık ölçüldiğini gösterir.
llama.cpp Resmi OKME, Llama-3.1-8B'yi gerçek bir anket yapmak için kullandı ve birkaç adım aldım (orijin model 32.1 GB):
| Quantification | Biraz / sağ | Dosya Boyutu | Genrate Speed |
|---|---|---|---|
| IQ1 S | 2.00 | 1.87 GiB | 79.7 t /s |
| Q2 K | 3.16 | 2.95 GiB | 79.9 t /s |
| Q3 K M | 4.00 | 3.74 GiB | 71.7 t /s |
| Q4 K M | 4.89 | 4.58 GiB | 71.9 t /s |
| Q5 K M | 5.70 | 5.33 GiB | 67.2 t /s |
| Q8 0 | 8.50 | 7.95 GiB | 50.9 t /s |
| F16 | 16.00 | 14.96 GiB | 29.2 t /s |
Q4 K M, bu masadaki tüm nedenlerle topluluk varsayılan dosyası haline gelir:4.89 Bits / ağırlıks, F16'nın% 30'u gerilogla, bu 2.4 kat daha hızlı.Q8 0'a kadar, hacim çiftleri ve% 30'a kadar düşüyor ve çoğu insan bilmiyor; IQ1 S'ye göre, hacim biraz daha yüksek ve kaliteli riskler çok daha yüksek.
Adınızı nasıl okuyorsunuz?
- Kraliçe = Düzenli ölçüm;IQ IQ = Malzeme matrisi aynı basamaklarda daha iyi kalite ve biraz daha yavaş hız ile ölçülmektedir.
- Sayı Sayısı = hedef basamaklar. Q4 biraz, Q8 8 biraz.
- K = k-quant, blok ölçüm (block-wise), yaşlı
_0/_1Seri daha ayrıntılı. - S / M / L = küçük/media/large, karışık hassas yuva.M onları yüksek tutmak için hassas kapaklardan bazılarını seçer.Bu yüzden Q4, K M K S'den biraz daha büyük.
Birçok insanın bilmediği başka bir gerçek var:Quantification bir durumda-by-case temelinde özelleştirilmiş olabilir.Resmi araçlar, tür tarafından farklı türlerin tasarımını destekler: attn_v ve ffn_down Q5 K M olarak ayrı ayarlar, diğerleri Q4 K M olarak muhafaza edilirken, aynı zamanda düzenli bir toplu sayı ile ayarlamayı da destekler. Ve bu yüzden aynı "Q4 K M" tipi dosya, insanların baskıladığı dosyanın büyüklüğünden farklıdır.Varsayılan bir strateji, kesin bir spesifikasyon değil.
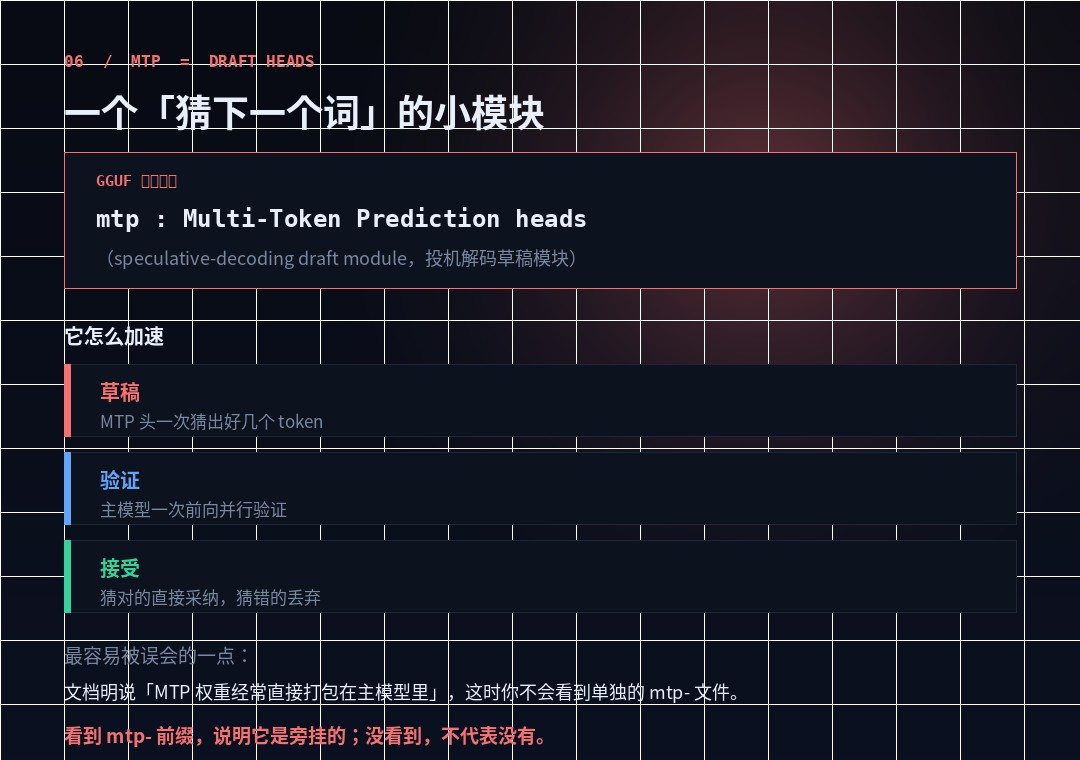
VI. MTP: “Bir sonraki kelime” olarak adlandırılan küçük bir modül
Bir model olarak kullanmak kolay olan son kişi aslında.Dosya Rol TagBilmiyorum. GGF belgesinde mtp Sidecar (accompanied modülü) olarak tanımlayın:
Multi-Token Predation Headers, Speculative decodering için draft modülü, temel modeller eşleştirme mimarisi ve versiyonları ile yüklenmek için tasarlanmıştır.
Basit:Önümüzdeki birkaç jeton tahmin edelim ve ana modelin paralel olarak çalışmasını sağlayın.Doğru doğrudan kabul, yanlış damla. Çünkü doğrulama her zaman birden fazla jetonu doğrulayabilir, ortalama zaman içinde token - bu spekülatif decodering prensibidir.
Ancak bu bölümde en çok hatırlanması gereken belgede bir cümle var:"MTP ağırlıkları genellikle doğrudan temel modellere doludur, bu durumda ayrı mtp-side dosyası yoktur."
Yani doğru anlayış:Evet. mtp- Ön ekler, dışarıda olduklarını gösteriyorlar; hiç görülmedi, hiçbir şey ifade etmiyor.Bu yüzden MTP'yi model listesinde aramak genellikle bulunamadı - zaten ana dosyada.
Diğer Sidecar... mmproj(multimodal projektörü, multimodular projektörü), görsel ve ses encoder artı projeksiyon katmanı.Bu genellikle bir temel modelle yüklenmesi gereken bir stand-alone belgesidir.Bu yüzden GGF'in çok yönlü bir modelini koyarsanız ve haritayı göremiyorsunuz, muhtemelen mmproj dosyasını eksik.
VII. Beş karakterin tam okuması
Yukarıdakilerin hepsi tam bir okumadır. Bu dosya adını gördüğünüzü varsayalım:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| Snippet | Hangi zemindir? | Annotations |
|---|---|---|
mtp- | Dosya Rolü | Eklenen spektral decodement modülü ana modelle eşleştirmek gerekir |
Qwen3 | Model Kimlik | Base Model Adı |
30B | Boyut Boyutu | Toplam parametre 30 milyar milyar Yapmamaya karar verdim. |
A3B | Hesaplama | Üç milyar bir süre. Ne kadar hızlı koşmaya karar verdin? |
v1.0 | Version Version Version | Kilo Version |
Q4_K_M | Depolama | 4.89 bit / ağırlık, orta karışım hassas |
.gguf | Konteynerler | llama.cpp. |
Belgenin özeti:Bir seferde 30 milyar ve bir MoE modeli, GGUUF konteynerine yaklaşık 4.9 yere basıldı, ek bir spekülatif decoded hızlandırma modülü ile.
VIII. En yaygın yanlış okumaların dördü
- A3B'yi 3B modeli olarak düşünün.Bu hafıza değil. 30B daha az ağırlık yok ve 4GB hala görünür.
- E4B "4B küçük bir model" olarak.En büyük elastik model seti. E4B, E2B. Low-fit'in tüm parametrelerini 2B'ye içeriyor, 4B değil.
- GGF'yi bir model olarak kullanın.Aynı model F16, Q8 0, Q4 K M birkaç GGUUF olabilir.GGUF bir konteyner ve ölçüm içeriktir."Q4 ve GGUF iyi" sormak, " Şişe ve su iyi" diye sormak gibidir.
- Bu yazı, Suriye protestolarımızın bir parçasıdır 2011Anlaşmanın tamamen yasal olmadığı resmi açıklama. Dosyanın metadata'sına doğru bilgilerle erişmek için düzenli kural yazmayın.
Ve gizli bir beşinci var:Put 8x7B 7B okuyun.Bu "8 uzman her 7B." Total 56B. GGUF <expertCount>x<count> x multiplikasyondur.
IX. PURPOSE OF PRACTICAL ADJUSTMENTS
Son olarak, takip edilebilir bir dizi verin. Herhangi bir model adına bakın ve bu sırayla kendinize sorun:
- İlk olarak konteynerlere bakın ve ölçmek.
.gguf+Q4_K_MBu, yerel bir run-off kitle versiyonu olduğu anlamına gelir ve kalite ve hacim zaten serbest bırakma zamanında ayarlanır. - Genel parametreleri tekrar okuyun.Varlığınızın /RAM'ın yeterli olup olmadığına karar verin. Bu zor bir eşiği. Bu yeterli değil.
- Eğer Moe ise görün.Evet.
A??BAçıklama aktivasyon parametrelerine dayanmaktadır, ancak hafıza hala toplam parametrelere dayanmaktadır. - Bir E eki varsa bakın.Evet.
EBu, elastik bir model olduğunu ve gerçek varlığın nominal değerin altında iyi olabileceğini gösteriyor - bu cep telefonuna erişebileceğini belirler. - Son olarak Sidecar'a bakın.Evet.
mmproj-Bir araya gelmeyi unutmayın; evet.mtp-Maçı hatırlayın; ne de hızlanmadığı anlamına gelir.
Model adı bir parametre masası değil, bir etiket. Etiket sizi bir sonraki yanlış dosyadan uzak tutmak için çalışır, puanını hesaplamamak için değil.
Her zaman çalışıyor. Ancak etiketi doğru bir şekilde okumak için, en azından 15GB'yi yüklemeden önce bileceksiniz...Bu zamandan tasarruf etti, herhangi bir kriter puanından daha fazlası.