
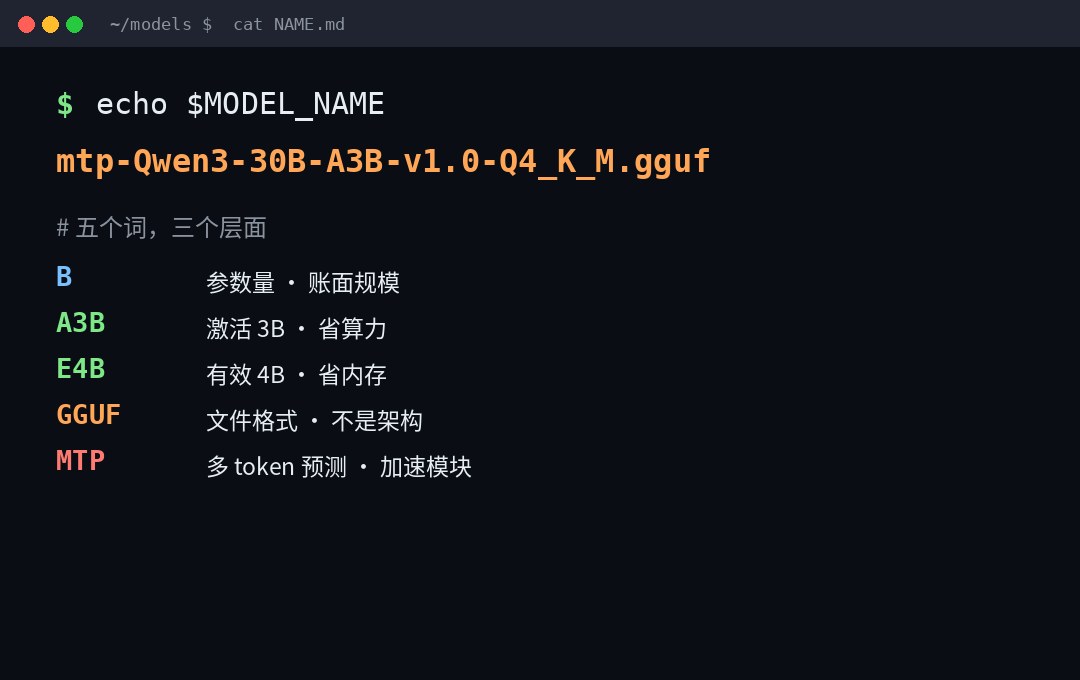
B, GGUF, MTP, A3B, E4B: Die fünf Zeichen im Modellnamen, nicht eines. Ja.
Beginnen wir mit einer Schlussfolgerung, die die Hälfte der Verwirrung erspart:Diese fünf Dinge sind überhaupt nicht die gleichen Dimensionen.B ist das Wort, A3B und E4B ist die "Menge", GGUF ist der Container, MTP ist das Plugin. Tatsächlich beantworten sie eine ganz andere Frage.
Die spezifische Arbeitsteilung ist wie folgt:"B", "Wie groß", "A3B", "Wie viel Arbeit", "E4B", "Wie viel ist wirklich im Gedächtnis", "GGUF", "Was ist drin", "MTP", "Wie beschleunigt es sich?"Vier oder fünf Dokumente erscheinen gleichzeitig, weil sie gleichzeitig ausgedrückt werden müssen - aber Verwirrung tritt oft auf, wenn sie als die gleiche Art von Informationen behandelt werden.
Eins, B: Es sind nur eine Milliarde.
B ist eine Milliarde, eine Milliarde.7B Es ist ein Parameter von 7 Milliarden Dollar.235B Das sind 235 Milliarden. Es ist eine Reihe von Skalenpräfixen im GGUF-Namenscode:K TausendeM Millionen,B Eine Milliarde.T Billionen Dollar,Q Milliarden.
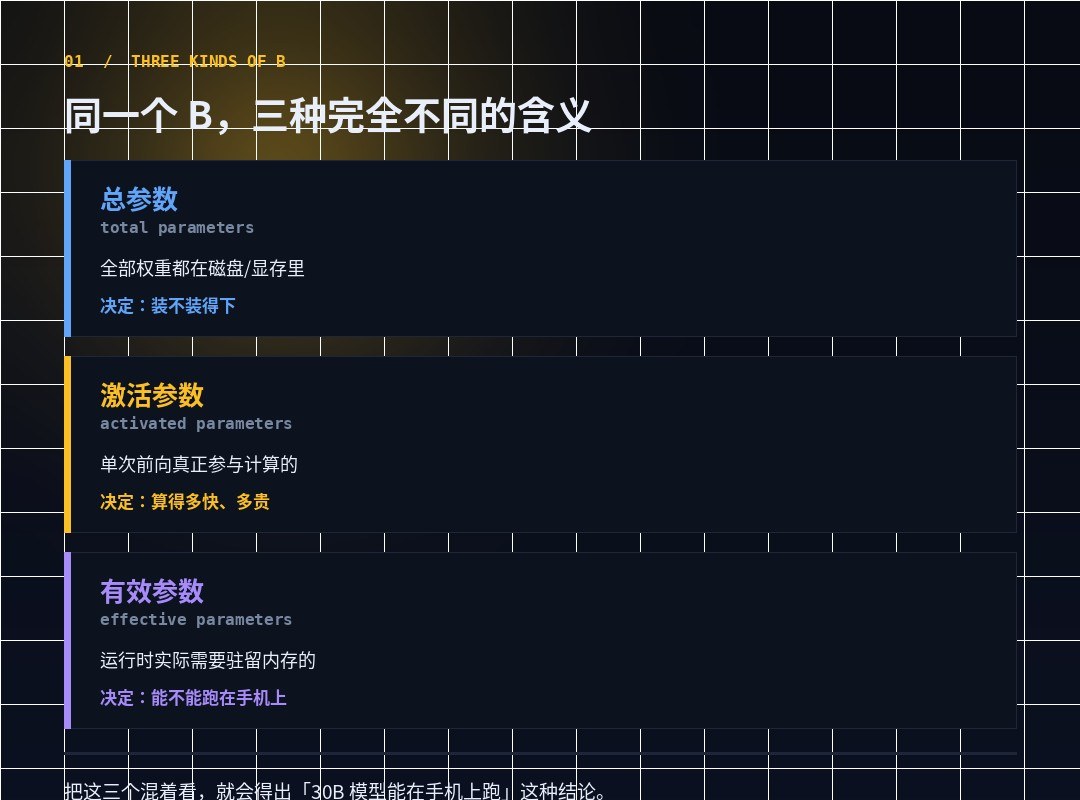
Sieht aus wie die einfachste, hat eigentlich drei völlig unterschiedliche Bedeutungen. Dies ist das erste, was klar sein sollte:
| Schreiben | Bedeutung | Was entscheiden? |
|---|---|---|
30B | Gesamtparameter: Vollgewicht | Kannst du es spielen?(Scheibe, sichtbar) |
30B-A3B | Insgesamt 30B, einmalige Aktivierung 3B | Wie schnell? Wie teuer? |
E4B | Gültige Parameter: tatsächliches Vorhandensein zum Zeitpunkt des Betriebs | Können Sie am Telefon laufen? |
Wenn Sie diese drei Linien zusammen betrachten, erhalten Sie den Schluss, dass das 30B-Modell auf einem Handy laufen kann.Es mag richtig sein, aber es ist nicht das gleiche wie die 30b, die sie dachten.
II. A3B: Allgemeine Parameter und Aktivierungsparameter sind nicht einmal Ja.
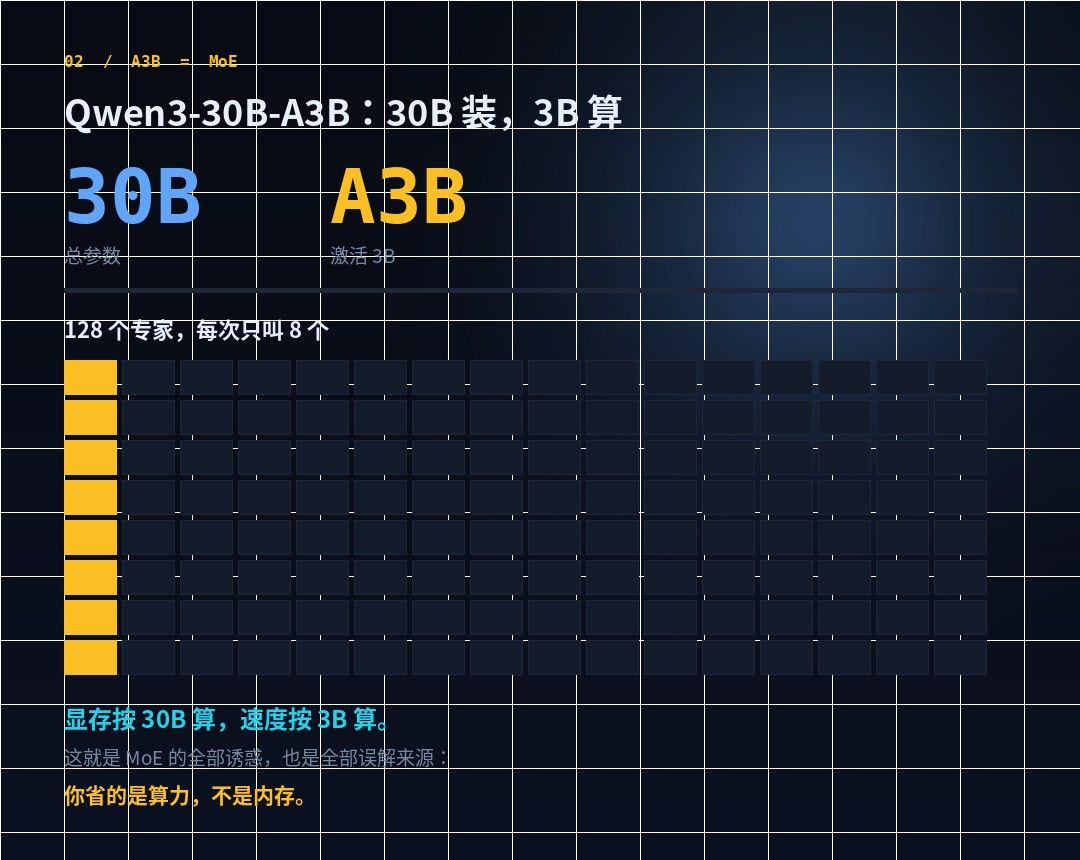
Dies ist von MoE. Qwen3 ist sehr klar über die Namen der Modelle:Qwen3-235B-A22B ist ein großes Modell von "233,5 Milliarden Gesamtparametern, 22 Milliarden aktivierten Parametern", und Qwen3-30B-A3B ist ein kleines MoE von "30 Milliarden Gesamtparametern, 3 Milliarden aktivierten Parametern".
Technische Details sind auch spezifisch: 30B-A3B hat 48 Stockwerke, Q / KV Kopfzahl 32/48 von 128 Spezialisten aktiviertKontext 128K. 235B-A22B ist 94. Stock, 64/4 Kopf, auch 128 Experten aktiviert 8.
Also, A3B, die eigentliche Bedeutung dieser Marke ist:Displays 30B, Geschwindigkeit 3B.
Das ist die ganze Versuchung von MoE, alle Quellen von Missverständnissen.Sie sparen Geld, nicht Gedächtnis.Viele Leute sehen A3B und denken, es ist ein 3B-Modell, geladen auf einer 4GB-Maschine, und dann finden es unmöglich zu laden. Keines der Gewichte ist klein, aber nicht alle Vorwärtsberechnungen.
Zusammen mit einem leicht zu ignorierenden Schreiben: SizeLabel von GGF ist <expertCount>x<count><scale-prefix>♪ Und so ♪ 8x7B Dies wird "8 Experten x 7B" genannt, für insgesamt 56B.Das ist entweder eine Multiplikationsellipsis oder eine Multiplikation.Mixtral-8x7B wird oft als "7B-Modell" falsch interpretiert und der tatsächliche Gesamtparameter ist 56B.
III. E4B:E ist wirksam, nicht "kleiner"
Dies ist eine der am einfachsten vollständig zu lesen. Das Dokument von Gemma 3n ist eindeutig:
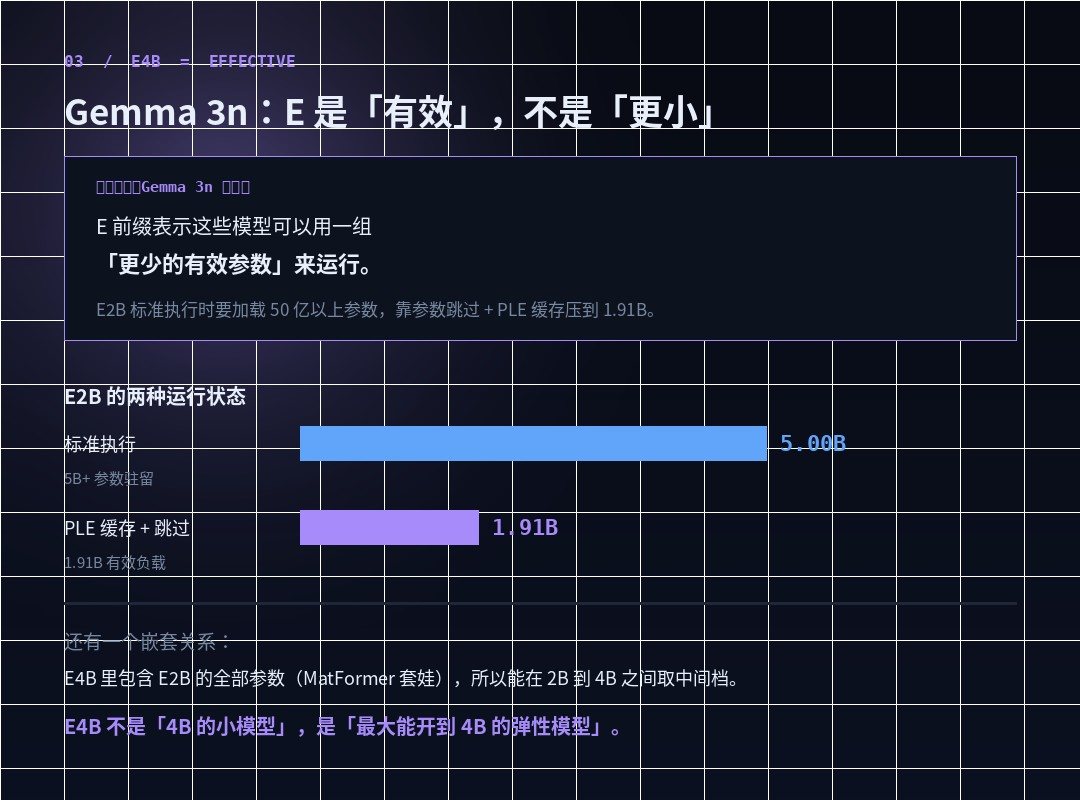
Parametermarkierungen für das Gemma 3n-Modell (z. B. E2B, E4B)weniger alsDie Gesamtzahl der Parameter, die tatsächlich im Modell enthalten sind. E-Präfix zeigt an, dass diese Modelle mit einer Reihe von "weniger aktiven Parametern" ausgeführt werden können.
In welchem Umfang? Das Dokument gibt die Nummer an:E2B-Standards werden durch das Laden von mehr als 5 Milliarden Parametern, Überspringen und PLE-Caches nach Parametern implementiert, um die aktive Speicherlast auf 1,91B zu drücken.
Beachten Sie die wichtigsten Worte dieses Satzes:Das Modell selbst ist nicht kleiner geworden, es ist in Bezug auf seine Präsenz während des Laufens kleiner geworden.
Dies kann durch zwei Mechanismen erreicht werden:
- PLE Cache (Per-Layer Embeding).Jede Schicht eingebetteter Parameter kann separat aus dem Modellspeicher generiert, in einem schnellen lokalen Speicher zwischengespeichert und bei der Ausführung zu jeder Schicht hinzugefügt werden.Das ist gleichbedeutend damit, diesen Teil des Parameters aus dem Speicher herauszufordern.
- MatFormer.Es gibt mehrere kleine Modelle, die in ein großes Modell eingebettet sind und bei der Ableitung keine äußeren Parameter aktivieren müssen. So können Sie eine beliebige Mitte zwischen 2B und 4B nehmen.
Dies führt zu einer kontraintuitiven Tatsache:E4B enthält alle E2B-Parameter.Nicht zwei eigenständige Modelle, zwei Steckplätze für dasselbe elastische Modell. Der genaue Begriff ist also nicht "E4B ist ein 4B kleines Modell", sondern "E4B".E4B ist ein elastisches Modell mit maximaler Leistung bis 4B.Es ist nicht so, dass ich irgendwohin gehe.
Dies hat einen großen Einfluss auf das Urteil, dass "kann ich auf meiner Ausrüstung laufen":E4B kann E2B-ähnlich auf Geräten mit geringer Ausrüstung laufen und auf Geräten mit hoher Ausrüstung auf 4B erweitert werden.Und A3B hat diese Elastizität nicht - es ist 30B, es ist nur kostensparend.
IV. GGUUF: Es ist kein Modell, es ist eine Modellbox.
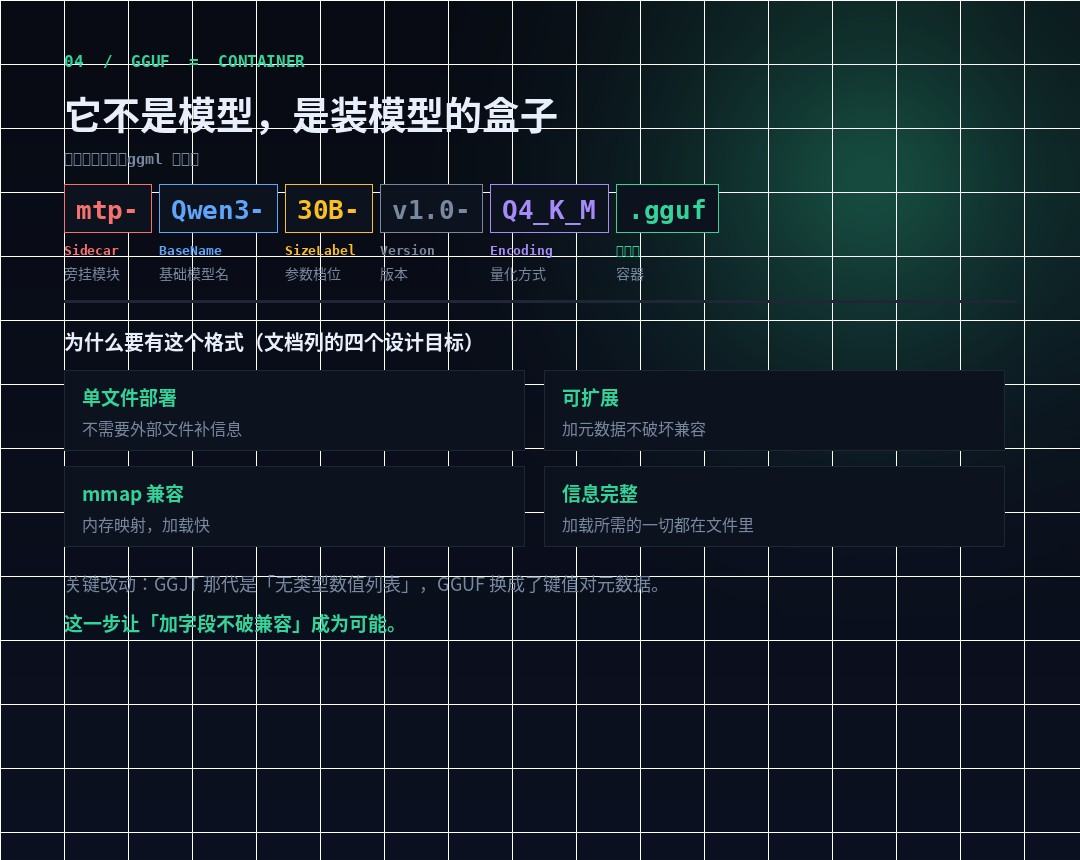
Die ersten drei sind die Größe des Modells, das die Abmessungen von GGUF geändert hat:Das ist das Dateiformat.Genauer gesagt ist GGUUF ein Modellspeicherformat für GGML und seinen Implementierer (llama.cpp).
Es ersetzt GGML, GGMF, GGJT, Drei-Generationen-Format. Die offiziellen Designziele sind vier, von denen jede einem vergangenen Schmerzpunkt entspricht:
| Entwurfsziele | Umgang mit was? |
|---|---|
| Single File Deployment | Keine zusätzlichen Unterlagen erforderlich, direkte Verteilung und Verladung |
| Erweiterbar | Das Hinzufügen neuer Metadaten untergräbt nicht die Kompatibilität alter Modelle |
mmap Vereinbarkeit | Memory Map Laden, schnell |
| Vollständige Angaben | Alles, was Sie zum Laden benötigen, befindet sich in der Datei. Benutzer müssen es nicht liefern. |
Der Hauptunterschied zwischen ihm und der letzten Generation von GGJT ist nur ein Satz, aber es ist der Schlüssel:Der Hyperparameter wird von einer Liste von Werten ohne Typ in einen Schlüssel zu Metadaten geändert.Dieser Schritt ermöglichte es, "Feldinkompatibilität hinzuzufügen" - sobald ein Feld hinzugefügt wurde, mussten alle alten Solver geändert werden.
Wie hast du es geschrieben?
Der offizielle Namenscode lautet:
[].ggufNehmen Sie ein echtes Beispiel.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-• Sidecar (Byline-Modul, siehe nächster Abschnitt)Qwen3→ BaseName (Basismodellname)27B→ SizeLabel (Parameter-Slot)v1.0Version (Version)Q4_K_MKodierung (Gewichtskodierung/-quantifizierung)
Es gibt zwei Komponenten, die nicht oft bekannt zu sein scheinen:
- Typ.:
LoRAEs bedeutet, dass es ein Adapter ist, kein vollständiges Modell;vocabgibt die Vokabulardatei an. - Schad.:
00003-of-00009Zeigt den Bruch, 3. von 9 Aufmerksamkeit.Nummerierung beginnt bei 00001Nicht 00000.
Es gibt auch einen wichtigen Disclaimer in der Norm:Es heißt "wird in der Wildnis nicht vollständig entzifferbar sein.", weil die vorhandene gguf-Datei zu vielfältig ist.Schreiben Sie also keine regelmäßige Vermutung, was im Dateinamen enthalten ist, sondern lesen Sie Metadaten.Datei general.basenameIch weiß es nicht.general.size_labelIch weiß es nicht.general.finetune Es ist Autorität.
V. Q4 K M: Der längste Teil des Dateinamens ist die Kompressionsrate
Dies ist derjenige, der Ihre Erfahrung in der Praxis am meisten beeinflusst, und derjenige, den niemand klargestellt hat.Es gibt an, wie viel Gewicht quantifiziert wurde.
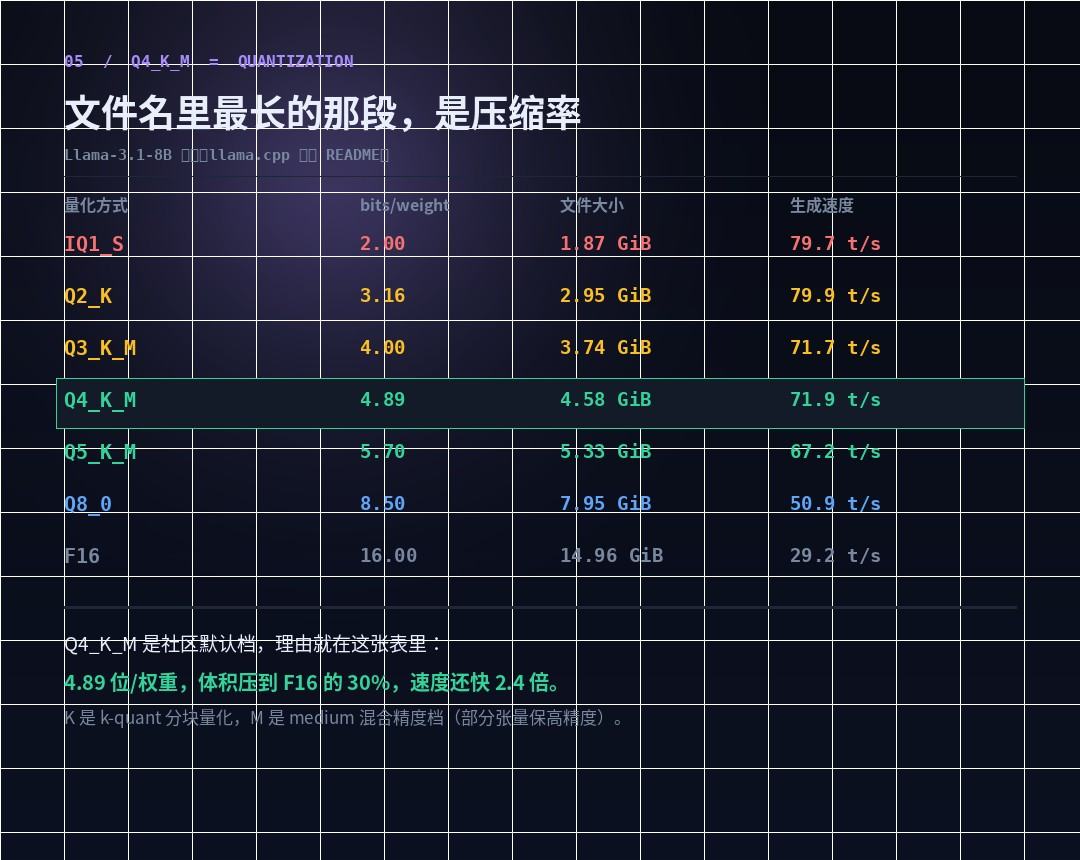
llama.cpp Official README verwendete Llama-3.1-8B, um eine faktische Umfrage durchzuführen, und ich machte ein paar Schritte (Originalmodell 32.1 GB):
| Quantifizierung | Bits/rechts | Dateigröße | Drehzahl erzeugen |
|---|---|---|---|
| IQ1 S | 2.00 | 1,87 GiB | 79,7 t/s |
| Q2K | 3.16 | 2,95 GiB | 79,9 t/s |
| Q3 K M | 4.00 | 3,74 GiB | 71,7 t/s |
| Q4 K M | 4.89 | 4,58 GiB | 71,9 t/s |
| Q5 K M | 5.70 | 5,33 GiB | 67,2 t/s |
| Q8 0 | 8.50 | 7,95 GiB | 50,9 t/s |
| F16 | 16.00 | 14,96 GiB | 29,2 t/s |
Q4 K M wird aus allen Gründen in dieser Tabelle zur Community-Standarddatei:4,89 Bits/Gewichte, mit einem Backlog von 30% von F16, was 2,4 mal schneller ist.Bis zu Q8 0 verdoppelt sich das Volumen und sinkt um 30%, und die Qualität ändert sich, die meisten Menschen nicht kennen; bis zu IQ1 S ist das Volumen etwas geringer und die Qualitätsrisiken sind viel höher.
Wie lesen Sie Ihren Namen?
- Königin = regelmäßige Quantifizierung;IQ = Die Wesentlichkeitsmatrix wird quantifiziert (i-quant), mit besserer Qualität und etwas langsamerer Geschwindigkeit in den gleichen Ziffern.
- Anzahl = Zielziffern. Q4 ist 4 Bit, Q8 ist 8 Bit.
- K = k-Quant, Blockquantifizierung (blockweise), älter
_0/_1Die Serie ist detaillierter. - S/M/L = kleiner/medialer/großer, gemischter Präzisionsschlitz.M nimmt einige der empfindlichen Deckel heraus, um sie hoch zu halten.Also ist es auch Q4, K M ist etwas größer als K S.
Es gibt eine andere Tatsache, die viele Menschen nicht wissen:Die Quantifizierung kann fallweise angepasst werden.Offizielle Tools unterstützen die Bezeichnung verschiedener Typen nach Typen, wie zum Beispiel: attn_v und ffn_down Setzt separat als Q5 K M, während der Rest als Q4 K M beibehalten wird; unterstützt auch die Einstellung durch eine reguläre Batch-Nummer. Und deshalb unterscheidet sich derselbe Dateityp "Q4 K M" von der Größe der Datei, die die Leute unter Druck setzen.Es ist eine Standardstrategie, keine genaue Spezifikation.
VI. MTP: Ein kleines Modul namens "Guess next word"
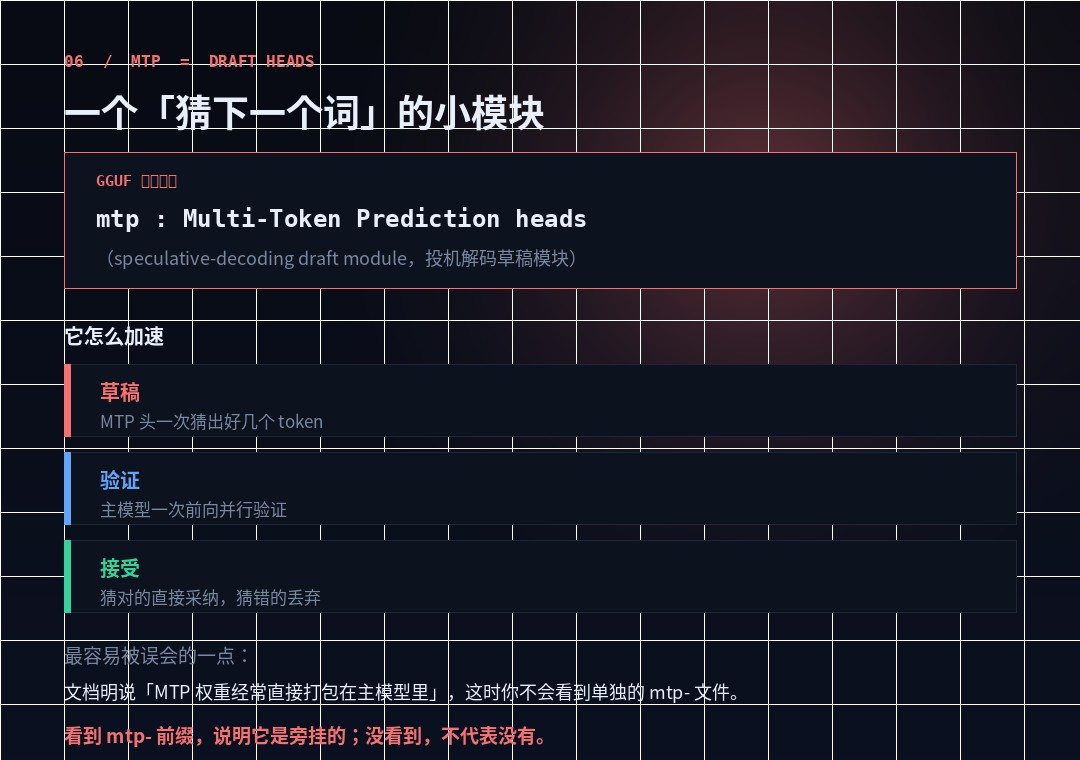
Es ist das letzte, das als Modell einfach zu verwenden ist.File Role TagIch weiß es nicht. Im GGF-Dokument mtp Definiert als Sidecar (begleitetes Modul), mit folgenden Worten:
Multi-Token Predation Header, Entwurfsmodul für spekulatives Dekodieren, entworfen, um mit Basismodellen geladen zu werden, die Architektur und Versionen entsprechen.
Es ist ganz einfach:Lassen Sie uns die nächsten Token erraten und das Hauptmodell parallel laufen lassen.Richtige direkte Adoption, falscher Tropfen. Da die Überprüfung immer mehrere Token bestätigen kann, ist der durchschnittliche Zeitabfall pro Token das ganze Prinzip der spekulativen Dekodierung.
Aber es gibt einen Satz in dem Dokument, der in diesem Abschnitt am meisten in Erinnerung bleiben sollte:"MTP-Gewichte werden oft direkt in Basismodelle gepackt, in diesem Fall gibt es keine separate mtp-seitige Datei."
Das richtige Verständnis ist also:Ja. mtp- Präfixe, die anzeigen, dass sie auf der Außenseite sind; keine gesehen, bedeutet nicht keine.Deshalb ist die Suche nach MTP in der Modellliste oft nicht gefunden - es ist bereits in der Hauptdatei.
Das andere Sidecar ist... mmproj(multimodaler Projektor, multimodularer Projektor), visueller und Audio-Encoder sowie Projektionsschicht.Dies ist normalerweise ein eigenständiges Dokument, das mit einem Basismodell geladen werden muss.Wenn Sie also ein Multi-Mode-Modell des GGF ablegen und herausfinden, dass Sie die Karte nicht sehen können, fehlt wahrscheinlich die mmproj-Datei.
VII. Vollständiges Lesen von fünf Zeichen
All dies ist eine vollständige Lektüre. Angenommen, Sie sehen diesen Dateinamen:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| Snippet | Welche Etage ist das? | Anmerkungen |
|---|---|---|
mtp- | Dateirolle | Das beigefügte spekulative Dekodierungsmodul muss mit dem Hauptmodell übereinstimmen |
Qwen3 | Modellkennung | Name des Basismodells |
30B | Größe | Parameter insgesamt 30 Mrd. EUR Ich habe beschlossen, nicht so zu tun. |
A3B | Berechnen | Drei Milliarden auf einmal. Wie schnell hast du dich entschieden zu laufen? |
v1.0 | Fassung | Gewichtung |
Q4_K_M | Lagerung | 4,89 Bit/Gewicht, mittlere Mischungsgenauigkeit |
.gguf | Container | Auf llama.cpp. |
Zusammenfassung des Dokuments:Ein Gesamtparameter von 30 Milliarden und ein MoE-Modell von 3 Milliarden gleichzeitig wurden mit einem zusätzlichen spekulativen decodierten Beschleunigungsmodul auf etwa 4,9 Stellen in den GGUUF-Container gedrückt.
VIII. Vier der häufigsten Fehlinterpretationen
- Betrachten Sie A3B als 3B-Modell.Es ist kein Gedächtnis. 30B hat nicht weniger Gewicht und 4GB ist immer noch sichtbar.
- E4B als "4B Small Model".Es ist der größte Satz von elastischen Modellen. E4B enthält alle Parameter von E2B. Low-fit auf sie drücken 2B, nicht 4B laufen.
- Verwenden Sie GGF als Modell.Das gleiche Modell kann F16, Q8 0, Q4 K M mehrere GGUUFs sein.GGUF ist ein Container und Quantifizierung ist Inhalt."Q4 und GGUF gut" zu fragen ist wie "Die Flasche und das Wasser gut".
- Dieser Beitrag ist Teil unserer Sonderberichterstattung über die Proteste in Syrien 2011.Die offizielle Erklärung, dass der Deal nicht ganz lesbar ist. Schreiben Sie nicht die reguläre Regel, um auf die Metadaten der Datei mit genauen Informationen zuzugreifen.
Und es gibt eine versteckte fünfte:Putz 8x7B Lesen Sie 7B.Das sind "8 Experten pro 7B." Insgesamt 56B. In GGUF <expertCount>x<count> Das x ist die Multiplikation.
IX. ZWECK DER PRAKTISCHEN ANPASSUNGEN
Geben Sie schließlich eine Sequenz an, die befolgt werden kann. Schauen Sie sich einen beliebigen Modellnamen an und fragen Sie sich in dieser Reihenfolge:
- Schauen Sie sich zuerst Container an und quantifizieren Sie.
.gguf+Q4_K_MDies bedeutet, dass es sich um eine lokale Run-off-Massenversion handelt und die Qualität und das Volumen bereits zum Zeitpunkt der Veröffentlichung festgelegt sind. - Lesen Sie die Gesamtparameter noch einmal.Entscheiden Sie, ob Ihre Anwesenheit / RAM ausreichend ist. Es ist eine harte Schwelle. Es ist nicht genug.
- Sehen Sie, ob es Moe ist.Ja.
A??BDie Beschreibung basiert auf Aktivierungsparametern, aber der Speicher basiert immer noch auf Gesamtparametern. - Sehen Sie, ob es ein E-Präfix gibt.Ja.
EDies deutet darauf hin, dass es sich um ein elastisches Modell handelt und dass das tatsächliche Vorhandensein deutlich unter dem Nennwert liegen kann - dies bestimmt, ob es auf das Mobiltelefon zugreifen kann. - Letzter Blick auf Sidecar.Ja.
mmproj-Denk daran, zusammen zu kommen; ja.mtp-Denken Sie daran, Matching; Es bedeutet auch nicht, dass es keine Beschleunigung gibt.
Der Modellname ist keine Parametertabelle, sondern ein Label. Das Label arbeitet, um Sie von der nächsten falschen Datei fernzuhalten, nicht um seine Punktzahl zu berechnen.
Es läuft immer. Aber um das Etikett richtig zu lesen, wissen Sie zumindest, bevor Sie das 15-GB herunterladen, dass es nicht installiert werden kann ...Dies sparte Zeit, mehr als jeder Benchmark-Score.