
B, GGUF, MTP, A3B, E4B: Los cinco caracteres en el nombre del modelo, no uno. Sí.
Empecemos con una conclusión que salva la mitad de la confusión:Estas cinco cosas no son en todas las mismas dimensiones.B es la palabra, A3B y E4B es la "cuantidad", GGUF es el contenedor, MTP es el plugin. De hecho, responden a una pregunta completamente diferente.
La división específica del trabajo es la siguiente:"B", "Cuán grande", "A3B", "Cuánto trabajo", "E4B", "cuánto es realmente en la memoria", "GGUF", "Lo que hay en ella", "MTP", "cómo se acelera".Cuatro o cinco documentos aparecen simultáneamente porque sí necesitan ser expresados simultáneamente, pero la confusión ocurre a menudo cuando se tratan como el mismo tipo de información.
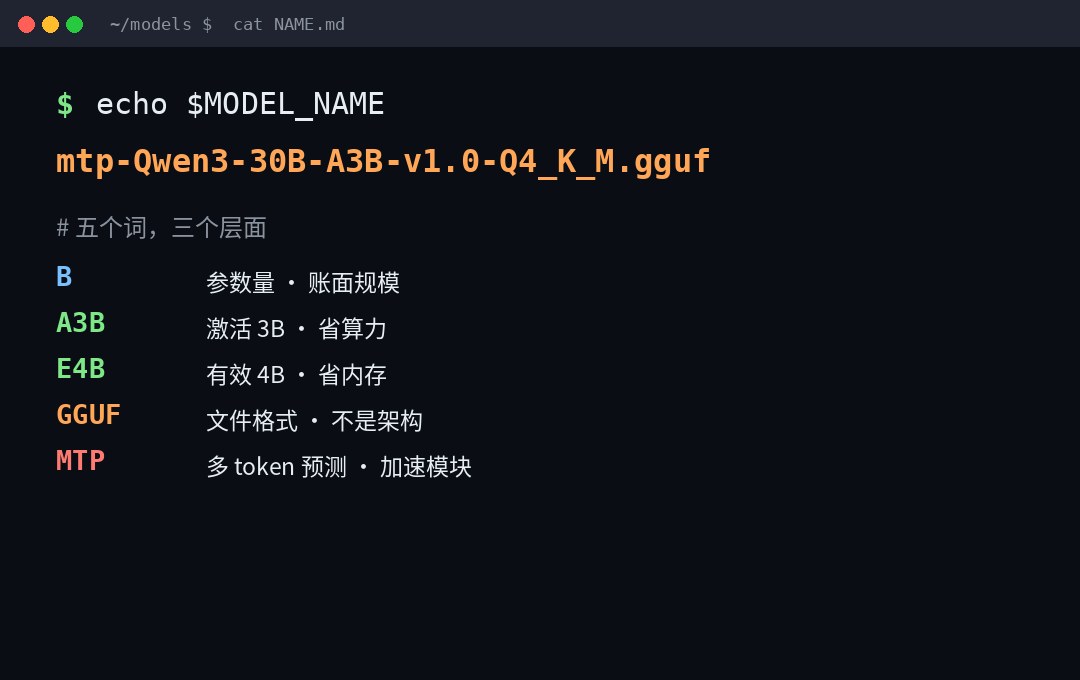
Uno, B: Son sólo mil millones.
B es Billion, mil millones.7B Es un parámetro de 7 mil millones de dólares.235B Son 235 mil millones. Es un conjunto de prefijos de escala en el código de nombre GGUF:K MilesM Millones,B Mil millones.T billones de dólares,Q Billones.
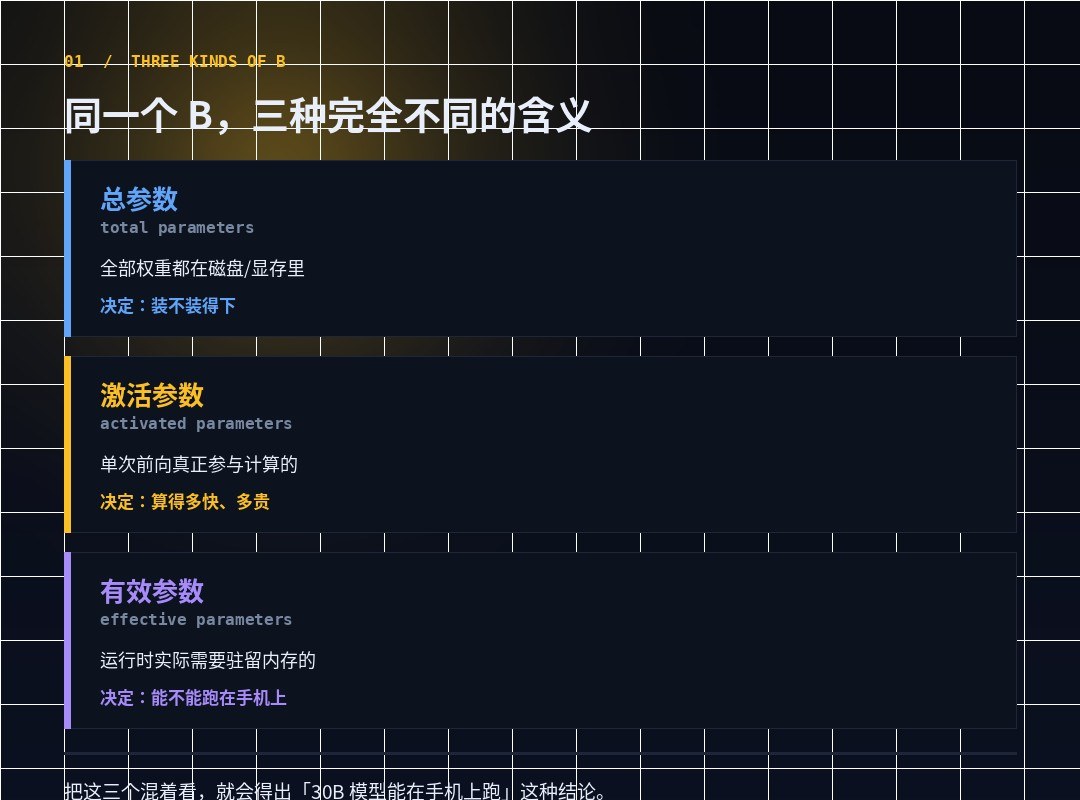
Parece el más simple, en realidad tiene tres significados completamente diferentes. Esta es la primera cosa que debe ser clara:
| Escritura | Significado | ¿Decidir qué? |
|---|---|---|
30B | Parámetros generales: peso total | ¿Puedes tocarlo?(Disk, visible) |
30B-A3B | Total 30B, activación única 3B | ¿Qué tan rápido? ¿Cuán caro? |
E4B | Parámetros válidos: presencia real en el momento de la operación | ¿Puedes correr por teléfono? |
Si miras estas tres líneas juntas, obtendrás la conclusión de que el modelo 30B puede funcionar en un teléfono celular.Puede ser correcto, pero no es lo mismo que el 30B que creías que era.
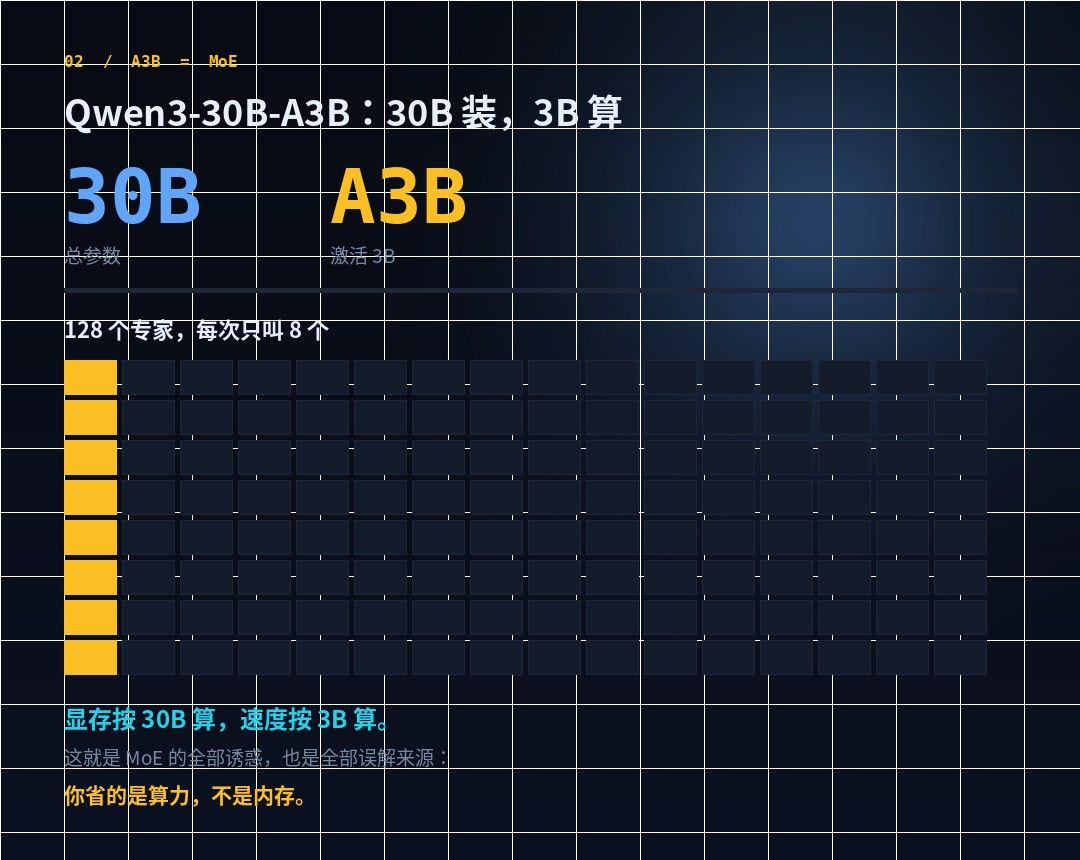
II. A3B: Los parámetros generales y los parámetros de activación no son una vez Sí.
Esto es de MoE. Qwen3 es muy claro sobre los nombres de los modelos:Qwen3-235B-A22B es un gran modelo de "233.5 mil millones de parámetros totales, 22 mil millones de parámetros activados", y Qwen3-30B-A3B es un pequeño MoE de "30 mil millones de parámetros totales, 3 mil millones de parámetros activados".
Los detalles técnicos también son específicos: 30B-A3B tiene 48 plantas, Q/KV cabeza cuenta 32/48 de 128 especialistas activados, contexto 128K. 235B-A22B es 94a planta, 64/4 cabeza, también 128 expertos activados 8.
Así que, A3B, el significado real de esta marca es:Pantallas 30B, velocidad 3B.
Esa es toda la tentación del MoE, todas las fuentes de malentendido.Estás ahorrando dinero, no memoria.Mucha gente ve A3B y piensa que es un modelo 3B, cargado en una máquina 4GB, y luego encuentra imposible cargar. Ninguno de los pesos son pequeños, pero no todos los cálculos de avance.
Junto con una escritura fácil de ignorar: SizeLabel of GGF es <expertCount>x<count><scale-prefix>*Y así* 8x7B Esto se llama "8 expertos x 7B", para un total de 56B.Eso es una elipsis de multiplicación o una multiplicación.Mixtral-8x7B es a menudo malinterpretado como un "modelo 7B" y el parámetro total real es 56B.
III. E4B:E es effictive, no "smaller"
Este es uno de los más fáciles de leer por completo. El documento de Gemma 3n es claro:
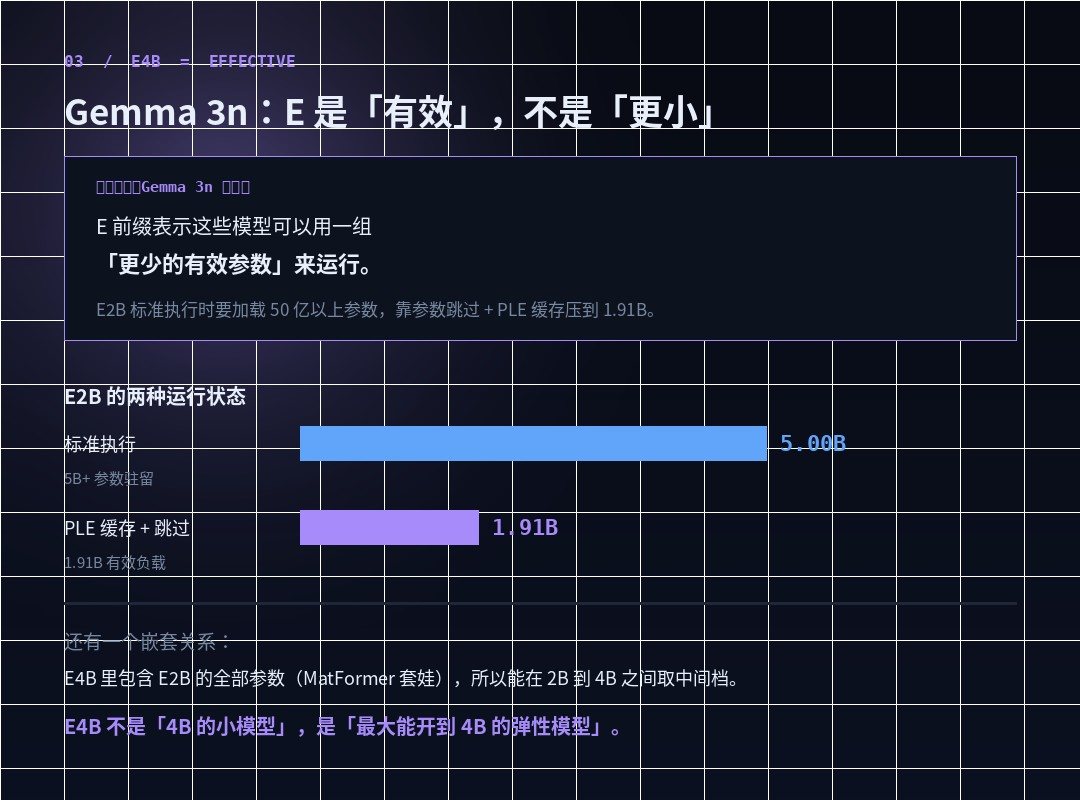
Marcas de parámetros para el modelo Gemma 3n (p. ej. E2B, E4B)Menos queLa cantidad total de parámetros efectivamente incluidos en el modelo. E prefijo indica que estos modelos pueden ejecutarse con un conjunto de "menos parámetros activos".
¿En qué medida? El documento da el número:Los estándares E2B se implementan cargando más de 5 mil millones de parámetros, saltando y cachés PLE por parámetros para presionar la carga de memoria activa a 1.91B.
Note las palabras principales de esta frase:El modelo en sí no se ha vuelto más pequeño, se ha vuelto más pequeño en términos de su presencia mientras se ejecuta.
Esto puede lograrse mediante dos mecanismos:
- PLE Cache (Per-Layer Embeding).Cada capa de parámetros incrustados se puede generar separadamente de la memoria modelo, caché a un almacenamiento local rápido, y se añade a cada capa cuando se ejecuta.Esto es igual a pedir esta parte del parámetro fuera de la memoria.
- MatFormer.Hay varios modelos pequeños incrustados dentro de un modelo grande, que no necesitan activar los parámetros externos cuando se deduce. Así que puede tomar cualquier medio entre 2B y 4B.
Esto conduce a un hecho contraintuitivo:E4B contiene todos los parámetros E2B.No dos modelos independientes, dos ranuras para el mismo modelo elástico. Así que el término exacto no es "E4B es un pequeño modelo 4B" sino "E4B".E4B es un modelo elástico con potencia máxima de 4B.No es que vaya a ninguna parte.
Esto tiene un gran impacto en el juicio de que "puedo correr en mi equipo":E4B puede funcionar como E2B en equipos de bajo nivel y expandirse a 4B en equipos de alto nivel.Y A3B no tiene esta elasticidad... es 30B, es sólo ahorro de costos.
IV. GGUUF: No es un modelo, es una caja modelo.
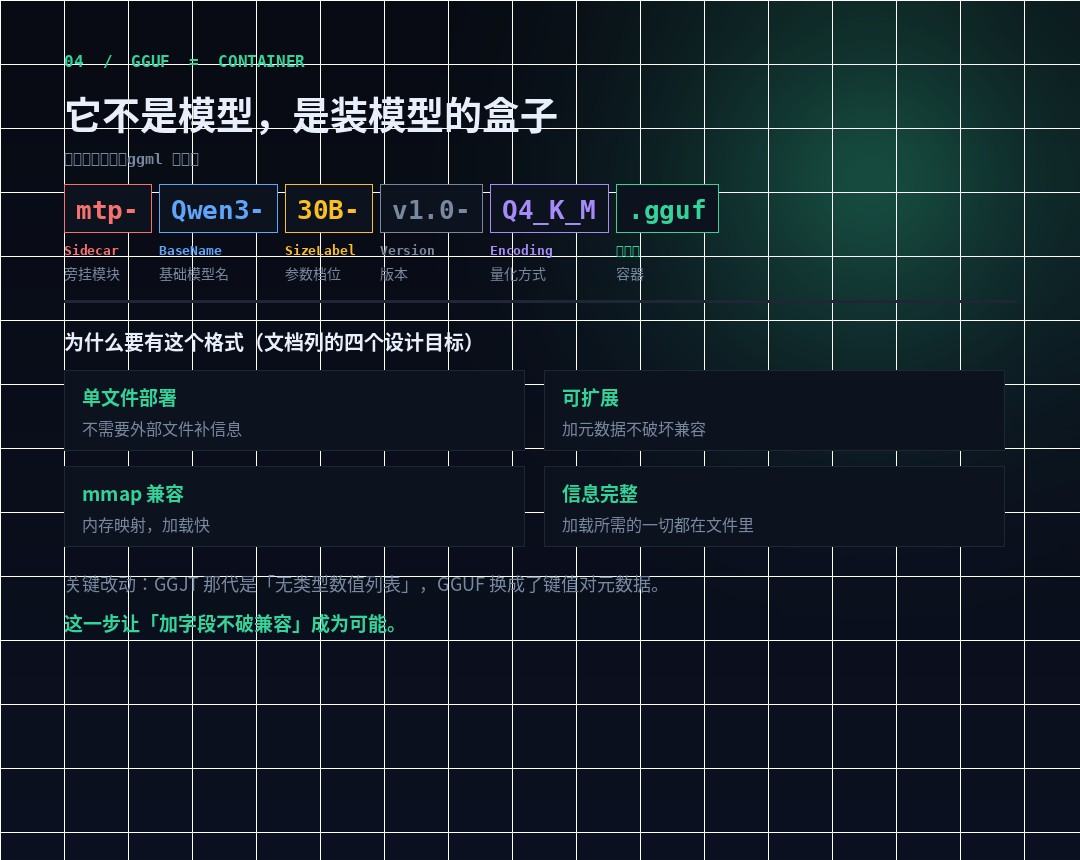
Los tres primeros son el tamaño del modelo, que ha cambiado las dimensiones de GGUF:Este es el formato de archivo.Para ser precisos, GGUUF es un formato de almacenamiento modelo para GGML y su implementador (llama.cpp).
Sustituye a GGML, GGMF, GGJT, formato de tres generaciones. Los objetivos oficiales de diseño son cuatro, cada uno de los cuales corresponde a un punto de dolor pasado:
| Objetivos de diseño | ¿Tratar con qué? |
|---|---|
| Implementación de un archivo único | No se requiere documentación adicional, distribución directa y carga |
| Ampliable | Agregar nuevos metadatos no socava la compatibilidad de los viejos modelos |
mmap Compatibilidad | Mapa de memoria Cargando, rápido |
| Información completa | Todo lo que necesitas cargar está en el archivo. Los usuarios no tienen que suministrarlo. |
La diferencia clave entre ella y la última generación de GGJT es sólo una frase, pero es la clave:El hiperparametro se cambia de una lista de valores sin tipo a una clave para los metadatos.Este paso hizo posible "add field incompatibility" — una vez añadido un campo, todos los viejos solvers tuvieron que ser cambiados.
¿Cómo lo deletreaste?
El código oficial de nominación es:
[].ggufTome un ejemplo real.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-• Sidecar (modulo por línea, ver la siguiente sección)Qwen3→ BaseName (nombre modelo básico)27B→ SizeLabel (per ranura del parámetro)v1.0Versión (versión)Q4_K_MCodificación (codificación/cuantificación del peso)
Hay dos componentes que a menudo no parecen ser conocidos:
- Escribe.:
LoRASignifica que es un adaptador, no un modelo completo;vocabindica el archivo de vocabulario. - Shad.:
00003-of-00009Muestra la fracción, 3 de 9 Atención.La numeración comienza en 00001No 00000.
También hay una importante descargo en la norma:Se llama "no va a ser completamente descifrable en el salvaje"., porque el archivo gguf existente es demasiado diverso.Así que no escribas una conjetura regular de lo que está en el nombre del archivo, lea metadatos.Archivo general.basenameNo lo sé.general.size_labelNo lo sé.general.finetune Es autoridad.
V. Q4 K M: La parte más larga del nombre del archivo es la tasa de compresión
Este es el que más afecta su experiencia en la práctica, y el que nadie ha dejado claro.Indica cuánto peso se ha cuantificado.
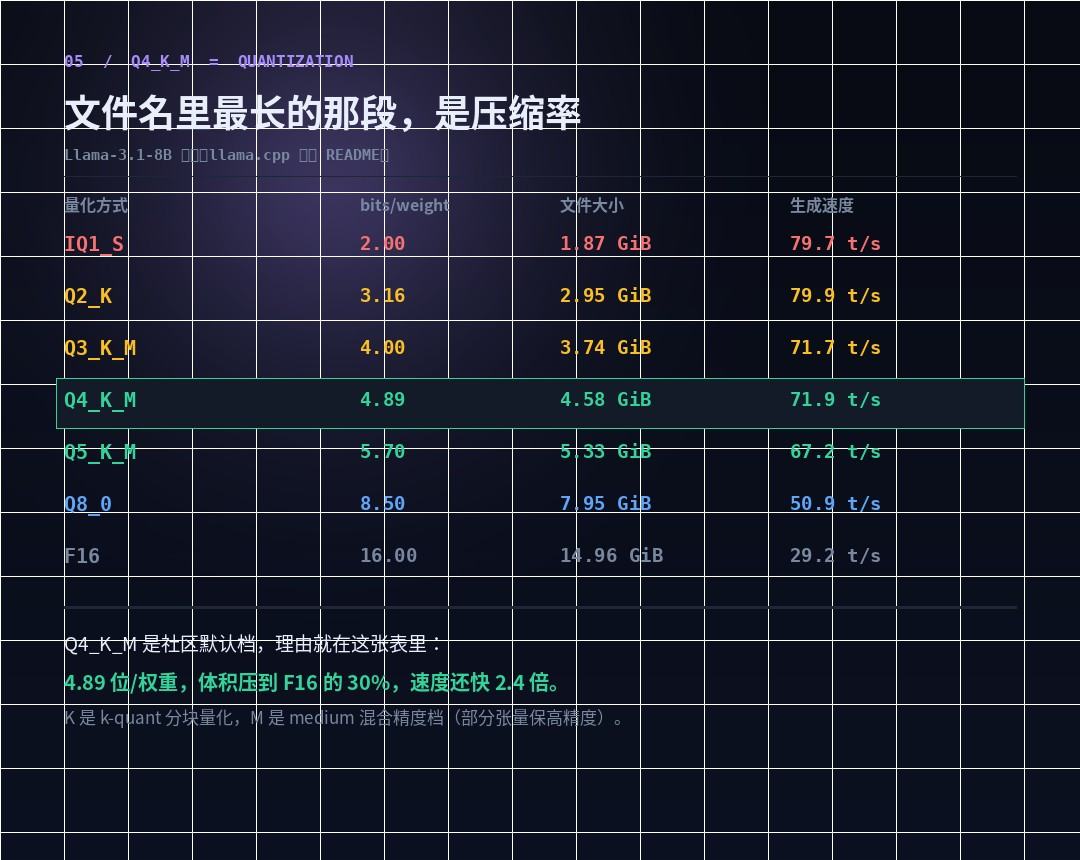
Llama.cpp El README oficial utilizó Llama-3.1-8B para hacer una encuesta fáctica, y tomé un par de pasos (modelo original 32.1 GB):
| Cuantificación | bits/right | Tamaño del archivo | Generar velocidad |
|---|---|---|---|
| IQ1 S | 2.00 | 1.87 GiB | 79,7 t/s |
| Q2 K | 3.16 | 2.95 GiB | 79,9 t/s |
| Q3 K M | 4.00 | 3.74 GiB | 71,7 t/s |
| Q4 K M | 4.89 | 4.58 GiB | 71,9 t/s |
| Q5 K M | 5.70 | 5.33 GiB | 67.2 t/s |
| Q8 0 | 8.50 | 7.95 GiB | 50,9 t/s |
| F16 | 16.00 | 14.96 GiB | 29.2 t/s |
Q4 K M se convierte en el archivo predeterminado de la comunidad por todas las razones en esta tabla:4.89 Bits/weights, con un atraso del 30% de F16, que es 2.4 veces más rápido.Hasta Q8 0, el volumen se duplica y baja en un 30%, y la calidad cambia la mayoría de la gente no lo sabe; hasta IQ1 S, el volumen es un poco menos, y los riesgos de calidad son mucho más altos.
¿Cómo lees tu nombre?
- Reina = cuantificación periódica;IQ = La matriz de materialidad se cuantifica (i-quant), con mejor calidad y velocidad ligeramente más lenta en los mismos dígitos.
- Números = dígitos de destino. Q4 es 4 bits, Q8 es 8 bits.
- K = k-quant, cuadra de cuantificación (block-wise), mayor
_0/_1La serie es más detallada. - S / M / L = pequeña/media/grande, ranura de precisión mixta.M elige algunas de las tapas sensibles para mantenerlas altas.Así que también es Q4, K M es un poco más grande que K S.
Hay otro hecho que muchas personas no saben:La cuantificación se puede personalizar caso por caso.Las herramientas oficiales apoyan la designación de diferentes tipos por tipo, tales como: attn_v y ffn_down Se establece por separado como Q5 K M, mientras que el resto se mantiene como Q4 K M; también admite el ajuste por un número de lote regular. Y por eso el mismo tipo de archivo "Q4 K M" es diferente del tamaño del archivo que la gente presiona.Es una estrategia predeterminada, no una especificación precisa.
VI. MTP: Un pequeño módulo llamado "Guess next word"
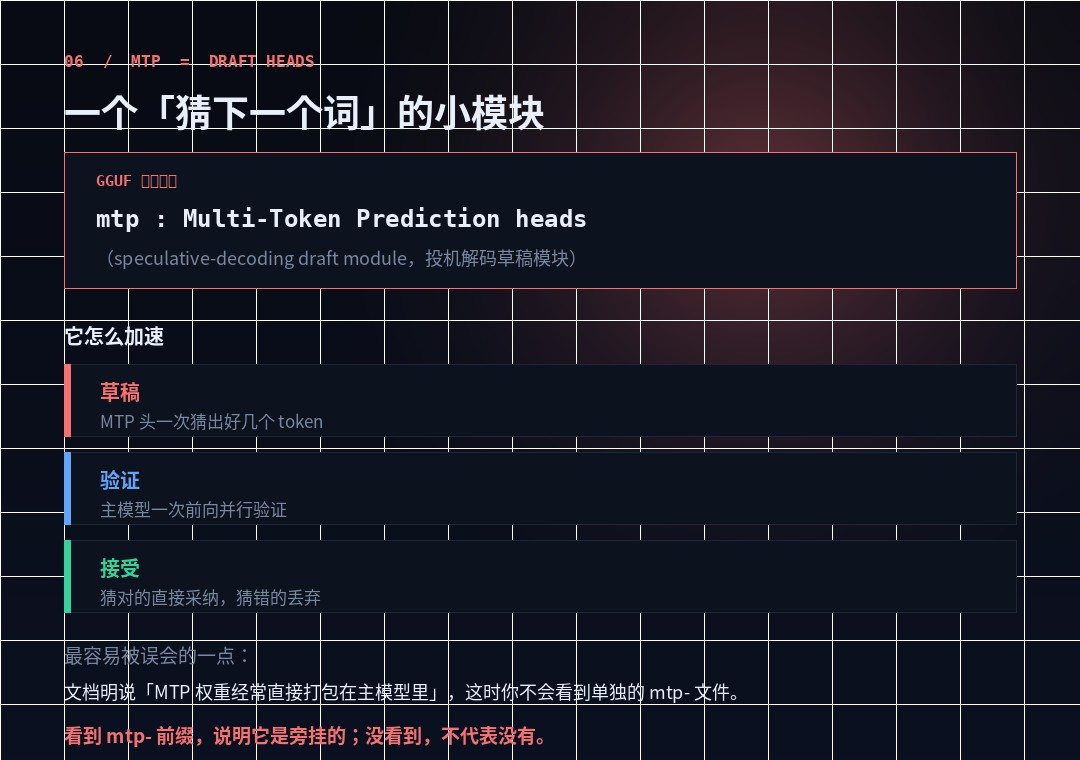
Es el último que es fácil de usar como modelo, en realidad.TagNo lo sé. En el documento GGF mtp Definido como Sidecar (módulo acompañado), indicando:
Multi-Token Predation Headers, proyecto de módulo para decodificación especulativa, diseñado para ser cargado con modelos de base que coinciden con la arquitectura y versiones.
Es simple:Vamos a adivinar los siguientes tokens, y dejar que el modelo principal funcione en paralelo.La adopción directa correcta, la caída equivocada. Debido a que la verificación siempre puede confirmar múltiples fichas, la caída promedio del tiempo por token -- este es el principio completo de decodificación especulativa.
Pero hay una frase en el documento que debe ser más recordada en esta sección:"Los pesos MTP son a menudo empaquetados directamente en modelos básicos, en cuyo caso no hay un archivo mtp-side separado".
Así que el entendimiento correcto es:Sí. mtp- Prefijos, indicando que están en el exterior; ninguno visto, no significa nada.Es por eso que buscar MTP en la lista de modelos a menudo no se encuentra -- ya está en el archivo principal.
El otro Sidecar es... mmproj(proyector multimodular, proyector multimodular), encoder visual y de audio más capa de proyección.Este es generalmente un documento independiente que debe ser cargado con un modelo base.Así que si bajas un modelo multimodo del GGF y descubres que no puedes ver el mapa, es probable que se pierda el archivo mmproj.
VII. Lectura completa de cinco caracteres
Todo lo anterior es una lectura completa. Supongamos que vea este nombre de archivo:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| Snippet | ¿Qué piso es? | Anotaciones |
|---|---|---|
mtp- | Papel del archivo | El módulo de descodificación especulativa adjunto necesita coincidir con el modelo principal |
Qwen3 | Identidad modelo | Nombre del modelo de base |
30B | Tamaño | Parámetro total He decidido no fingir. |
A3B | Cálculo | Tres mil millones por vez. ¿Qué tan rápido has decidido correr? |
v1.0 | Versión | Versión de peso |
Q4_K_M | Almacenamiento | 4.89 bits/peso, precisión de mezcla media |
.gguf | Containers | A llama.cpp. |
Un resumen del documento:Un parámetro total de 30 mil millones y un modelo MoE de 3 mil millones a la vez fue presionado a aproximadamente 4,9 lugares en el contenedor GGUUF, con un módulo de aceleración decodificado especulativo adicional.
VIII. Cuatro de los más comunes
- Considere A3B como un modelo 3B.No es memoria. 30B no tiene menos peso, y 4GB sigue siendo visible.
- E4B como un "modelo pequeño de 4B".Es el conjunto más grande de modelos elásticos. E4B contiene todos los parámetros de E2B. Low-fit on it press 2B, no 4B run.
- Use GGF como modelo.El mismo modelo puede ser F16, Q8 0, Q4 K M varios GGUUFs.GGUF es un contenedor y la cuantificación es contenido.Preguntar "Q4 y GGUF bueno" es como preguntar "La botella y el agua buena".
- Este post es parte de nuestra cobertura especial Siria Protests 2011.La declaración oficial de que el acuerdo no es totalmente legible. No escriba la regla regular para acceder a los metadatos del archivo con información precisa.
Y hay un quinto escondido:Put 8x7B Lea 7B.Eso es "8 expertos cada 7B". Total 56B. In GGUF <expertCount>x<count> El x es la multiplicación.
IX. PURPOSE OF PRACTICAL ADJUSTMENTS
Finalmente, da una secuencia que se puede seguir. Mira cualquier nombre de modelo y pregúntate en este orden:
- Primero mire los contenedores y cuantifique.
.gguf+Q4_K_MEsto significa que es una versión de masa local, y la calidad y el volumen ya están fijados en el momento de la liberación. - Lea los parámetros generales de nuevo.Decide si su presencia/RAM es suficiente. Es un umbral difícil. No es suficiente.
- A ver si es Moe.Sí.
A??BLa descripción se basa en parámetros de activación, pero la memoria sigue basada en parámetros totales. - A ver si hay un prefijo de E.Sí.
EEsto indica que es un modelo elástico y que la presencia real puede estar bien por debajo del valor nominal - esto determina si puede acceder al teléfono celular. - Última mirada a Sidecar.Sí.
mmproj-Recuerden unirse; sí.mtp-Recuerde que coincide; tampoco significa que no haya aceleración.
El nombre del modelo no es una tabla de parámetro, sino una etiqueta. La etiqueta funciona para mantenerte alejado del siguiente archivo incorrecto, no para calcular su puntuación.
Siempre funciona. Pero para leer correctamente la etiqueta, al menos sabrás antes de descargar el 15-GB que no se puede instalar...Este ahorro de tiempo, más que cualquier puntaje de referencia.