
B, GGUF, MTP, A3B, E4B: De fem tecknen i modellnamnet, inte en. Ja.
Låt oss börja med en slutsats som sparar hälften av förvirringen:Dessa fem saker är inte alla samma dimensioner.B är ordet, A3B och E4B är "kvantiteten", GGUF är behållaren, MTP är plugin. Faktum är att de svarar på en helt annan fråga.
Den specifika arbetsdelningen är följande:"B", "Hur stor", "A3B", "Hur mycket arbete", "E4B", "hur mycket är verkligen i minnet", "GGUF", "Vad är i det", "MTP", "hur accelererar det."Fyra eller fem dokument visas samtidigt eftersom de behöver uttryckas samtidigt - men förvirring uppstår ofta när de behandlas som samma typ av information.
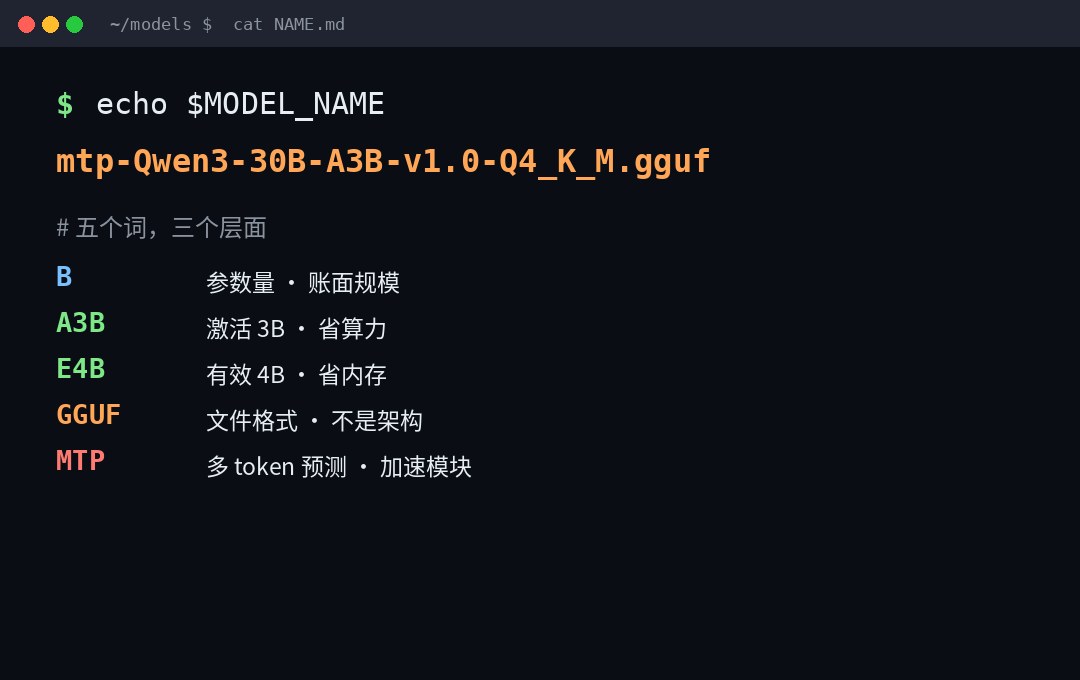
B: Det är bara en miljard.
B är Billion, en miljard.7B Det är en 7 miljarder dollar parameter.235B Det är 235 miljarder. Det är en uppsättning av skala prefix i GGUF namnkod:K tusentalsM miljoner,B En miljard.T biljoner dollar,Q miljarder.
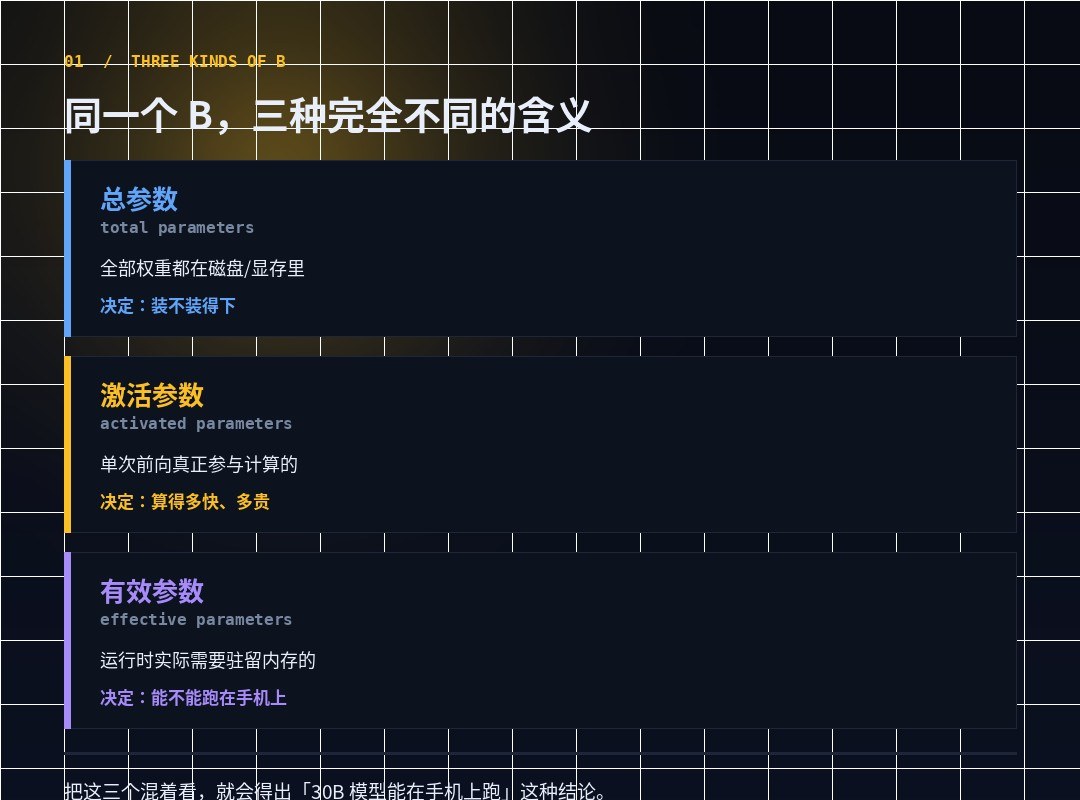
Ser ut som den enklaste, faktiskt har tre helt olika betydelser. Detta är det första som bör vara klart:
| Skriva | Betydelse | Bestäm vad? |
|---|---|---|
30B | Totala parametrar: full vikt | Kan du spela det?(disk, synlig) |
30B-A3B | Totalt 30B, enstaka aktivering 3B | Hur snabbt? Hur dyrt? |
E4B | Giltiga parametrar: faktisk närvaro vid driftstillfället | Kan du springa på telefonen? |
Om du tittar på dessa tre rader tillsammans får du slutsatsen att 30B-modellen kan köras på en mobiltelefon.Det kan vara rätt, men det är inte detsamma som 30B du trodde att det var.
A3B: Allmänna parametrar och aktiveringsparametrar är inte en gång Ja.
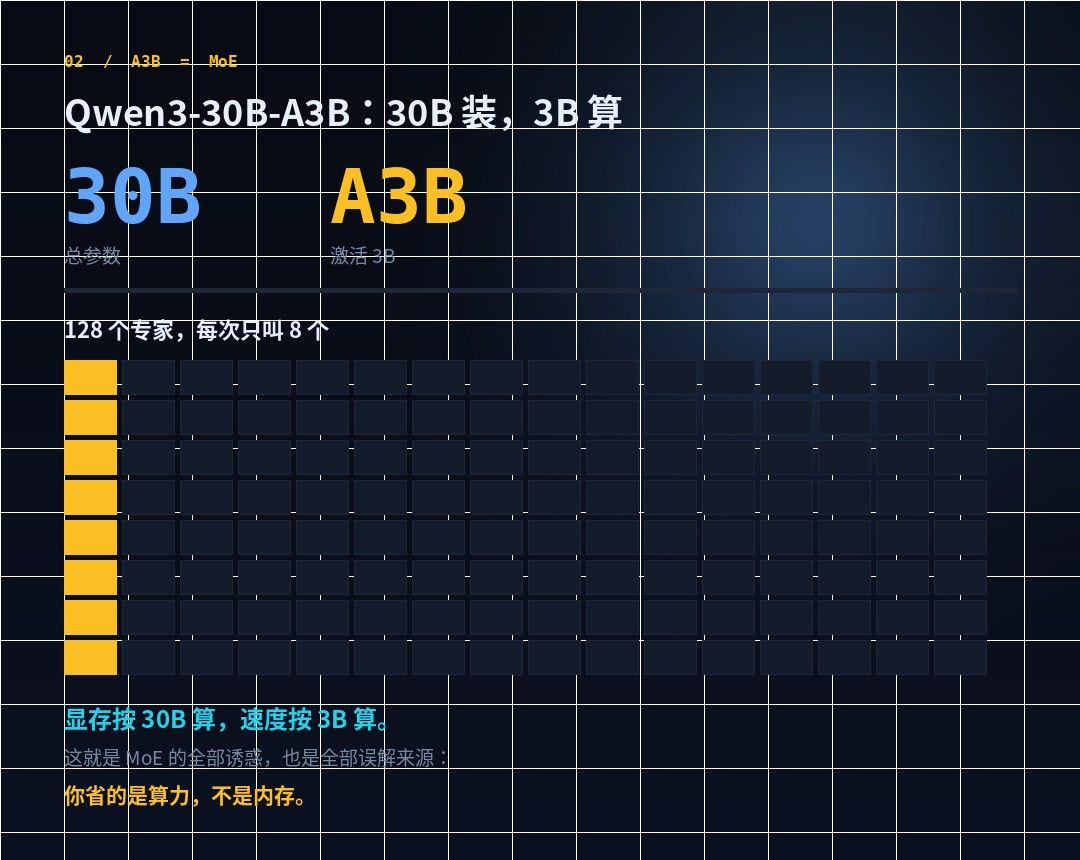
Detta är från MoE. Qwen3 är mycket tydligt om modellernas namn:Qwen3-235B-A22B är en stor modell av "233,5 miljarder totala parametrar, 22 miljarder aktiverade parametrar", och Qwen3-30B-A3B är en liten MoE av "30 miljarder totala parametrar, 3 miljarder aktiverade parametrar".
Tekniska detaljer är också specifika: 30B-A3B har 48 våningar, Q/KV huvudräkning 32/48 av 128 specialister aktiveradeKontext 128K. 235B-A22B är 94:e våningen, 64/4 huvud, även 128 experter aktiverade 8.
A3B, den faktiska betydelsen av detta varumärke är:Visar 30B, hastighet 3B.
Det är all frestelse av MoE, alla källor till missförstånd.Du sparar pengar, inte minne.Många ser A3B och tycker att det är en 3B-modell, laddad på en 4GB-maskin och sedan hitta det omöjligt att ladda. Ingen av vikterna är liten, men inte alla framåtberäkningar.
Tillsammans med en lätt att ignorera skriva: SizeLabel of GGF är <expertCount>x<count><scale-prefix>Och så << 8x7B Detta kallas "8 experter x 7B", för totalt 56B.Det är antingen en multiplikation ellipsis eller en multiplikation.Mixtral-8x7B tolkas ofta som en "7B-modell" och den faktiska totala parametern är 56B.
III. E4B:E är effektiv, inte "smaller"
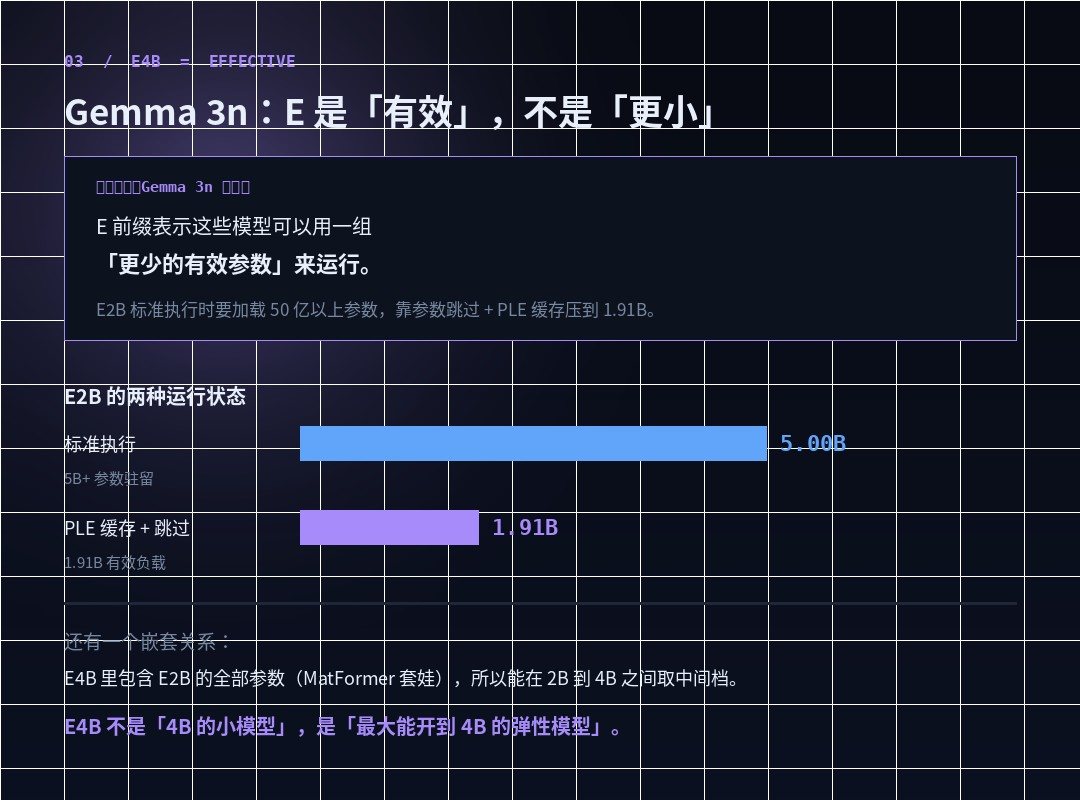
Detta är en av de enklaste att läsa helt. Gemma 3ns dokument är tydligt:
Parametermärken för Gemma 3n-modellen (t.ex. E2B, E4B)Mindre änDen totala mängden parametrar som faktiskt ingår i modellen. E prefix indikerar att dessa modeller kan köras med en uppsättning "mindre aktiva parametrar".
I vilken utsträckning? Dokumentet ger numret:E2B-standarder implementeras genom att ladda mer än 5 miljarder parametrar, hoppa och PLE-cacher med parametrar för att trycka på den aktiva minnesbelastningen till 1,91B.
Notera huvudorden i denna mening:Själva modellen har inte blivit mindre, den har blivit mindre när det gäller dess närvaro under körning.
Detta kan uppnås genom två mekanismer:
- PLE Cache (Per-Layer Embeding).Varje lager av inbäddade parametrar kan genereras separat från modellminnet, cachas till en snabb lokal lagring och läggs till i varje lager när du kör.Detta är lika med att fråga denna del av parametern ur minnet.
- MatFormer.Det finns flera små modeller inbäddade i en stor modell, som inte behöver aktivera yttre parametrar när de härleds. Du kan ta mellan 2B och 4B.
Detta leder till ett kontraintuitivt faktum:E4B innehåller alla E2B-parametrar.Inte två fristående modeller, två slots för samma elastiska modell. Så den exakta termen är inte "E4B är en 4B liten modell" utan "E4B".E4B är en elastisk modell med maximal effekt som går till 4B.Det är inte som att jag går någonstans.
Detta har stor betydelse för domen att "kan jag köra på min utrustning":E4B kan köra E2B-liknande på utrustning med låg utrustning och expandera till 4B på utrustning med hög utrustning.Och A3B har inte denna elasticitet - det är 30B, det är bara kostnadsbesparande.
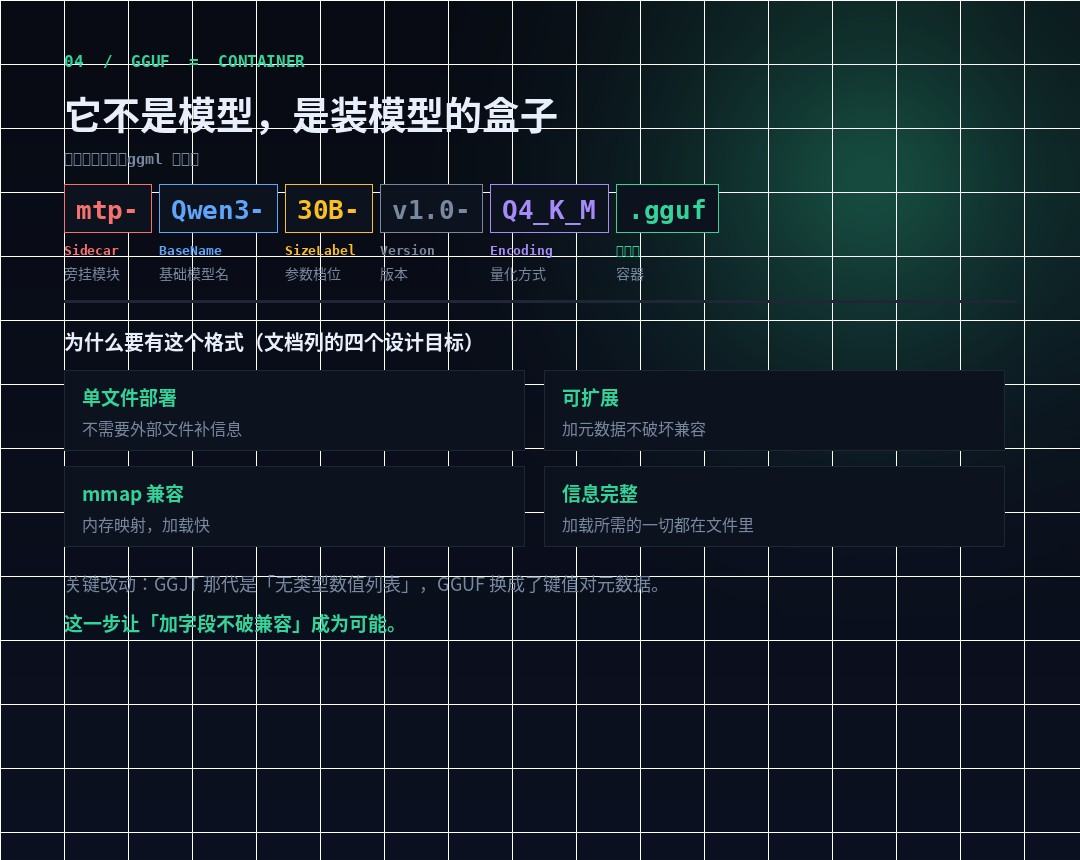
GGUUF: Det är inte en modell, det är en modelllåda.
De tre första är storleken på modellen, som har ändrat dimensionerna från GGUF:Detta är filformatet.För att vara exakt är GGUUF ett modelllagringsformat för GGML och dess implementer (llama.cpp).
Den ersätter GGML, GGMF, GGJT, tre generationsformat. De officiella designmålen är fyra, var och en motsvarar en tidigare smärtpunkt:
| Designmål | Hantera vad? |
|---|---|
| Enstaka filutplacering | Ingen ytterligare dokumentation krävs, direkt distribution och lastning |
| Expandable | Att lägga till nya metadata undergräver inte kompatibiliteten hos gamla modeller |
mmap Kompatibilitet | Memory Map Loading, snabb |
| Fullständig information | Allt du behöver ladda är i filen. Användare behöver inte leverera den. |
Den viktigaste skillnaden mellan den och den sista generationen av GGJT är bara en mening, men det är nyckeln:Hyperparametern ändras från en lista med värden utan typ till en nyckel till metadata.Detta steg gjorde det möjligt att "lägga fältinkompatibilitet" - när ett fält hade lagts till måste alla gamla lösare ändras.
Hur stavade du det?
Den officiella namnkoden är:
[].ggufTa ett riktigt exempel.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-Sidecar (bylinemodul, se nästa avsnitt)Qwen3BaseName (basmodellnamn)27BSizeLabel (parameter slot)v1.0Version (version)Q4_K_MKodning (viktkodning/kvantifiering)
Det finns två komponenter som inte ofta verkar vara kända:
- Typ.Från:
LoRADet betyder att det är en adapter, inte en komplett modell.vocabanger ordförrådsfilen. - Shad.Från:
00003-of-00009Visar fraktionen, 3: e av 9 uppmärksamhet.Nummer börjar på 00001Inte 00000.
Det finns också en viktig friskrivning i normen:Det kallas "inte kommer att vara helt dechiffrerbart i det vilda."Eftersom den befintliga gguffilen är för varierande.Så skriv inte en regelbunden gissning av vad som finns i filnamnet, läs metadata.Fil general.basenameJag vet inte.general.size_labelJag vet inte.general.finetune Det är auktoritet.
V. Q4 K M: Den längsta delen av filnamnet är kompressionshastigheten
Detta är den som mest påverkar din upplevelse i praktiken, och den som ingen har gjort klart.Det indikerar hur mycket vikt har kvantifierats.
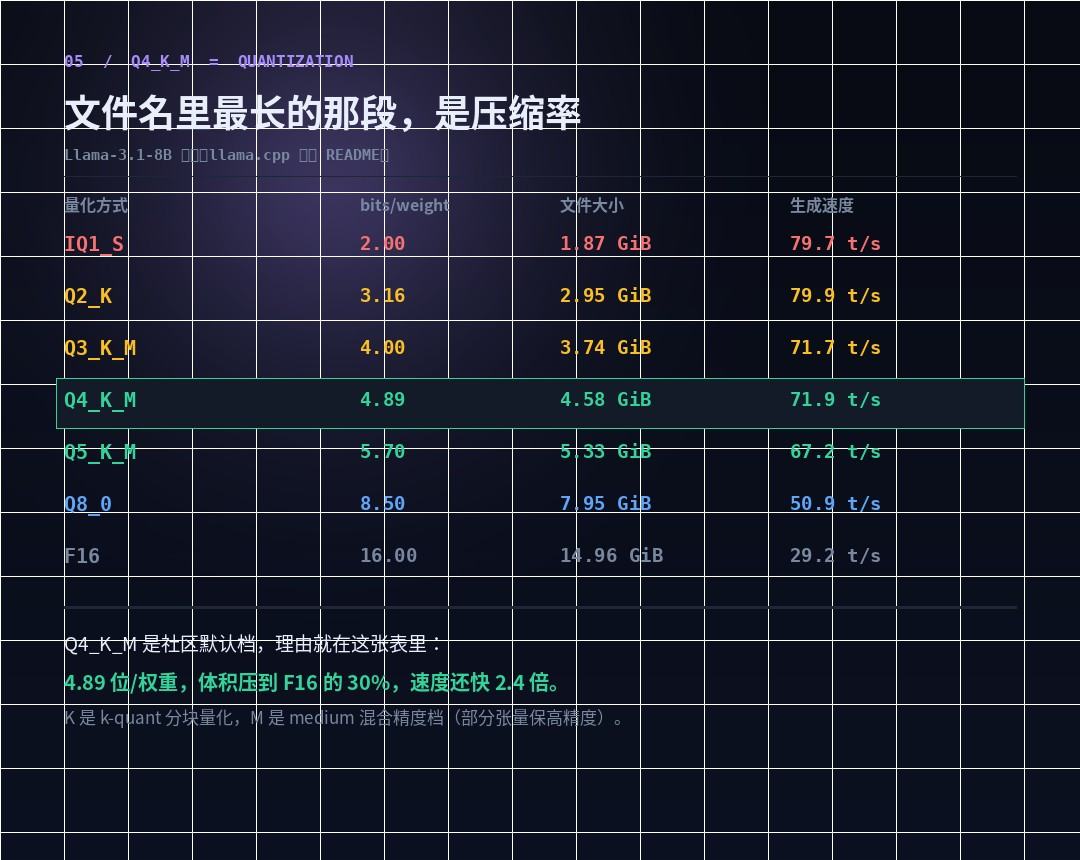
llama.cpp Officiell README använde Llama-3.1-8B för att göra en faktisk undersökning, och jag tog ett par steg (ursprunglig modell 32.1 GB):
| Kvantifiering | bits/höger | Filstorlek | Generera hastighet |
|---|---|---|---|
| IQ1 S | 2.00 | 1.87 GiB | 79,7 t/s |
| Q2 K | 3.16 | 2.95 GiB | 79,9 t/s |
| Q3 K M | 4.00 | 3.74 GiB | 71,7 t/s |
| Q4 K M | 4.89 | 4,58 GiB | 71,9 t/s |
| Q5 K M | 5.70 | 5.33 GiB | 67.2 t/s |
| Q8 0 | 8.50 | 7,95 GiB | 50,9 t/s |
| F16 | 16.00 | 14.96 GiB | 29.2 t/s |
Q4 K M blir community default-filen av alla anledningar i denna tabell:4.89 Bits / vikter, med en eftersläpning på 30% av F16, vilket är 2,4 gånger snabbare.Upp till Q8 0, volymen dubblar och sjunker med 30%, och de kvalitetsförändringar som de flesta inte vet; ner till IQ1 S, är volymen lite mindre, och kvalitetsrisken är mycket högre.
Hur läser du ditt namn?
- Drottning = Regelbunden kvantifiering;IQ = Materialitetsmatrisen är kvantifierad (i-kvant), med bättre kvalitet och något långsammare hastighet i samma siffror.
- Nummer = målsiffror. Q4 är 4 bit, Q8 är 8 bitar.
- Källa K = k-quant, block kvantifiering (block-wise), äldre
_0/_1Serien är mer detaljerad. - S / M / L = liten/media/stor, blandad precisionsslot.M plockar ut några av de känsliga locken för att hålla dem höga.Så det är också Q4, K M är något större än K S.
Det finns ett annat faktum att många inte vet:Kvantifiering kan anpassas från fall till fall.Officiella verktyg stöder beteckningen av olika typer efter typ, till exempel: attn_v och ffn_down Anger separat som Q5 K M, medan resten upprätthålls som Q4 K M, stöder också inställning med ett vanligt partinummer. Och det är därför samma "Q4 K M" typ av fil skiljer sig från storleken på den fil som människor trycker på.Det är en standardstrategi, inte en exakt specifikation.
MTP: En liten modul som kallas "Gyssa nästa ord"
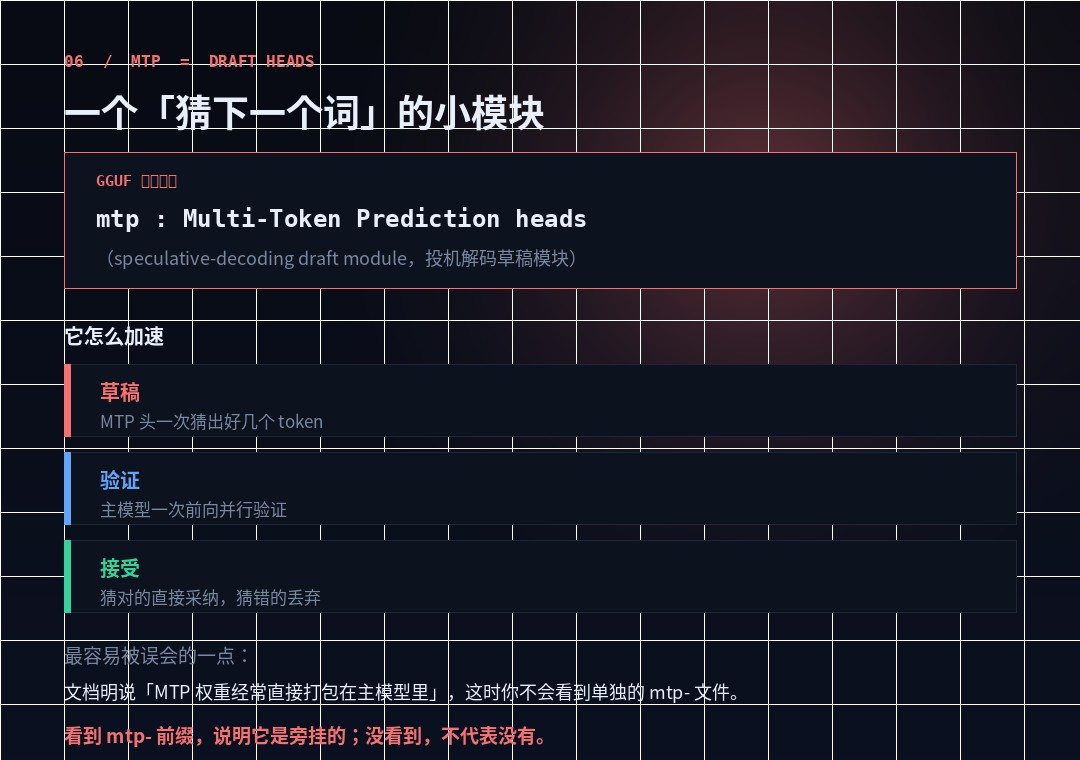
Det är den sista som är lätt att använda som modell, faktiskt.File Role TagJag vet inte. I GGF dokumentet mtp Definieras som Sidecar (följande modul), säger:
Multi-Token Predation Headers, utkast till modul för spekulativ avkodning, utformad för att laddas med basmodeller som matchar arkitektur och versioner.
Det är enkelt:Låt oss gissa de närmaste tokens, och låt huvudmodellen springa parallellt.Rätt direkt adoption, fel droppe. Eftersom verifiering alltid kan bekräfta flera tokens, den genomsnittliga nedgången i tid per token - detta är hela principen om spekulativ avkodning.
Men det finns en fras i dokumentet som bör komma ihåg mest i detta avsnitt:"MTP vikter är ofta packade direkt i grundläggande modeller, i vilket fall det inte finns någon separat mtp-side fil."
Så rätt förståelse är:Ja. mtp- Prefix, som indikerar att de är på utsidan; ingen sett betyder inte någon.Det är därför som letar efter MTP i modelllistan ofta inte hittas - det är redan i huvudfilen.
Den andra Sidecar är... mmproj(multimodal projektor, multimodulär projektor), visuell och ljudkodare plus projektionsskikt.Detta är vanligtvis ett fristående dokument som måste laddas med en basmodell.Så om du lägger ner en multi-mode-modell av GGF och du upptäcker att du inte kan se kartan, är det förmodligen saknas mmproj-filen.
VII. Full läsning av fem tecken
Allt ovanstående är en komplett läsning. Anta att du ser filnamnet:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| Snippet | Vilket golv är det? | Annotations |
|---|---|---|
mtp- | File Role | Den bifogade spekulativa avkodningsmodulen måste matcha huvudmodellen |
Qwen3 | Modell Identitet | Basmodellnamn |
30B | storlek | Totalparameter 30 miljarder Jag har bestämt mig för att inte låtsas. |
A3B | Beräkning | Tre miljarder per gång. Hur snabbt du bestämde dig för att springa? |
v1.0 | Version | Vikt Version |
Q4_K_M | Lagring | 4,89 bitar/vikt, mediumblandning precision |
.gguf | Containers | För llama.cpp. |
En sammanfattning av dokumentet:En total parameter på 30 miljarder och en MoE-modell på 3 miljarder i taget trycktes till cirka 4,9 platser i GGUUF-behållaren, med en extra spekulativ avkodad accelerationsmodul.
VIII. Fyra av de vanligaste misreads
- Tänk på A3B som en 3B-modell.Det är inte minnet. 30B har inte mindre vikt, och 4 GB är fortfarande synlig.
- E4B som en "4B liten modell".Det är den största uppsättningen elastiska modeller. E4B innehåller alla parametrar för E2B. Low-fit på pressen 2B, inte 4B-körning.
- Använd GGF som modell.Samma modell kan vara F16, Q8 0, Q4 K M flera GGUUF.GGUF är en behållare och kvantifiering är innehåll.Att fråga "Q4 och GGUF bra" är som att fråga "Flaskan och vattnet bra."
- Detta inlägg är en del av vår speciella täckning Syrien protester 2011.Det officiella uttalandet att affären inte är helt läsbar. Skriv inte regelbunden regel för att komma åt metadata av filen med korrekt information.
Och det finns en dold femte:Sätt 8x7B Läs 7B.Det är "8 experter varje 7B." Totalt 56B. I GGUF <expertCount>x<count> X är multiplikationen.
IX. Förutsättning för praktiska rättigheter
Slutligen, ge en sekvens som kan följas. Titta på något modellnamn och fråga dig själv i denna ordning:
- Först titta på behållare och kvantifiera.
.gguf+Q4_K_MDetta innebär att det är en lokal avkörning massversion, och kvaliteten och volymen är redan inställd vid tidpunkten för release. - Läs de övergripande parametrarna igen.Bestäm om din närvaro/RAM är tillräcklig. Det är en hård tröskel. Det räcker inte.
- Se om det är Moe.Ja.
A??BBeskrivning baseras på aktiveringsparametrar, men minnet är fortfarande baserat på totala parametrar. - Se om det finns ett E prefix.Ja.
EDetta indikerar att det är en elastisk modell och att den faktiska närvaron kan vara långt under det nominella värdet - detta avgör om det kan komma åt mobiltelefonen. - Senaste titt på Sidecar.Ja.
mmproj-Kom ihåg att komma samman, ja.mtp-Kom ihåg matchning; det betyder inte heller att det inte finns någon acceleration.
Modellnamn är inte ett parameterbord, utan en etikett. Etiketten fungerar för att hålla dig borta från nästa fel fil, inte för att beräkna dess poäng.
Det är alltid igång. Men för att läsa etiketten korrekt, åtminstone du vet innan du laddar ner 15-GB att det inte kan installeras.Detta sparade tid, mer än någon referenspoäng.