
B, GGUF, MTP, A3B, E4B: Os cinco caracteres no nome do modelo, não um. Sim.
Vamos começar com uma conclusão que salva metade da confusão:Estas cinco coisas não são absolutamente as mesmas dimensões.B é a palavra, A3B e E4B é a "quantidade", GGUF é o recipiente, MTP é o plugin. Na verdade, eles respondem a uma pergunta completamente diferente.
A divisão específica do trabalho é a seguinte:"B", "Quão grande", "A3B", "Quanto trabalho", "E4B", "o quanto realmente está na memória", "GGUF", "O que está nele", "MTP", "Como acelera"?Quatro ou cinco documentos aparecem simultaneamente porque precisam ser expressos simultaneamente — mas muitas vezes ocorre confusão quando são tratados como o mesmo tipo de informação.
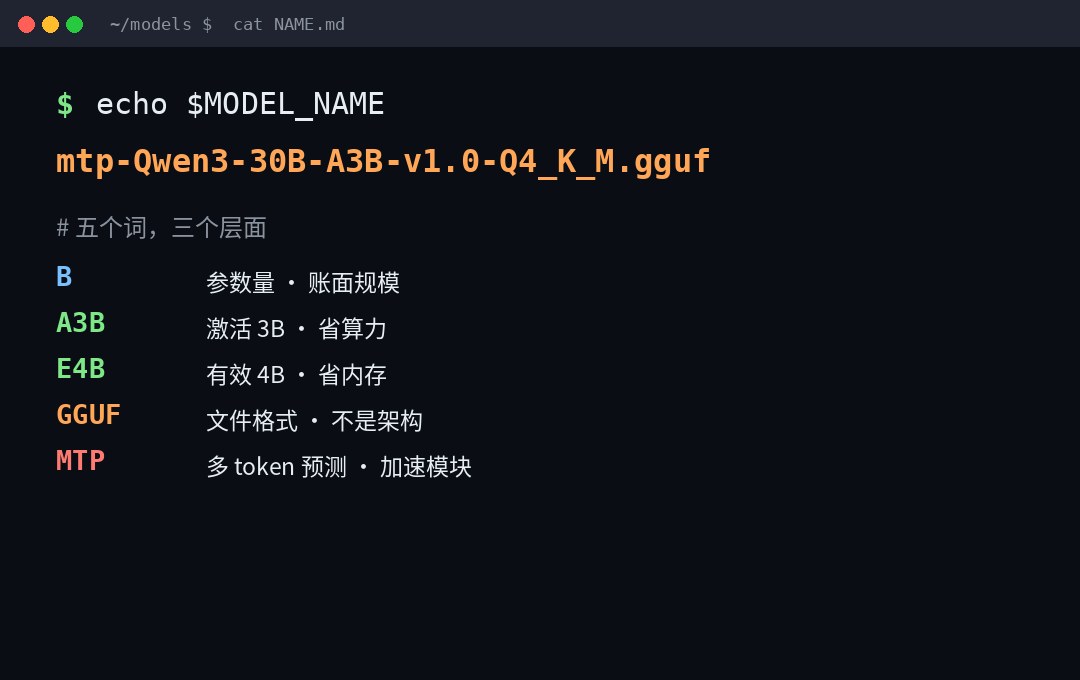
Um, B: É apenas um bilhão.
B é um bilhão, um bilhão.7B É um parâmetro de 7 bilhões de dólares.235B São 235 mil milhões. É um conjunto de prefixos de escala no código de nome GGUF:K MilharesM Milhões,B Um bilhão.T Trilhões de dólares,Q Biliões.
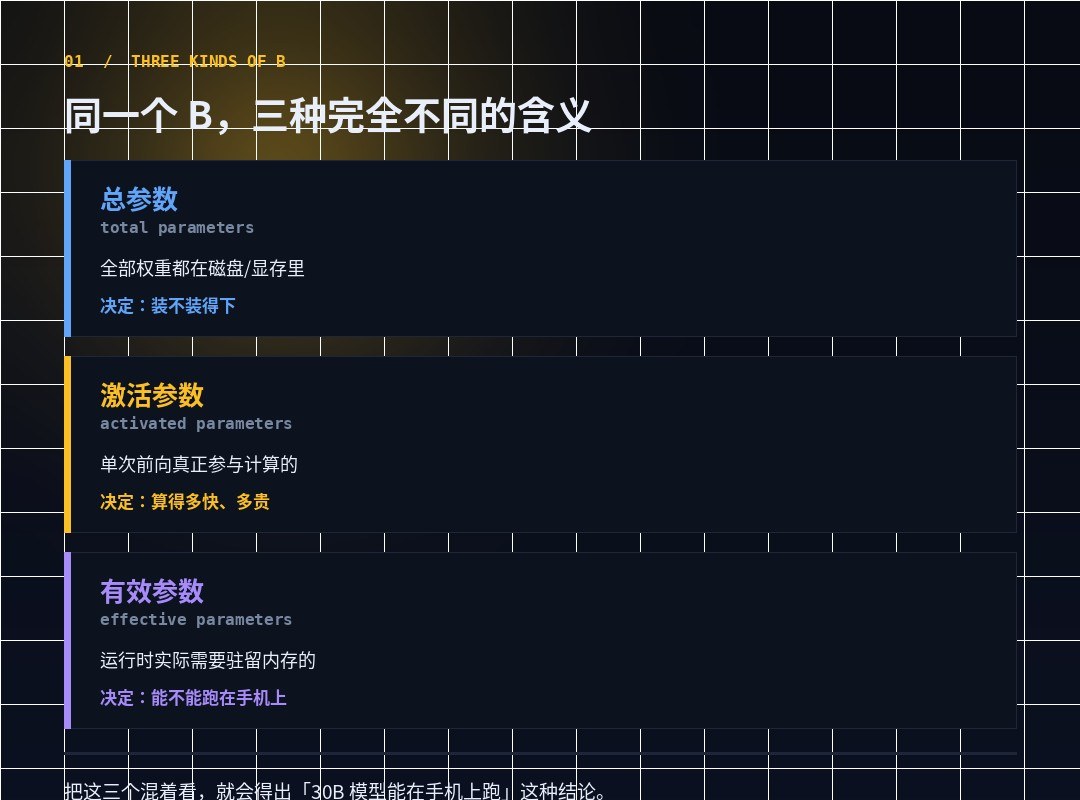
Parece o mais simples, na verdade tem três significados completamente diferentes. Esta é a primeira coisa que deve ser clara:
| Gravando | Significado | Decidir o quê? |
|---|---|---|
30B | Parâmetros globais: peso total | Podes tocar?(disque, visível) |
30B-A3B | Total 30B, ativação única 3B | Quão rápido? Quanto caro? |
E4B | Parâmetros válidos: presença real no momento da operação | Podes correr ao telefone? |
Se você olhar para estas três linhas juntos, você vai ter a conclusão de que o modelo 30B pode correr em um telefone celular.Pode estar certo, mas não é o mesmo que o 30B que você pensou que era.
II. A3B: Parâmetros gerais e parâmetros de ativação não são uma vez Sim.
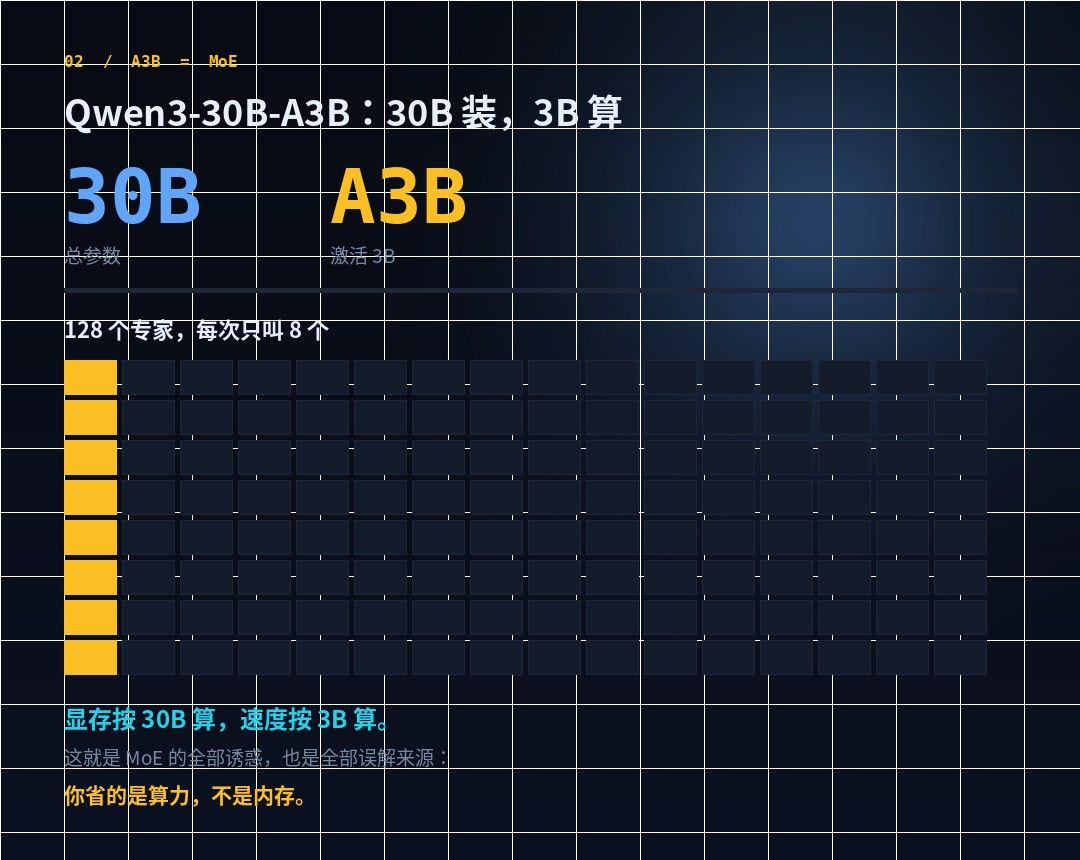
Isto é do MoE. Qwen3 é muito claro sobre os nomes dos modelos:Qwen3-235B-A22B é um grande modelo de "233,5 bilhões de parâmetros totais, 22 bilhões de parâmetros ativados", e Qwen3-30B-A3B é um pequeno MoE de "30 bilhões de parâmetros totais, 3 bilhões de parâmetros ativados".
Os detalhes técnicos também são específicos: 30B-A3B tem 48 pisos, Q/KV cabeça número 32/48 de 128 especialistas activados, contexto 128K. 235B-A22B é 94o andar, 64/4 cabeça, também 128 especialistas ativados 8.
Então, A3B, o significado real desta marca é:Exibe 30B, velocidade 3B.
Essa é toda a tentação do MoE, todas as fontes do mal-entendido.Estás a poupar dinheiro, não memória.Muitas pessoas veem A3B e acham que é um modelo 3B, carregado em uma máquina de 4GB, e então acham impossível carregar. Nenhum dos pesos é pequeno, mas nem todos os cálculos para a frente.
Junto com uma fácil de ignorar a escrita: TamanhoLabel de GGF é <expertCount>x<count><scale-prefix>E assim 8x7B Isso é chamado de "8 especialistas x 7B", para um total de 56B.Isso é uma elipse de multiplicação ou uma multiplicação.Mixtral-8x7B é muitas vezes mal interpretado como um "modelo 7B" e o parâmetro total real é 56B.
III. E4B:E é eficaz, não "menor"
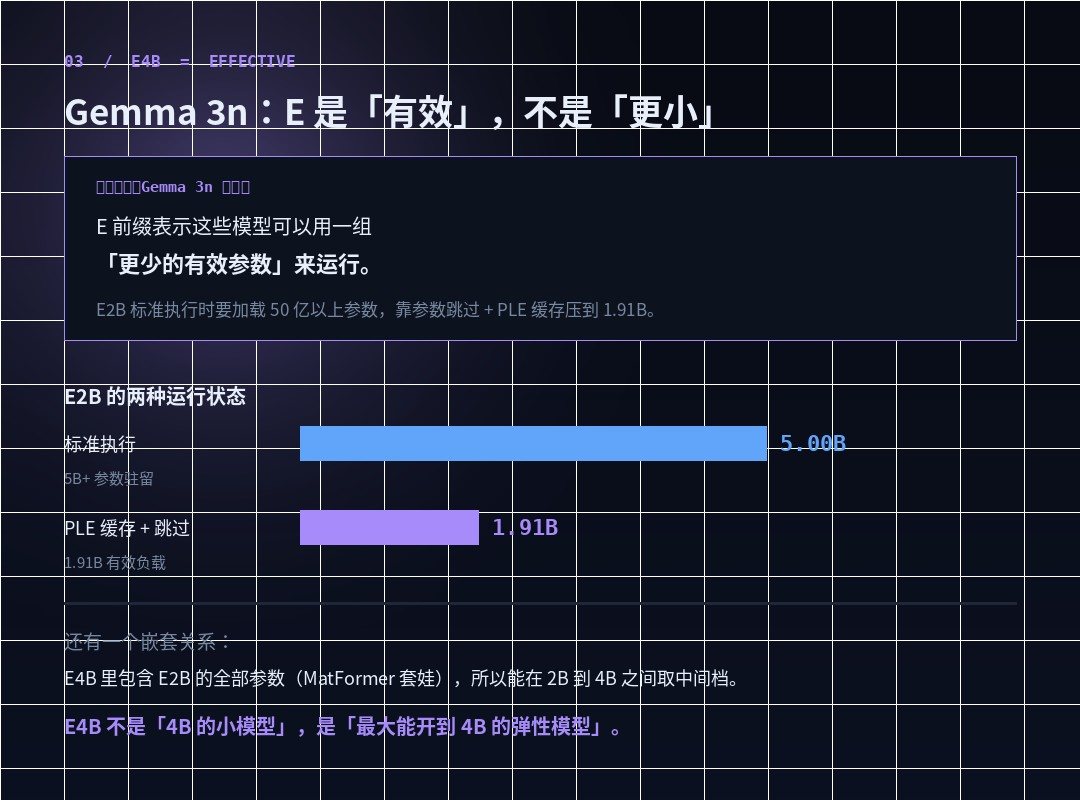
Este é um dos mais fáceis de ler completamente. O documento da Gemma 3n é claro:
Marcas de parâmetros para o modelo Gemma 3n (por exemplo E2B, E4B)Menos do queA quantidade total de parâmetros realmente incluídos no modelo. E prefixo indica que esses modelos podem ser executados com um conjunto de "parâmetros menos ativos".
Até que ponto? O documento indica o número:Os padrões E2B são implementados carregando mais de 5 bilhões de parâmetros, pulando e caches PLE por parâmetros para pressionar a carga de memória ativa para 1,91B.
Note as palavras principais desta frase:O modelo em si não se tornou menor, tornou-se menor em termos de sua presença durante a corrida.
Isto pode ser conseguido através de dois mecanismos:
- PLE Cache (Por- Camada de Incorporação).Cada camada de parâmetros embutidos pode ser gerada separadamente da memória do modelo, em cache para um armazenamento local rápido, e adicionado a cada camada quando em execução.Isto é igual a pedir esta parte do parâmetro fora da memória.
- MatFormer.Existem vários modelos pequenos incorporados dentro de um modelo grande, que não precisam ativar parâmetros externos quando deduzidos. Então você pode tomar qualquer meio entre 2B e 4B.
Isso leva a um fato contraintuitivo:E4B contém todos os parâmetros E2B.Não dois modelos autônomos, dois slots para o mesmo modelo elástico. Então o termo exato não é "E4B é um modelo pequeno 4B" mas "E4B."E4B é um modelo elástico com potência máxima indo para 4B.Não vou a lado nenhum.
Isto tem um grande impacto no julgamento de que "posso correr no meu equipamento":E4B pode executar E2B-like em equipamentos de baixo equipamento e expandir para 4B em equipamentos de alto equipamento.E A3B não tem esta elasticidade -- é 30B, é apenas economia de custos.
IV. GGUUF: Não é um modelo, é uma caixa de modelo.
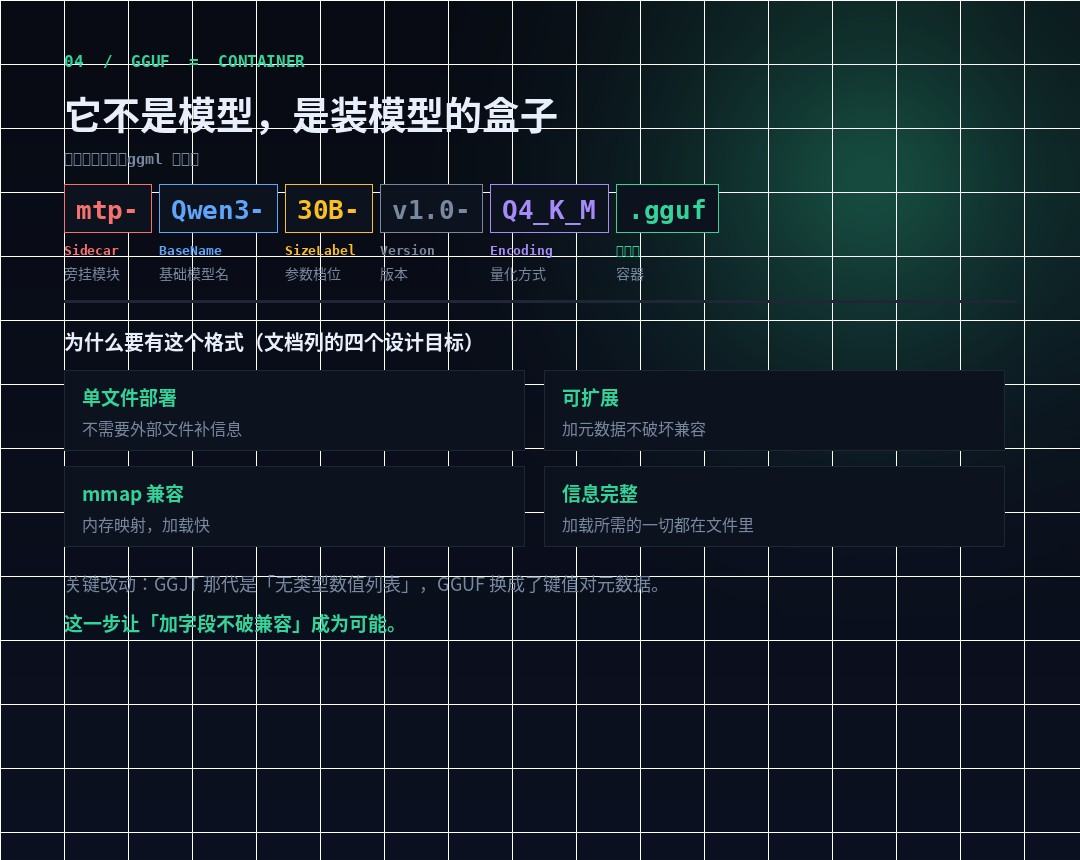
Os três primeiros são o tamanho do modelo, que mudou as dimensões da GGUF:Este é o formato do arquivo.Para ser preciso, GGUUF é um formato de armazenamento modelo para GGML e seu implementador (llama.cpp).
Substitui GGML, GGMF, GGJT, formato de três gerações. Os alvos do desenho oficial são quatro, cada um dos quais corresponde a um ponto de dor passado:
| Objectivos de concepção | Lidar com o quê? |
|---|---|
| Implementação de um único arquivo | Nenhuma documentação adicional necessária, distribuição direta e carregamento |
| Expansível | Adicionar novos metadados não prejudica a compatibilidade de modelos antigos |
mmap Compatibilidade | Mapa de Memória Carregando, rápido |
| Informação completa | Tudo o que precisas para carregar está no ficheiro. Os utilizadores não têm de o fornecer. |
A diferença chave entre ela e a última geração de GGJT é apenas uma frase, mas é a chave:O hiperparâmetro é alterado de uma lista de valores sem tipo para uma chave para metadados.Esta etapa tornou possível "adicionar incompatibilidade de campo" — uma vez que um campo tinha sido adicionado, todos os antigos solucionadores tiveram de ser mudados.
Como é que escreveste?
O código oficial de nomeação é:
[].ggufTome um exemplo real.
mtp-Qwen3-27B-v1.0-Q4_K_M.ggufmtp-• Sidecar (módulo byline, veja a próxima seção)Qwen3→ Nome da base (nome do modelo de base)27B→ TamanhoLabel (parameter slot)v1.0Versão (versão)Q4_K_MCodificação (codificação/ quantificação do peso)
Há dois componentes que não parecem ser conhecidos:
- Tipo.:
LoRASignifica que é um adaptador, não um modelo completo;vocabindica o ficheiro de vocabulário. - Shad.:
00003-of-00009Mostra a fração 3 de 9 Atenção.Numeração começa em 00001Não 00000.
Há também uma renúncia importante na norma:Chama-se "não vai ser completamente decifrável na natureza"., porque o arquivo gguf existente é muito diversificado.Então não escreva um palpite regular do que está no nome do arquivo, leia metadados.Ficheiro general.basenameNão sei.general.size_labelNão sei.general.finetune É autoridade.
V. Q4 K M: A parte mais longa do nome do arquivo é a taxa de compressão
Este é o que mais afeta sua experiência na prática, e aquele que ninguém deixou claro.Indica quanto peso foi quantificado.
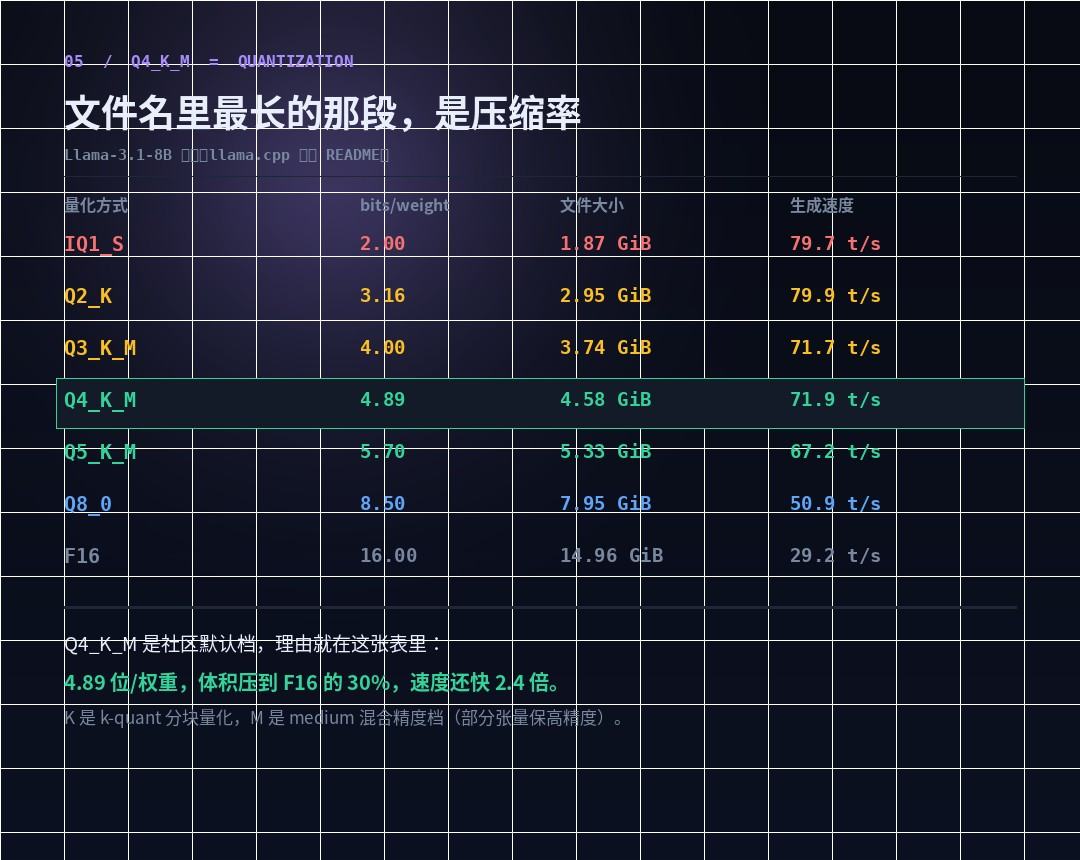
llama.cpp Official README usou o Llama-3.1-8B para fazer uma pesquisa factual, e dei alguns passos (modelo original 32,1 GB):
| Quantificação | bits/direita | Tamanho do Ficheiro | Gerar Velocidade |
|---|---|---|---|
| IQ1 S | 2.00 | 1.87 GiB | 79,7 t/s |
| Q2 K | 3.16 | 2.95 GiB | 79,9 t/s |
| Q3 K M | 4.00 | 3.74 GiB | 71, 7 t/ s |
| Q4 K M | 4.89 | 4.58 GiB | 71,9 t/s |
| Q5 K M | 5.70 | 5,33 GiB | 67,2 t/s |
| Q8 0 | 8.50 | 7.95 GiB | 50,9 t/s |
| F16 | 16.00 | 14.96 GiB | 29,2 t/s |
O Q4 K M torna- se o arquivo padrão da comunidade por todas as razões nesta tabela:4,89 Bits/pesos, com um atraso de 30% de F16, que é 2,4 vezes mais rápido.Até o Q8 0, o volume duplica e cai em 30%, e a qualidade muda a maioria das pessoas não sabe; até o IQ1 S, o volume é um pouco menor, e os riscos de qualidade são muito maiores.
Como lês o teu nome?
- Rainha = Quantificação regular;QI = A matriz de materialidade é quantificada (i-quant), com melhor qualidade e velocidade ligeiramente mais lenta nos mesmos dígitos.
- Números = algarismos-alvo. Q4 é 4 bits, Q8 é 8 bits.
- K = k-quant, quantificação do bloco (bloqueio), mais antigo
_0/_1A série é mais detalhada. - S / M / L = ranhura de precisão mista pequena/média/grande.M escolhe algumas das tampas sensíveis para mantê-las altas.Então também é Q4, K M é um pouco maior que K S.
Há outro fato que muitas pessoas não sabem:A quantificação pode ser personalizada caso a caso.As ferramentas oficiais apoiam a designação de diferentes tipos por tipo, tais como: attn_v e ffn_down Define separadamente como Q5 K M, enquanto o resto é mantido como Q4 K M; também suporta a configuração por um número de lote regular. E é por isso que o mesmo tipo de arquivo "Q4 K M" é diferente do tamanho do arquivo que as pessoas pressionam.É uma estratégia padrão, não uma especificação precisa.
VI. MTP: Um pequeno módulo chamado "Adivinha a próxima palavra"
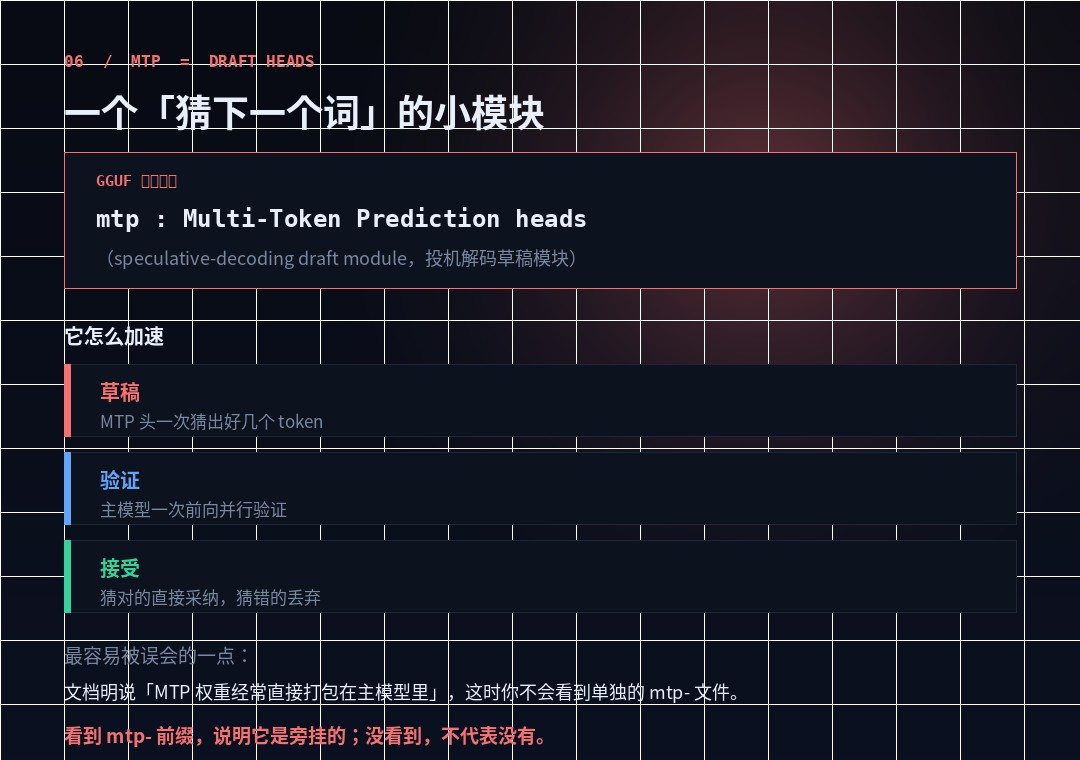
É o último que é fácil de usar como modelo, na verdade.Marca de Papel do FicheiroNão sei. No documento GGF mtp Definido como Sidecar (módulo acompanhado), indicando:
Cabeçalhos Predação Multi-Token, módulo de rascunho para decodificação especulativa, projetado para ser carregado com modelos de base que combinam arquitetura e versões.
É simples:Vamos adivinhar os próximos tokens, e deixar o modelo principal correr em paralelo.Adoção directa, entrega errada. Porque a verificação pode sempre confirmar múltiplos tokens, a queda média no tempo por token -- este é todo o princípio da decodificação especulativa.
Mas há uma frase no documento que deve ser mais lembrada nesta secção:"Os pesos MTP são frequentemente embalados diretamente em modelos básicos, neste caso não há arquivo separado mtp-side".
Portanto, o entendimento correto é:Sim. mtp- Prefixos, indicando que estão do lado de fora; nenhum visto, não significa nenhum.É por isso que procurar o MTP na lista de modelos muitas vezes não é encontrado -- ele já está no arquivo principal.
O outro Sidecar é... mmproj(projetor multimodal, projetor multimodular), codificador visual e de áudio mais camada de projeção.Este é geralmente um documento autônomo que deve ser carregado com um modelo base.Então se você colocar um modelo multi-modo do GGF e você descobrir que você não pode ver o mapa, provavelmente está faltando o arquivo mmproj.
VII. Leitura completa de cinco caracteres
Tudo o acima é uma leitura completa. Suponha que você veja este nome de arquivo:
mtp-Qwen3-30B-A3B-v1.0-Q4_K_M.gguf| Excerto | Qual é o andar? | Anotações |
|---|---|---|
mtp- | Papel do Ficheiro | O módulo de decodificação especulativa anexado precisa corresponder ao modelo principal |
Qwen3 | Identidade do modelo | Nome do modelo base |
30B | Tamanho | Parâmetro total 30 mil milhões Decidi não fingir. |
A3B | Calcular | Três mil milhões por vez. A que velocidade decidiu correr? |
v1.0 | Versão | Versão do Peso |
Q4_K_M | Armazenamento | 4,89 bits/peso, precisão média da mistura |
.gguf | Recipientes | À lhama.cpp. |
Um resumo do documento:Um parâmetro total de 30 bilhões e um modelo MoE de 3 bilhões de cada vez foi pressionado para aproximadamente 4,9 lugares no recipiente GGUUF, com um módulo de aceleração especulativo decodificado adicional.
VIII. Quatro dos erros mais comuns
- Considere A3B como um modelo 3B.Não é memória. 30B não tem menos peso, e 4GB ainda é visível.
- E4B como um "modelo pequeno 4B".É o maior conjunto de modelos elásticos. E4B contém todos os parâmetros de E2B. Baixo ajuste nele pressione 2B, não 4B execução.
- Usar GGF como modelo.O mesmo modelo pode ser F16, Q8 0, Q4 K M vários GGUUFs.GGUF é um recipiente e quantificação é o conteúdo.Perguntar "Q4 e GGUF bom" é como perguntar "A garrafa ea água boa."
- Este post faz parte da nossa cobertura especial Síria Protestos 2011.A declaração oficial de que o acordo não é inteiramente legível. Não escreva a regra regular para acessar os metadados do arquivo com informações precisas.
E há um quinto escondido:Colocar 8x7B Leia 7B.São "8 especialistas a cada 7B". Total 56B. Na GGUF <expertCount>x<count> O x é a multiplicação.
IX. OBJECTIVO DE AJUSTAMENTOS PRÁTICOS
Finalmente, dê uma sequência que pode ser seguida. Olhe para qualquer nome modelo e pergunte-se nesta ordem:
- Primeiro olhe para os contentores e quantifique.
.gguf+Q4_K_MIsso significa que é uma versão em massa de escoamento local, e a qualidade e o volume já estão definidos no momento do lançamento. - Leia os parâmetros gerais novamente.Decida se a sua presença/RAM é suficiente. É um limiar difícil. Não é suficiente.
- Vê se é o Moe.Sim.
A??BDescrição é baseada em parâmetros de ativação, mas a memória ainda é baseada em parâmetros totais. - Veja se há um prefixo E.Sim.
EIsso indica que é um modelo elástico e que a presença real pode estar bem abaixo do valor nominal - isso determina se ele pode acessar o celular. - Última olhada no Sidecar.Sim.
mmproj-Lembra-te de te juntares, sim.mtp-Lembre-se de combinar; nem significa que não há aceleração.
O nome do modelo não é uma tabela de parâmetros, mas uma etiqueta. A etiqueta funciona para mantê-lo longe do próximo arquivo errado, não para calcular sua pontuação.
Está sempre a correr. Mas para ler o rótulo corretamente, pelo menos você saberá antes de baixar os 15GB que ele não pode ser instalado...Isto economizou tempo, mais do que qualquer pontuação de benchmark.