
Digite, saída, vida de cache: o nome na conta do token de IA.
Vamos começar com os resultados:Existem apenas duas palavras nestes termos que realmente lhe custam mais: "Cacheft" e "output" token.O resto são as suas notas.
Fui faturado três vezes em dois meses, e é a mesma coisa: acho que estou economizando dinheiro, e estou pagando o preço total pelo mesmo prefixo. Esta é a que podes responder pelo menos a uma pergunta...Porque tenho 8 mil fichas na conta se só disse uma palavra?
I. Token. Porque é que os chineses são mais caros?
Token é a menor unidade para processamento de texto do modelo. Não é uma palavra. Não é uma palavra.É uma peça cortada pela semântica.Não sei. Na mesma frase, o número de blocos cortados pode diferir de modelo para código.
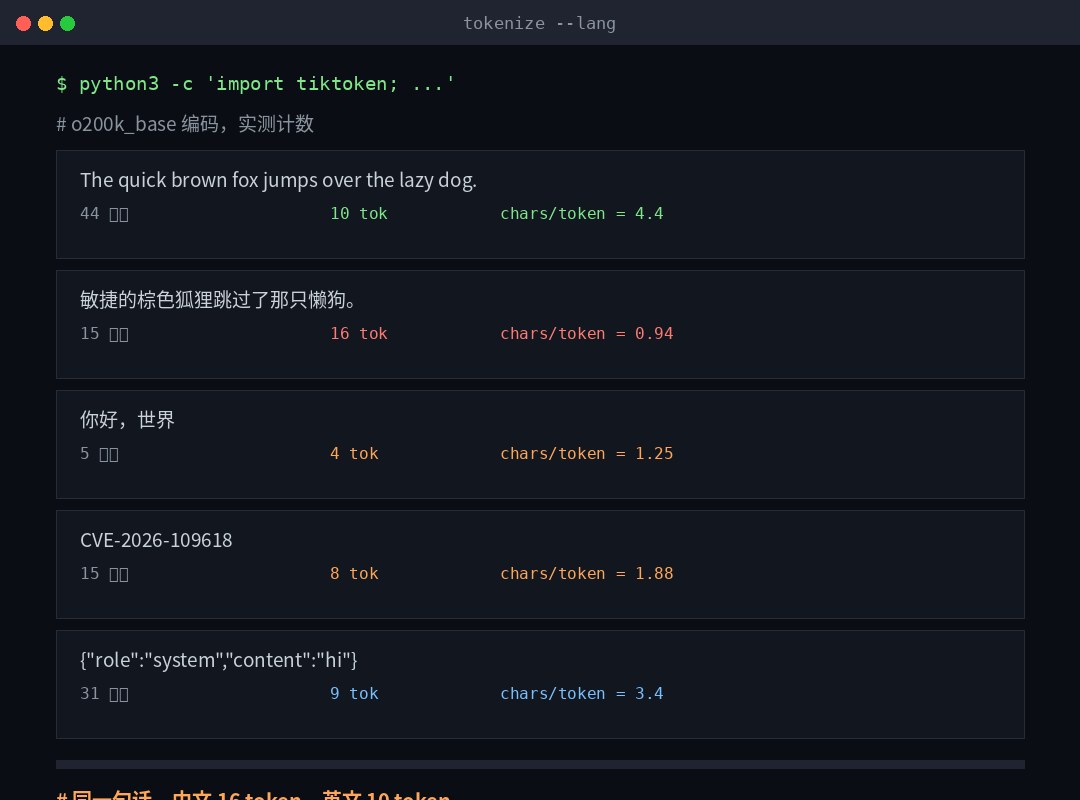
Aceito. o200k_base O código realmente mediu vários grupos e a diferença foi maior do que o esperado:
| Texto | Número de caracteres | Número do item | Caracteres |
|---|---|---|---|
| A caixa marrom rápida salta sobre o cão preguiçoso. | 44 | 10 | 4.4 |
| A rapidinha morena saltou sobre aquele cão preguiçoso. | 15 | 16 | 0.94 |
| Olá, mundo. | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
Vê o problema.Na mesma frase, 10 fichas em inglês e 16 em chinês.Cerca de 4 caracteres em inglêsUma palavra, um símboloNão sei.
Isso é muito hostil para os usuários chineses: o "caracter 1 token" é uma experiência em inglês.Vai subestimar mais da metade em chinês.
Há um contra-intuitivo:CVE-2026-109618 Este número, 15 caracteres queimam 8 fichas. Números e hífens são cortados muito mal.É muito mais caro do que parece.
Dois, um pedido, quatro parágrafos.
A primeira vez que olhei para a conta, não foi cara.É apenas uma palavra, mas 8 mil fichas.Não sei. Depois ficou claro que mais do que tu.
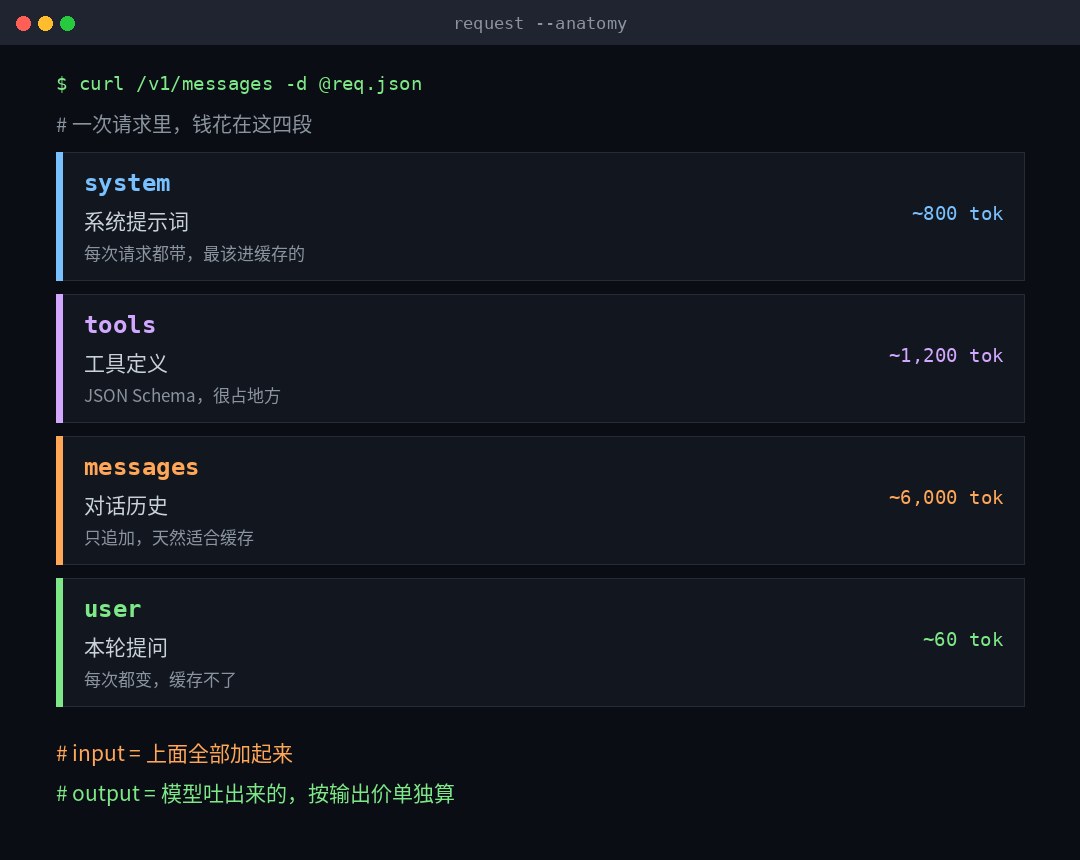
A entrada de um pedido é geralmente feita em quatro partes:
| Parágrafo | Nome Inglês | O que foi? | Vai mudar? |
|---|---|---|---|
| Dica do Sistema | Sistema / inclusão | Quem são vocês, as regras, o formato de saída? | É basicamente o mesmo. |
| Definição da Ferramenta | Acho que não. | Função JSON Esquema e descrição | Muito raramente. |
| Histórico do diálogo | Mensagens / histórico | Cada rodada de perguntas e respostas antes de você, leve todas. | Adicionar apenas |
| Perguntas para esta ronda | Desculpe, senhor. | Aquela coisa que acabaste de ligar. | Sempre. |
A primeira vez que tive medo, foi.A ferramenta define a quantidade de 1.200 tokensNão sei. Uma função com descrição de parâmetros, o Esquema JSON se expande para ter lugar especial. Você escreveu 20 ferramentas, você poderia comer 2.000 por definição.E não escreveste uma palavra nesta parte, mas está sempre carregada.
Há um ponto chave atrás dele:Os três primeiros parágrafos são “adicionais e não modificados” e o quarto parágrafo muda cada vez.Não é coincidência. Determina se o cache pode ser atingido.
Três: entrada, saída, e aquele na saída.
O calibre oficial destas três relações é o seguinte:
- Digite token (input / policy tokens): Tudo o que você envia contém os quatro parágrafos acima.
- Saída: Modelado. Atenção...Não só a mensagem que viste.
- Token (tokens de ressonância): O modelo de raciocínio é o que ele pensa antes de dar a resposta. Não consegues ver, mas...A preços de produçãoNão sei.
A terceira é a verdadeira razão para muitas pessoas duplicarem suas contas. Tenho uma espécie de trabalho com um modelo teórico, e vejo 20 palavras na resposta, e a conta é mais de 900.Aquele símbolo invisível 880, está tudo aí.
Então é normal ter uma contradição:Quanto mais curta a resposta, menos barato será.
O preço de saída é geralmente cerca de cinco vezes o preço de entrada (ver a tabela abaixo para cada família). Isto explica um princípio de integridade:Pode ser resolvido com entrada. Não o deixes sair.Coloque o modelo de resposta, o exemplo de formato, na dica do sistema (inferior), para que ele não se organize de tal forma que seja caro.
Cacheline e pouco atraente: esta é a seção do texto inteiro que deve ser lembrado
O que são?
Os modelos são contados como intermediários quando lidos. Esta parte é a mais cara.
A 'cache' imediata é um estado prefixado.Da próxima vez que encontrarmos o mesmo prefixo, vamos usá-lo diretamente e não mais recalcular.
Então, havia duas palavras:
- Cache atingido: Este prefixo foi encontrado no cache. Esta parte foi introduzida e pressionada.O desconto.Taxas.
- Falta o 'cache'Não consigo encontrá-lo. Recalcula o preço.
Os termos do golpe são mais difíceis do que pensa.
A chave é a palavra "prefixo".Não se trata da mesma pergunta.
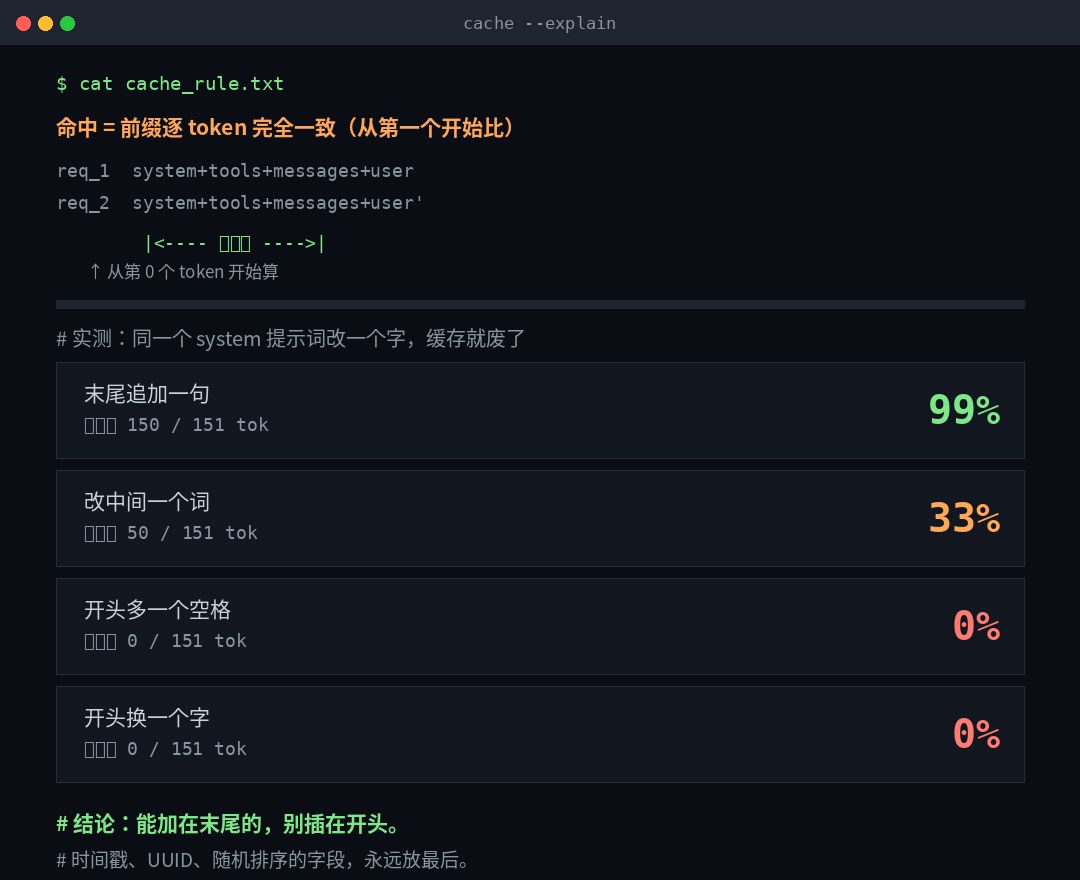
Fiz uma experiência: peguei uma dica do sistema de 151 tokens, mudei para locais diferentes, e olhei o quanto poderia ser reutilizado.
| Alterações | Prefixo reutilizável | Percentagem |
|---|---|---|
| Adicionar uma frase no fim | 150 / 151 | 99% |
| Muda a palavra no meio. | 50 / 151 | 33% |
| Mais um espaço no início | 0 / 151 | 0% |
| Comece com uma palavra. | 0 / 151 | 0% |
Vês aquele "mais um espaço no início"?Um espaço, caches, raspado, recalculou 151 fichas a preços originais.
Não é um bug, é o princípio: Cache é o estado de acumulação desde o início, o primeiro token muda, e as costas estão todas mortas.
Então há uma regra que pode ser aplicada imediatamente:O conteúdo constante está na frente e o conteúdo variável na última.
A maneira mais comum de inverter é inserir o tempo atual, ID solicitado, campos aleatoriamente ordenados no início da dica do sistema. É sempre um novo esconderijo.Estes campos ou são movidos para o fim ou simplesmente não colocar.
Existem alguns limiares fáceis de negligenciar.
- Há um comprimento mínimo.Muito curto um prefixo não dá o cache em tudo. OpenAI é GPT-5.6 e mais tarde 1.024 token; Antrópico é segregado por modelo, ambos em 512 / 1.024 / 2.048 / 4.096. Se não é tempo suficiente, não é errado.Silêncio., você só pode ver retornando o campo quântico.
- Há tempo para sobreviver.OpenAI padrão 30 minutos (até 12 horas); Antrópico padrão 5 minutos, até 1 hora. E desta vez...Iniciar a pedido, sem contar a partir do final da resposta -- se a resposta correr em quatro minutos, o slot de 5 minutos tem apenas uma janela de minutos.
- Vamos esperar um pelo outro.Entrada da 'Cache' Espera pelo Primeiro PedidoIniciar o retornoEntão está disponível. Dez pedidos foram enviados no mesmo segundo, e todos os 10 foram perdidos.
- Modelos alterados, ferramentas alteradas, slots de raciocínio alterados.O prefixo muda e a taxa de hit é zero.
Qual é a taxa de sucesso?
Não adivinhes. Ambas as famílias lhes deram um campo de volume:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Antrópico, o intuitivo especial:Ambos retornaram 0, o que significa que eles nem chegaram ao cache.- Normalmente porque prefixos não são mínimos.
V. Estrutura de preços: escrever mais dinheiro para ler menos
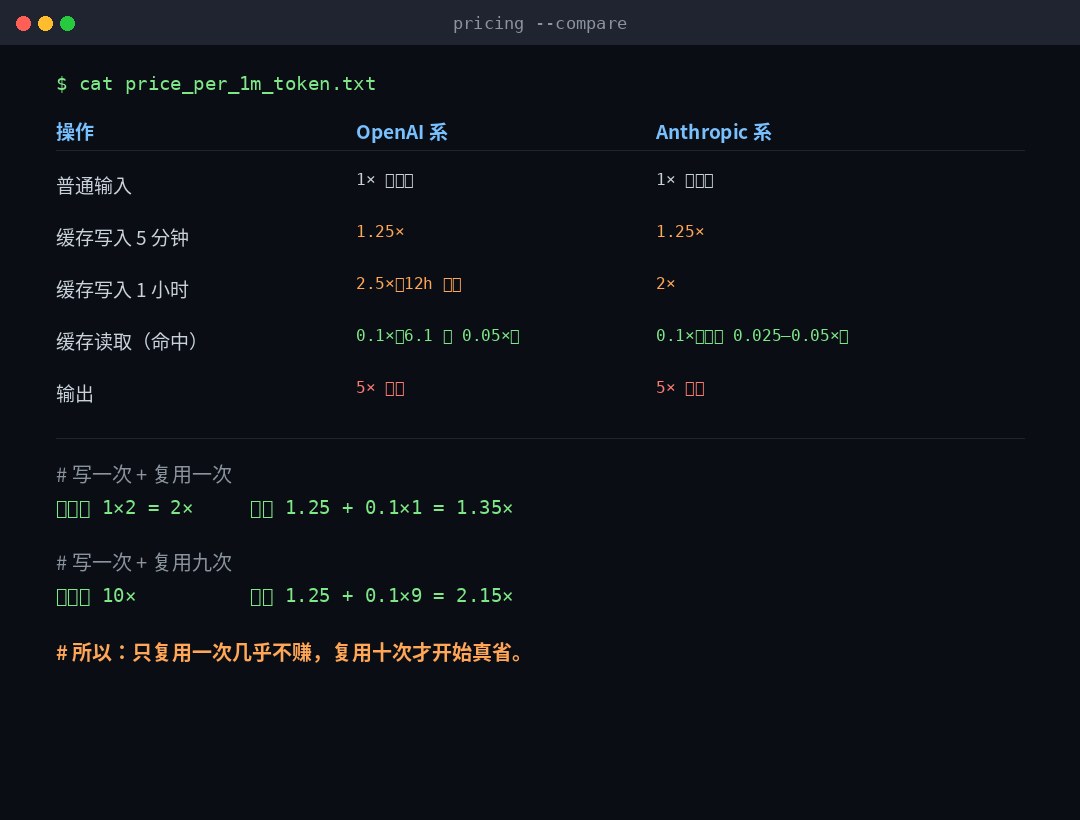
Cache não é livre, e muitos perderam.A primeira vez que você escreve no cache, você tem que aumentar o preço; em seguida, leia-o antes de fazer um desconto.
| Operação | OpenAI | Antrópico |
|---|---|---|
| Entrada Normal | 1x (linha de base) | 1x (linha de base) |
| Escrita de cache. Espaço curto | 1,25 x (30 minutos) | 1,25 x (5 minutos) |
| Cache escrevendo a longo prazo | 2, 5 x (12 horas) | 2x (1 hora) |
| Leitura da 'Cache' (Categoria) | 0, 1 x(GPT-6.1 é 0,05 x) | 0, 1 x(Modelo parcial 0.025 – 0,05 x) |
| Saída | Cerca de 5x | Cerca de 5x |
Tome o normal 0,1 x ler, 1,25 x escrever dois livros:
- Escreva uma vez + reutilizar uma vezCache 1,25 + 0,1 = 1, 35 x* Nenhum cache é 1 + 1 = 2 x.Província 32%.
- Escreva uma vez + repetir nove vezes: Cache 1,25 + 0,9 = 2, 15 x== Ligações externas ==Província 78 por cento.
Isto significa:Em um caso, o cache estava pouco ou mesmo ligeiramente perdido; foi apenas quando foi repetido mais de dez vezes que as economias eram reais.Essas "conversas temporárias únicas" são apenas um problema.
A propósito:A escrita da 'cache' é baseada no segmento do 'token', não pelo número.O ponto de interrupção em si é livre, e o dinheiro gasto depende de quanto tempo você realmente tem.
VI. Punishments, sistema de castigos, min
Os dois termos são frequentemente utilizados entrelaçados, mas são diferentes em termos de custos e autoridade.
| Nome | Inglês | Quem o escreveu? | Prioridade | Atribuição de taxas |
|---|---|---|---|---|
| Dica do Sistema | Estimprompt / instituições | Plataforma ou desenvolvedor de aplicativos | Maior | Digite token |
| Mensagem de Desenvolvimento | Não sei se vou conseguir fazer isso. | Aplicar o Desenvolvedor | Baixo (sobre os utilizadores) | Digite token |
| Dica do usuário | É assunto nosso. | Utilizador final | Menos do que os dois acima | Digite token |
| Mensagem Assistente | Não há razão para estares aqui. | Modelos geram-se | Não sei. | Token de Saída |
Dois pontos fáceis:
- A palavra "publicidade" é uma grande palavra.Refere-se, em geral, a todas as instruções de texto que você envia para o modelo, e a "sinta sistemática" é a que é a prioridade mais avançada e mais alta. Quando se trata de "anúncios são muito longos", o problema real é muitas vezes que o sistema é muito longo para defini-los.
- O papel também é caro.Cada mensagem é uma camada
{"role":...,"content":...}E a camada em si conta como símbolo. Quando há muitas mensagens, serão milhares de coisas.
Então o diálogo de limpeza está funcionando -- não genial, sim.Corta essa parte da história.Não sei. Mas, por sua vez, é importante notar que depois de esclarecer, os prefixos históricos do diálogo anteriormente mantido não serão necessários.
Sete ou sete dos poços em que pisei, copiem as conclusões.
- Use a palavra "personagem" para estimar o orçamento chinês.Errado. O chinês está perto de uma palavra e serás duas vezes mais baixo. Está pronto.
tiktokenDefinindo, ou olhando para trás no uso. - Pensei que seria atingido se fizesse uma pergunta semelhante.Não posso. Deve ser completamente consistente com o primeiro símbolo.
- Insere um carimbo de tempo no início da dica do sistema.Este é o assassino mais comum. Vai para o fim.
- É barato ver respostas curtas.O processo de pensamento do modelo de raciocínio é custado a preço de saída, responder 20 palavras, carga 900 token é normal.
- Cache para diálogo único.A reutilização salvou apenas 32%, mas adicionou uma camada de complexidade e custos de depuração. Vale pelo menos três vezes.
- Você pode adivinhar a taxa de sucesso sem olhar para um campo de medição.Dois.
cached_tokens/cache_read_input_tokensTodos voltaram em código claro. - Ele também pediu para usar o cache para aumentar a velocidade.O cache não estará disponível até que a primeira resposta comece, e pedidos para o mesmo segundo são em grande parte perdidos.
VIII. Uma lista do que foi feito
Podemos mudar hoje.
- Definir dicas e ferramentas do sistemaTudo o que muda.Vá para o fim da mensagem.
- Pressione a ferramentaOrdem FixaOrganizar. A ordem muda o prefixo, o prefixo muda.
- Primeira contagem: Digite o número de tokens no sistema + definição de ferramenta. Mais de 2.000 vale a pena optimizar.
Vale meio dia.
- Desmontar uma dica de sistema longo em um "segmento consistente + variável", com uma quebra de cache no final do segmento constante.
- Corre com o trânsito real. Grava.
cached_tokensPercentagem de entradas totais. Menos de 30% indica problemas de design prefixo. - Pressione o lado de saída também: o "somente saída" não é permitido explicar, o preço de saída é cinco vezes a entrada.
Não faças isso.
- Não escrevas uma gorjeta para o tesouro.Cache é dinheiro, não clareza.
- Não adicione aos scripts únicos a lógica dos caches, que são mais complicados do que as economias.
- Não se assume que caches podem ser usados em diferentes modelos.Mudar de modelos está mudando caches, com zero hits.
Finalmente.
Estas palavras são levadas até ao fim, e só dizem uma coisa:O modelo cobra "quanto lê" e "quanto escreve", e o cache é o único mecanismo que pode descontar "leia".
Então não é exactamente o quão bonita é a dica, pois não?Põe esse monte de coisas que não mudam sempre. Vamos.Não sei.
A maior parte do dinheiro que não podes poupar não é muito caro. O seu prefixo muda sempre.
Vou deixá-lo com a ação mais prática: da próxima vez que eu ver uma conta anormal, não duvide do aumento de preço do modelo. cached_tokens Aquela coluna.Não é zero, decide se você está pagando por matemática ou duplo.