
Inserisci, output, cache life: il nome sulla bolletta di token AI.
Iniziamo con i risultati:Ci sono solo due parole in questi termini che davvero costano di più: "Cacheft" e "output" token.Il resto sono i loro appunti.
Sono stato fatturato tre volte in due mesi, ed è la stessa cosa: penso di risparmiare denaro, e sto pagando il prezzo intero per lo stesso prefisso. Questo è quello in cui puoi rispondere almeno una domanda...Perche' ho 8.000 gettoni sul conto quando ho detto solo una parola?
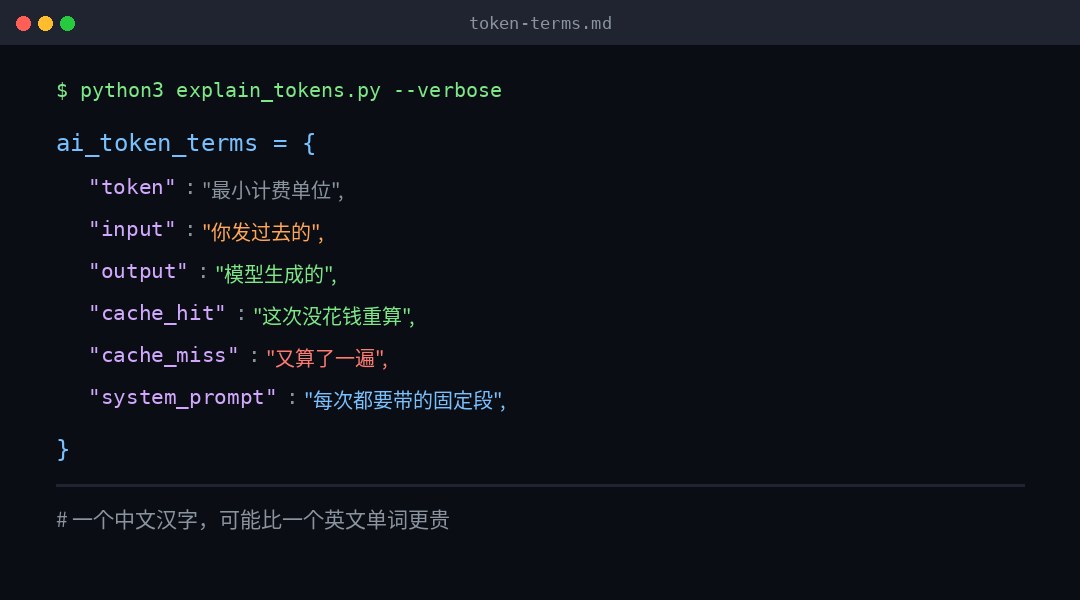
I. Token. Perché il cinese è più costoso?
Token è l'unità più piccola per l'elaborazione del testo modello. Non e' una parola. Non e' una parola.E' un pezzo tagliato dal semantico.Non lo so. Nella stessa frase, il numero di blocchi tagliati può differire da modello a codice.
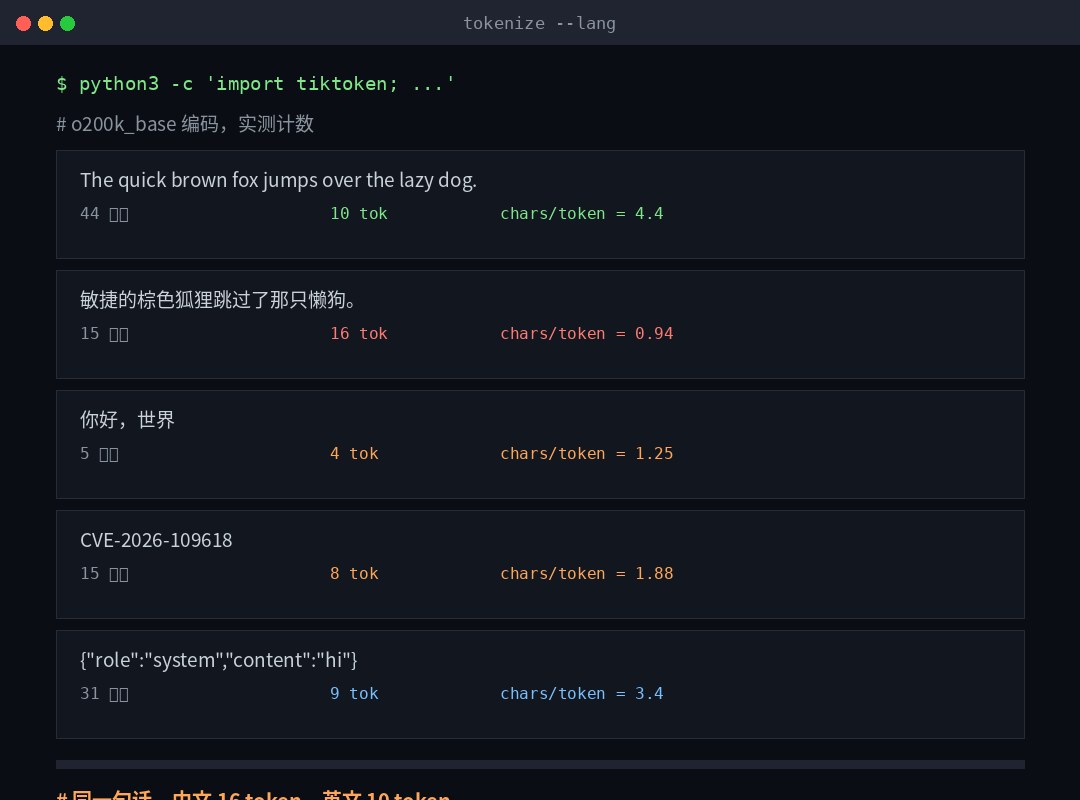
Lo prendo io. o200k_base Il codice misurava in realtà diversi gruppi e la differenza era maggiore del previsto:
| Testo | Numero di caratteri | Numero di token | Carattere / token |
|---|---|---|---|
| La scatola marrone veloce salta sopra il cane pigro. | 44 | 10 | 4.4 |
| La volpe bruna veloce è saltata sopra quel cane pigro. | 15 | 16 | 0.94 |
| Ciao, mondo. | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
Vedi il problema.Nella stessa frase, 10 gettoni in inglese e 16 in cinese.Circa 4 caratteri in ingleseUna parola, un tokenNon lo so.
Questo è molto poco amichevole per gli utenti cinesi: il "1 token ≈4 carattere" è un'esperienza in lingua inglese.Ne sottovaluterai più della metà in cinese.
C'e' un controintuitivo:CVE-2026-109618 Questo numero, 15 caratteri bruciano 8 gettoni. Numeri e trattini sono tagliati molto male.Quindi e' molto piu' costoso di quanto sembri.
Due, una richiesta, quattro paragrafi.
La prima volta che ho guardato il conto, non era costoso.E' solo una parola, ma 8.000 token.Non lo so. Poi e' diventato chiaro che piu' di te.
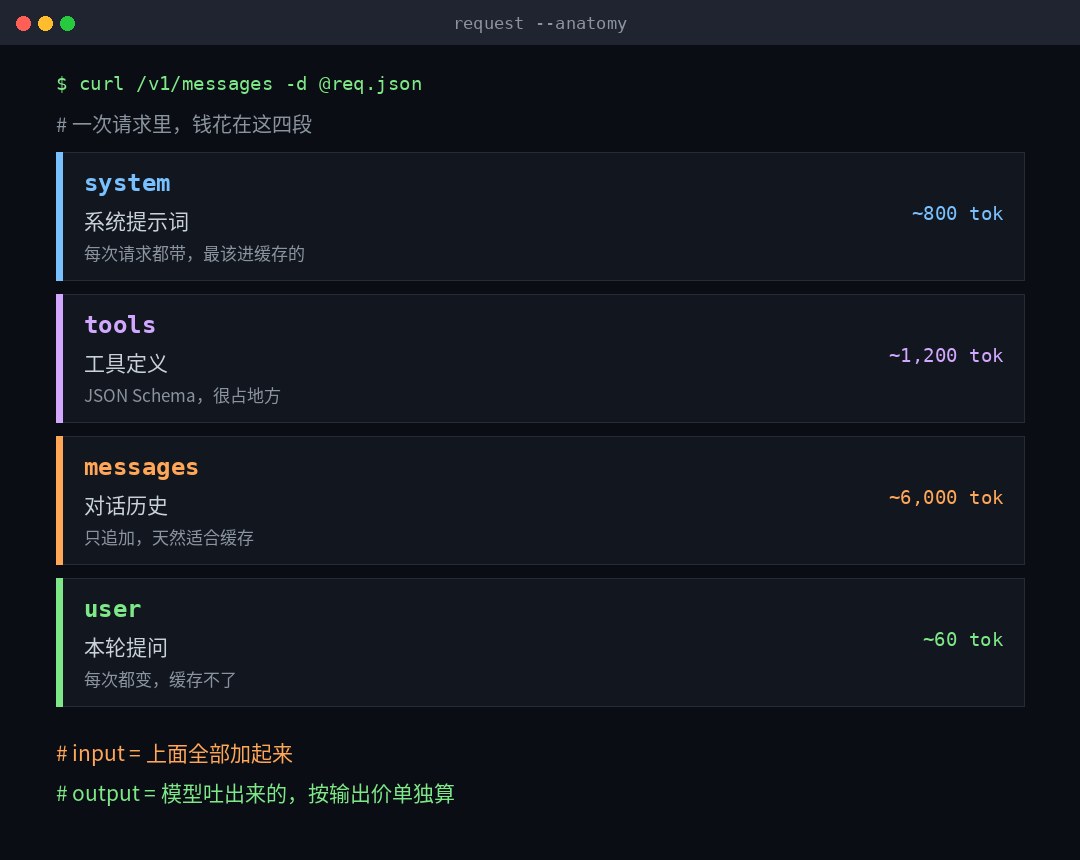
L'ingresso di una richiesta è di solito fatto in quattro pezzi:
| Paragrafo | Nome inglese | Che c'è? | Ti cambierà? |
|---|---|---|---|
| Sistema Hit | Sistema / inclusione | Chi sei, le regole, il formato di output? | E' praticamente la stessa cosa. |
| Definizione degli strumenti | Non credo. | Funzione JSON Schema e descrizione | Molto raramente. |
| Storia del dialogo | Messaggi / storia | Ogni giro di domande e risposte prima di voi, prenderli tutti. | Aggiungere solo |
| Domande per questo round | Mi dispiace, signore. | Quella cosa che hai appena chiamato. | Ogni volta. |
La prima volta che avevo paura, lo era.Lo strumento definisce la quantità di 1.200 tokenNon lo so. Una funzione con la descrizione dei parametri, JSON Schema si espande per prendere posto speciale. Hai scritto 20 strumenti, potresti mangiare 2000 per definizione.E non hai scritto una parola in questa parte, ma e' sempre carica.
C'è un punto chiave dietro di esso:I primi tre paragrafi sono “addizionali e non modificati” e il quarto comma cambia ogni volta.Non e' una coincidenza. Determina se la cache può essere colpita.
Tre: ingresso, uscita e quella nell'output.
Il calibro ufficiale di queste tre relazioni è il seguente:
- Inserisci token (input / policy token): Tutto quello che invii contiene i quattro paragrafi sopra.
- Produzione: Modellato. Attenzione...Non solo il testo che hai visto.
- Token (resoning tokens): Il modello di ragionamento è quello che pensa prima di dare la risposta. Non puoi vedere, ma...A prezzi di uscitaNon lo so.
Il terzo è il vero motivo per cui molte persone raddoppiano le bollette. Gestisco una sorta di lavoro con un modello di teoria, e vedo 20 parole nella risposta, e il disegno di legge è più di 900.Quel segno invisibile dell'880 e' tutto li' dentro.
Quindi è normale avere una contraddizione:Più breve la risposta, più economico meno.
Il prezzo di uscita è di solito circa cinque volte il prezzo di ingresso (vedere la tabella sottostante per ogni famiglia). Questo spiega un principio di integrità:Può essere risolto con input. Non farlo uscire.Mettere il modello di risposta, l'esempio di formato, nel suggerimento di sistema (più basso), in modo che non si organizza in modo tale che sia costoso.
Cachelina e poco attraente: questa è la sezione dell'intero testo da ricordare
Cosa sono?
I modelli sono considerati intermedi quando vengono letti. Questa parte è la più costosa.
La cache prompt è uno stato prefisso.La prossima volta che incontriamo lo stesso prefisso, lo useremo direttamente e non più ricalcolo.
Quindi c'erano due parole:
- Cache hit: Questo prefisso è stato trovato nella cache. Questa parte è stata inserita e pressata.Lo sconto.Le tasse.
- Cache missNon riesco a trovarlo. Ricalcola il prezzo.
I termini del colpo sono più difficili di quanto pensi.
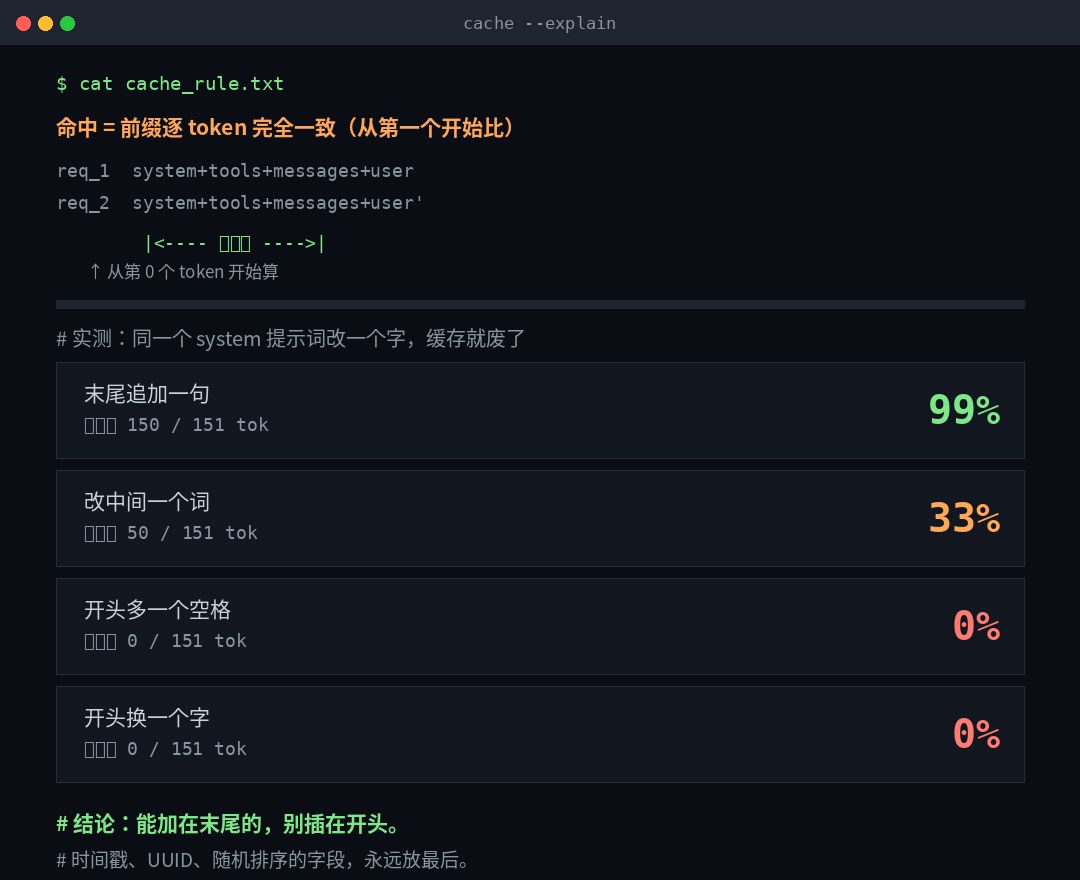
La chiave è la parola "prefisso".Non si tratta di fare la stessa domanda.
Ho fatto un esperimento: ho preso un suggerimento di sistema di 151 token, l'ho cambiato in luoghi diversi, e ho guardato quanto potrebbe essere riutilizzato.
| Variazioni | Prefisso riutilizzabile | Percentuale |
|---|---|---|
| Aggiungi una frase alla fine | 150 / 151 | 99% |
| Cambia la parola al centro. | 50 / 151 | 33% |
| Ancora uno spazio all'inizio | 0 / 151 | 0% |
| Inizia con una parola. | 0 / 151 | 0% |
Vedi che "un altro spazio all'inizio"?Uno spazio, cache, raschiato, ricalcolato 151 gettoni a prezzi originali.
Non è un bug, è il principio: Cache è lo stato di accumulo dall'inizio, il primo token cambia, e la schiena è tutta morta.
Quindi c'è una regola che può essere applicata immediatamente:Il contenuto costante è nella parte anteriore e il contenuto variabile nell'ultimo.
Il modo più comune per capovolgere è quello di inserire il tempo corrente, ID richiesto, campi casualmente ordinati all'inizio del suggerimento del sistema. E' come una nuova cache ogni volta.Questi campi vengono spostati alla fine o semplicemente non inseriti.
Ci sono un paio di soglie facili da aggirare.
- C'e' una lunghezza minima.Troppo breve un prefisso non dà affatto la cache. OpenAI è GPT-5.6 e poi 1,024 token; Antropico è segregato per modello, sia in 512 / 1,024 / 2,048 / 4,096. Se non è abbastanza lungo, non è sbagliato.Silenzio., si può vedere solo ritornando il campo quantistico.
- C'è tempo per la sopravvivenza.Di default OpenAI 30 minuti (fino a 12 ore); Antropic default 5 minuti, fino a 1 ora. E questa volta...Inizia a richiesta, non contando dalla fine della risposta -- se la risposta funziona in quattro minuti, lo slot di 5 minuti ha solo una finestra minuto.
- Ci aspetteremo.Cache Entry aspetta per la prima richiestaInizia a tornareAllora e' disponibile. Dieci richieste sono state inviate nello stesso secondo, e tutte le 10 sono state perse.
- Modelli modificati, strumenti modificati, slot di ragionamento modificato.Il prefisso cambia e il tasso di successo è zero.
Qual e' il tasso di successo?
Non indovinare. Entrambe le famiglie hanno dato loro un campo di volume:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Antropico, il particolare intuitivo:Entrambi hanno restituito 0, il che significa che non hanno nemmeno raggiunto la cache.- Di solito perché i prefissi non sono minimi.
V. Struttura dei prezzi: scrivere più soldi per leggere meno
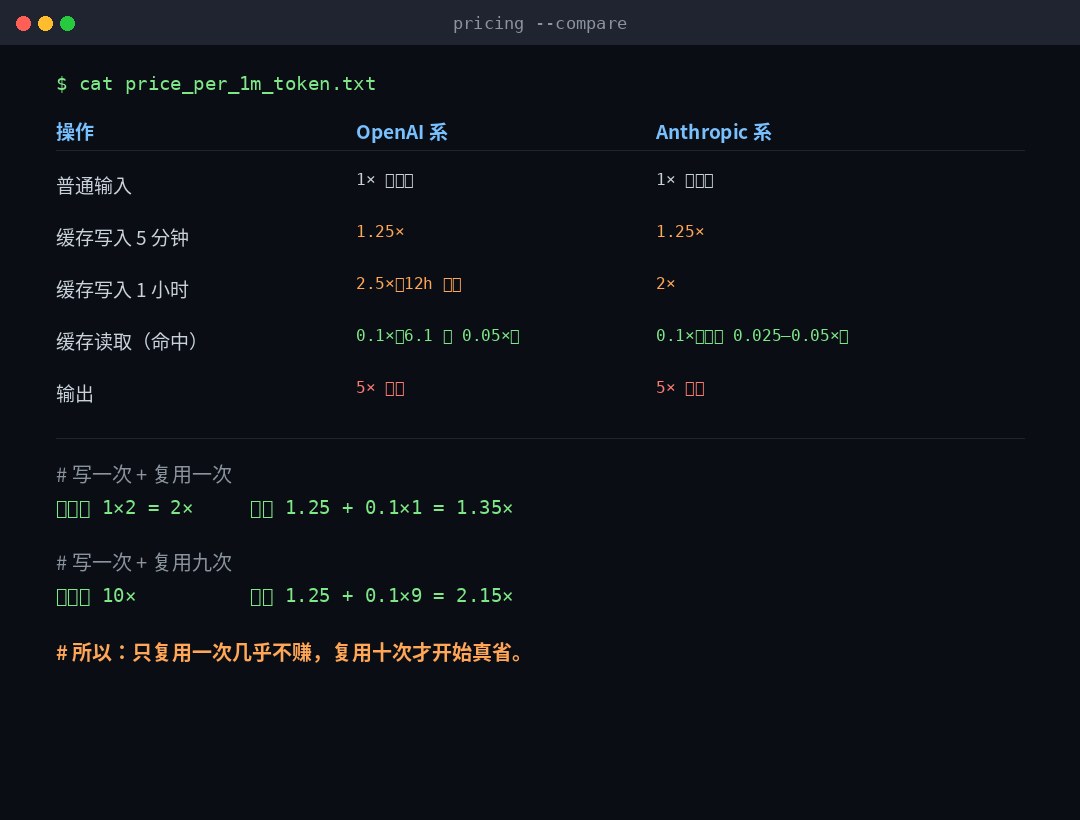
Cache non è libero, e molti lo hanno perso.La prima volta che scrivi nella cache, devi alzare il prezzo; poi leggerlo prima di fare uno sconto.
| Operazione | OpenAI | Antropia |
|---|---|---|
| Input normale | 1x (baseline) | 1x (baseline) |
| Scritto da cache. Fessura breve | 1.25 x (30 minuti) | 1.25 x (5 minuti) |
| Cache scrittura a lungo termine | 2.5 x (12 ore) | 2x (1 ora) |
| Cache Read (Categoria) | 0,1 x(GPT-6.1 è 0,05 x) | 0,1 x(modello parziale 0.025 – 0.05 x) |
| Produzione | Circa 5x | Circa 5x |
Prendere il normale 0,1 x lettura, 1.25 x scrivere due libri:
- Scrivere una volta + riutilizzare una voltaCache 1.25 + 0.1 = 1.35 x; nessuna cache è 1 + 1 = 2 x.Provincia 32 per cento.
- Scrivi una volta + ripeti nove volte: Cache 1.25 + 0.9 = 2.15 x; non la cache è 10x.Provincia 78 per cento.
Questo significa:In un caso, la cache era appena o addirittura leggermente persa; era solo quando si ripeteva più di dieci volte che i risparmi erano reali.Quelle "conversazioni temporanee di una volta" sono solo un problema.
A proposito:La scrittura Cache si basa sul segmento token, non sul numero.Il breakpoint stesso è libero, e il denaro speso dipende da quanto tempo effettivamente avete.
VI. PUNICAZIONI, PUNICAZIONI SISTEMI, min
I due termini sono spesso utilizzati in combinazione, ma sono diversi in termini di costi e autorità.
| Nome | Inglese | Chi l'ha scritto? | Priorità | Attribuzione |
|---|---|---|---|---|
| Sistema Hit | Stymprompt / Istituzioni | Platformr o Sviluppatore di applicazioni | Più alto | Entra in token |
| Messaggio di sviluppo | Non sono sicuro di poterlo fare. | Applicare lo sviluppatore | Inferiore (oltre gli utenti) | Entra in token |
| Suggerimento utente | Sono affari nostri. | utente finale | Meno dei due sopra | Entra in token |
| Messaggio aggiunto | Non c'e' motivo per cui sei qui. | I modelli si generano | Non lo so. | Token di uscita |
Due punti facili:
- La parola "pubblicità" è una parola importante.Si riferisce in generale a tutte le istruzioni di testo che invii al modello, e il "risultato sistematico" è quello che è la priorità più avanti e più alta. Quando si tratta di "pubblici annunci sono troppo lunghi", il vero problema è spesso che il sistema è troppo lungo per definirli.
- Il ruolo è anche costoso.Ogni messaggio è uno strato
{"role":...,"content":...}E lo strato stesso conta come token. Quando ci saranno molti messaggi, saranno migliaia di cose.
Così il dialogo di pulizia sta funzionando -- non genio, sì.Taglia quella parte della storia.Non lo so. Ma a sua volta, è importante notare che dopo aver chiarito, i prefissi storici del dialogo precedentemente tenuto non saranno necessari.
Sette o sette dei box che ho fatto, copia le conclusioni.
- Utilizzare la parola "carattere" per stimare il bilancio cinese.Sbagliato. Il cinese e' vicino a una parola, e tu sarai il doppio di meno. E' pronto.
tiktokenDefinire, o guardare indietro l'uso. - Pensavo di essere colpito se facessi una domanda simile.Non posso. Deve essere completamente coerente dal primo token.
- Inserire un timestamp all'inizio del suggerimento del sistema.Questo e' il piu' comune killer della cache. Vai alla fine.
- E' economico vedere risposte brevi.Il processo di pensiero del modello di ragionamento è costato al prezzo di uscita, risposta 20 parole, carica 900 token è normale.
- Cache per un dialogo di una volta.Il riutilizzo ha salvato solo il 32 per cento, ma ha aggiunto uno strato di complessità e costi di debug. Ne vale almeno tre volte.
- È possibile indovinare il tasso di successo senza guardare un campo di misura.Due.
cached_tokens/cache_read_input_tokensTutti tornarono in chiaro. - Ha anche chiesto di usare la cache per aumentare la velocità.La cache non sarà disponibile fino all'inizio della prima risposta, e le richieste per lo stesso secondo sono in gran parte mancate.
VIII. Una lista di ciò che è stato fatto
Possiamo cambiare oggi.
- Definire suggerimenti e strumenti del sistemaTutto quello che cambia.Spostati alla fine del messaggio.
- Pressa per utensiliOrdine fissoD'accordo. L'ordine cambia il prefisso, il prefisso cambia.
- Primo conteggio: Digitare il numero di token nella definizione di sistema + strumento. Più di 2000 vale la pena ottimizzare.
Vale mezzo giorno.
- Smontare un accenno a lungo sistema in un segmento "consistente + variabile ", con una pausa cache alla fine del segmento costante.
- Girare con traffico reale. Registra.
cached_tokensPercentuale degli ingressi totali. Meno del 30% indica problemi di progettazione prefisso. - Premere anche il lato di uscita: il "solo uscita" non è consentito spiegare, il prezzo di uscita è cinque volte l'ingresso.
Non farlo.
- Non scrivere una mancia di nove anni per la cache.Cache è denaro, non chiarezza.
- Non aggiungere a script one-off la logica delle cache, che sono più complicate del risparmio.
- Non si presume che le cache possano essere utilizzate in diversi modelli.I modelli di commutazione stanno cambiando le cache, con zero colpi.
Finalmente.
Queste parole sono portate alla fine, e dicono solo una cosa:Il modello addebita "quanto legge" e "quanto scrive", e la cache è l'unico meccanismo che può "leggere".
Quindi non e' esattamente quanto sia bello il suggerimento, vero?Metti quel mucchio di cose che non cambiano ogni volta. Andiamo.Non lo so.
La maggior parte dei soldi che non puoi risparmiare non è troppo costoso. Il tuo prefisso cambia ogni volta.
Ti lascio con l'azione più pratica: la prossima volta che vedo un disegno di legge anormale, non dubitare dell'aumento di prezzo del modello. cached_tokens Quella colonna.Non è zero, decide se stai pagando per matematica o doppia.