
Entrée, sortie, durée de cache : le nom sur la facture de jeton AI.
Commençons par les résultats :Il n'y a que deux mots dans ces termes qui vous coûtent vraiment plus cher: "Cacheft" et "output" jeton.Les autres sont leurs notes.
J'ai été facturé trois fois en deux mois, et c'est la même chose : je pense que j'épargne de l'argent, et je paie le plein prix pour le même préfixe. C'est celui où vous pouvez répondre à au moins une question...Pourquoi ai-je 8 000 jetons sur le projet de loi alors que je n'ai dit qu'un mot?
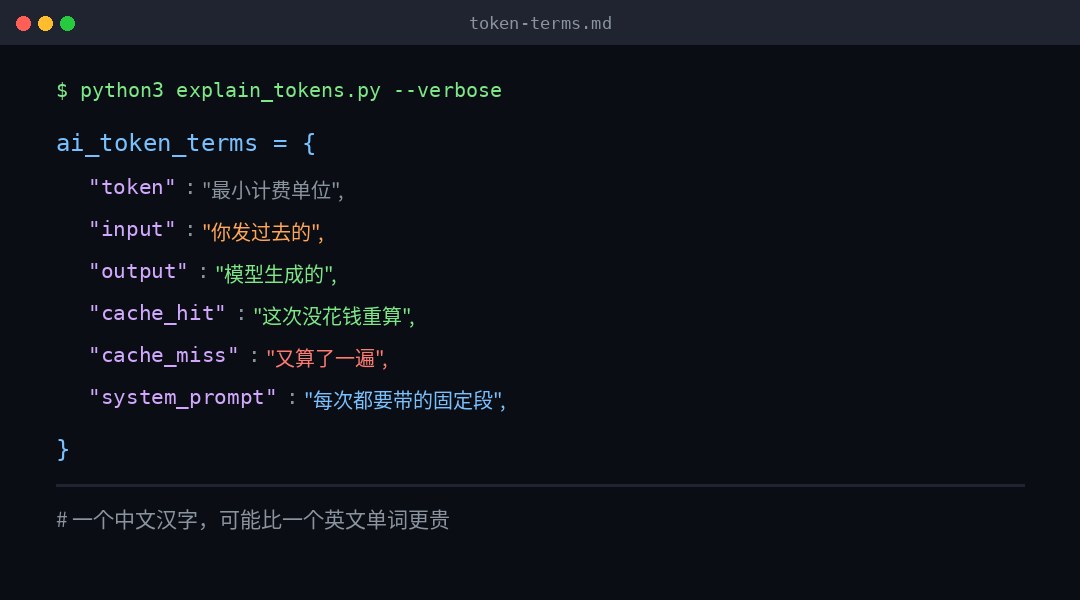
I. Jeton. Pourquoi le chinois est-il plus cher ?
Token est la plus petite unité de traitement de texte modèle. Ce n'est pas un mot. Ce n'est pas un mot.C'est un morceau coupé par la sémantique.Je ne sais pas. Dans la même phrase, le nombre de blocs coupés peut différer du modèle au code.
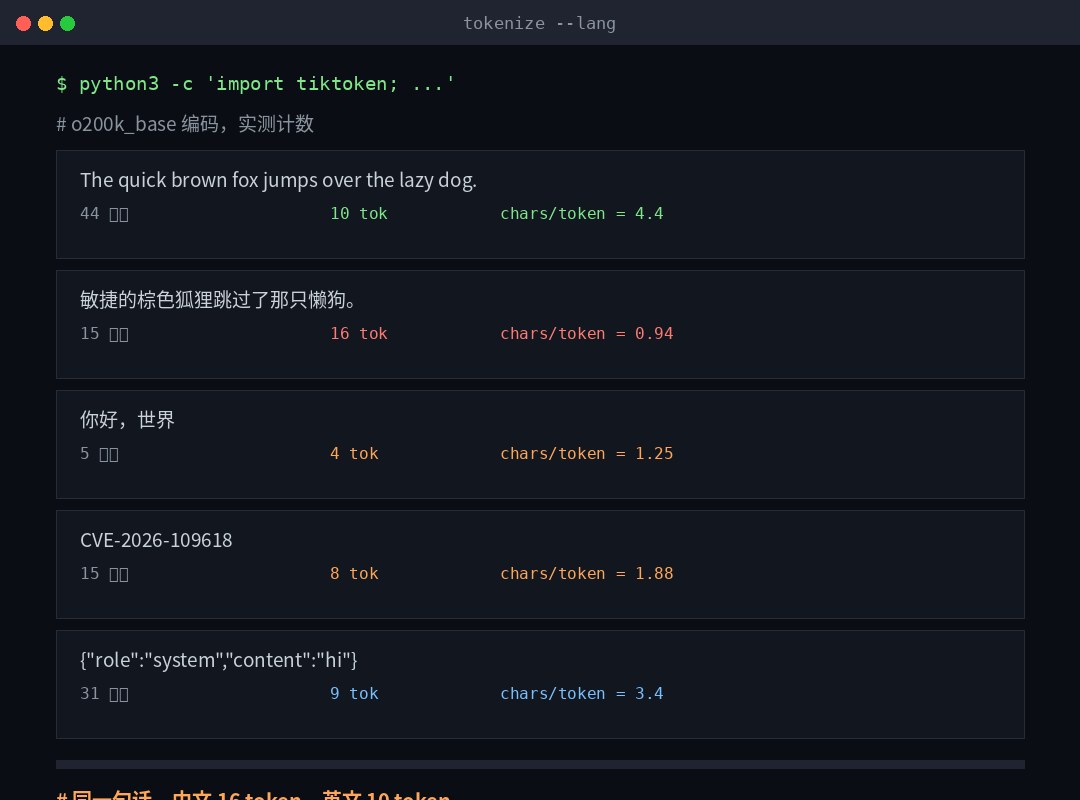
Je le prends. o200k_base Le code mesurait en fait plusieurs groupes et la différence était plus grande que prévu:
| Texte | Nombre de caractères | Numéro de jeton | Caractère / jeton |
|---|---|---|---|
| La boîte brune rapide saute sur le chien paresseux. | 44 | 10 | 4.4 |
| Le renard brun rapide a sauté sur ce chien paresseux. | 15 | 16 | 0.94 |
| Bonjour, le monde. | 5 | 4 | 1.25 |
| CVE-2026-109618 | 15 | 8 | 1.88 |
Voyez le problème.Dans la même phrase, 10 jetons en anglais et 16 en chinois.Environ 4 caractères en anglaisUn mot, un jetonJe ne sais pas.
C'est très peu convivial pour les utilisateurs chinois : le "1 jeton " est une expérience en anglais.Vous en sous-estimerez plus de la moitié en chinois.
Il y a un contre-intuitif :CVE-2026-109618 Ce nombre, 15 caractères brûlent 8 jetons. Les nombres et les tirets sont très mal coupés.Donc c'est beaucoup plus cher que ça en a l'air.
Deux, une demande, quatre paragraphes.
La première fois que j'ai examiné le projet de loi, ce n'était pas cher.Ce n'est qu'un mot, mais 8 000 jetons.Je ne sais pas. Alors il est devenu clair que plus que vous.
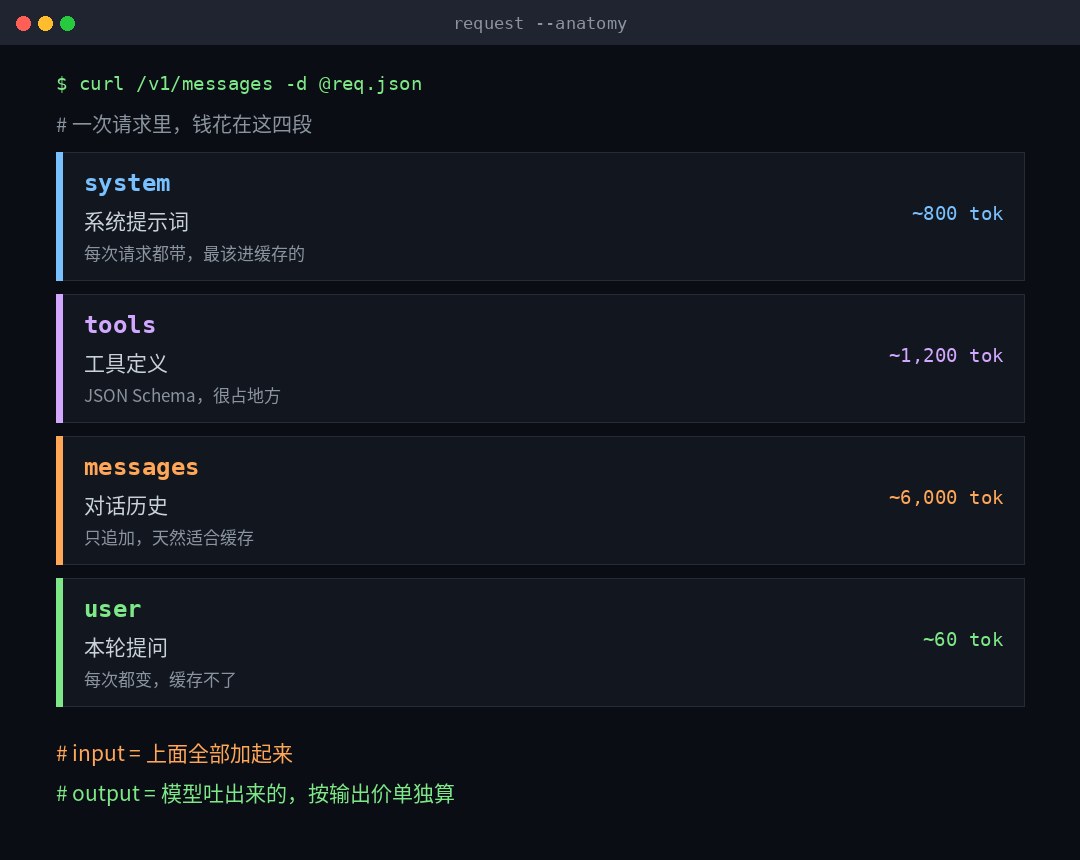
La saisie d'une demande se fait généralement en quatre parties :
| Paragraphe | Nom anglais | Qu'est-ce que c'est ? | Ça va changer ? |
|---|---|---|---|
| Conseil du système | Système/inclusion | Qui êtes-vous, les règles, le format de sortie ? | C'est pratiquement pareil. |
| Définition de l'outil | Je ne crois pas. | Fonction JSON Schéma et description | Très rarement. |
| Histoire du dialogue | Messages / historique | Chaque tour de questions et de réponses avant vous, prenez-les toutes. | Ajouter seulement |
| Questions pour ce cycle | Désolé, monsieur. | Ce truc que tu viens d'appeler. | Chaque fois. |
C'était la première fois que j'avais peur.L'outil définit la quantité de 1200 jetonsJe ne sais pas. Fonction avec description des paramètres, JSON Schema se développe pour prendre place. Vous avez écrit 20 outils, vous pourriez manger 2000 par définition.Et tu n'as pas tapé un mot dans cette partie, mais c'est toujours chargé.
Il y a un point clé derrière ça :Les trois premiers paragraphes sont additionnels et non modifiés et le quatrième paragraphe change à chaque fois.Ce n'est pas une coïncidence. Il détermine si le cache peut être touché.
Trois : entrée, sortie, et celle dans la sortie.
Le calibre officiel de ces trois relations est le suivant :
- Entrez un jeton (input / jetons de politique): Tout ce que vous envoyez contient les quatre paragraphes ci-dessus.
- Produit: Modélisé. Attention...Pas seulement le texte que vous avez vu.
- Token (jetons résonnants): Le modèle de raisonnement est ce qu'il pense avant de donner la réponse. Vous ne pouvez pas voir, mais ça...Aux prix de la productionJe ne sais pas.
Le troisième est la vraie raison pour laquelle beaucoup de gens doublent leurs factures. Je dirige une sorte de travail avec un modèle théorique, et je vois 20 mots dans la réponse, et le projet de loi est de plus de 900.Ce 880 jeton invisible, tout est là.
Il est donc normal d'avoir une contradiction :Plus la réponse est courte, moins c'est cher.
Le prix de la production est habituellement environ cinq fois le prix des intrants (voir le tableau ci-dessous pour chaque ménage). Ceci explique un principe d'intégrité :Il peut être résolu avec entrée. Ne le laisse pas sortir.Mettre le modèle de réponse, l'exemple de format, dans l'indice système (inférieur), de sorte qu'il ne s'organise pas de telle manière qu'il soit coûteux.
Cacheline et peu attrayant: c'est la section du texte entier qui doit être rappelée
C'est quoi ?
Les modèles sont comptés comme intermédiaires lorsqu'ils sont lus. Cette partie est la plus chère.
Le cache rapide est un état préfixé.La prochaine fois que nous rencontrerons le même préfixe, nous l'utiliserons directement et ne recalculerons plus.
Il y avait donc deux mots :
- Coup de cache: Ce préfixe a été trouvé dans le cache. Cette partie a été entrée et pressée.La réduction.Frais.
- Cache miss- Je ne le trouve pas. Recalculez le prix.
Les termes du succès sont plus durs que vous ne le pensez.
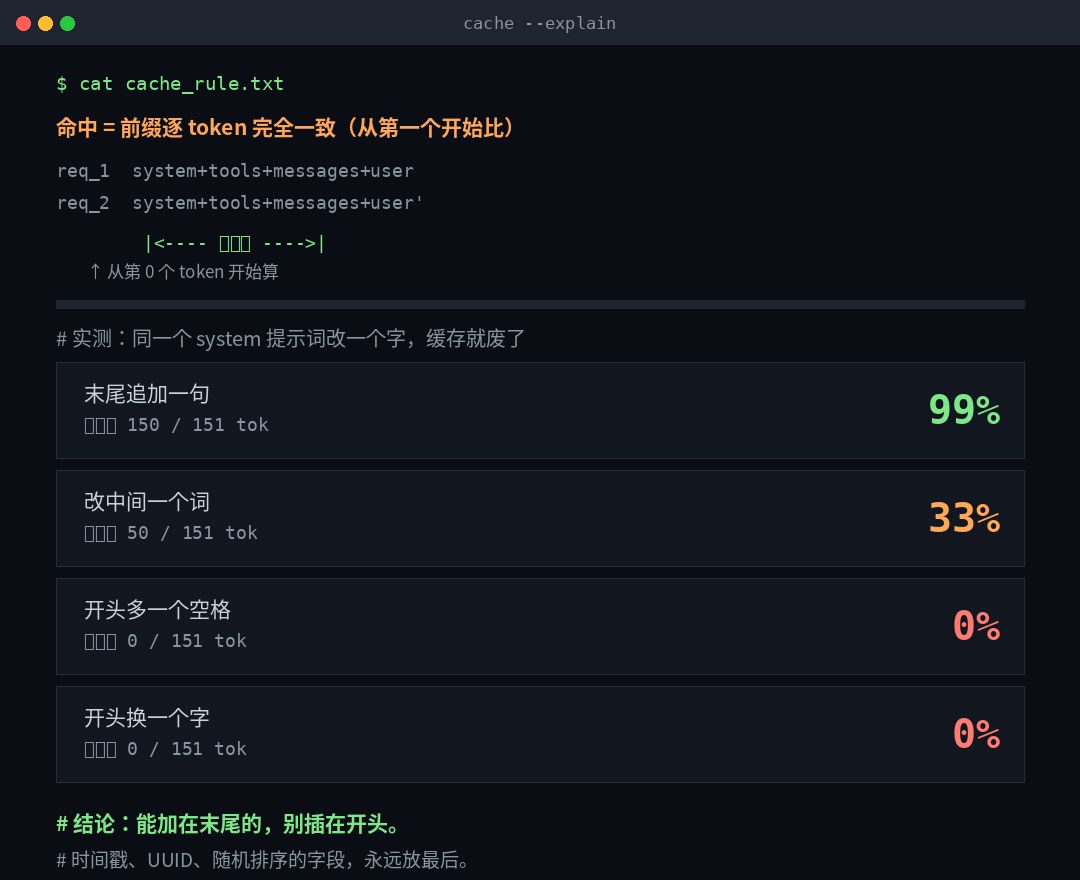
La clé est le mot "préfixe".Il ne s'agit pas de poser la même question.
J'ai fait une expérience : j'ai pris un indice de 151 jetons, je l'ai changé à différents endroits, et j'ai examiné combien il pouvait être réutilisé.
| Changements | Préfixe réutilisable | Pourcentage |
|---|---|---|
| Ajouter une phrase à la fin | 150 / 151 | 99% |
| Changez le mot au milieu. | 50 / 151 | 33% |
| Un espace de plus au début | 0 / 151 | 0% |
| Commencez par un mot. | 0 / 151 | 0% |
Tu vois "un espace de plus au début" ?Un espace, caches, mis au rebut, recalculé 151 jetons à prix d'origine.
Ce n'est pas un bug, c'est le principe : Cache est l'état d'accumulation depuis le début, le premier jeton change, et le dos est mort.
Il y a donc une règle qui peut être appliquée immédiatement:Le contenu constant est en avant et le contenu variable en dernier.
La façon la plus courante de retourner est d'insérer l'heure actuelle, l'ID demandé, les champs triés au hasard au début de l'indice système. C'est comme un nouveau cache à chaque fois.Ces champs sont soit déplacés à la fin, soit simplement pas mis.
Il y a quelques seuils faciles à retenir.
- Il y a une longueur minimale.Trop court un préfixe ne donne pas du tout le cache. OpenAI est GPT-5.6 et plus tard 1.024 jeton; Anthropic est séparé par modèle, les deux dans 512 / 1.024 / 2.048 / 4.096. Si ce n'est pas assez long, ce n'est pas mal.Silence., vous pouvez seulement voir en retournant le champ quantique.
- Il y a du temps pour survivre.Par défaut OpenAI 30 minutes (jusqu'à 12 heures); Par défaut anthropique 5 minutes, jusqu'à 1 heure. Et cette fois...Commencez sur demande, sans compter à la fin de la réponse -- si la réponse tourne en quatre minutes, la fente de 5 minutes n'a qu'une minute de fenêtre.
- Nous nous attendrons.Cache Entrée Attendre la première demandeCommencer à revenirAlors c'est disponible. Dix demandes ont été envoyées dans la même seconde, et les 10 demandes ont été manquées.
- Des modèles modifiés, des outils modifiés, des créneaux de raisonnement modifiés.Le préfixe change et le taux de frappe est nul.
Quel est le taux de succès ?
Devinez pas. Les deux familles leur ont donné un champ de volume:
OpenAI  : usage.prompt_tokens_details.cached_tokens
Anthropic: usage.cache_read_input_tokens / cache_creation_input_tokens
Anthropique, l'intuitif spécial :Les deux ont renvoyé 0, ce qui signifie qu'ils n'ont même pas atteint le cache.- D'habitude, les préfixes ne sont pas minimes.
V. Structure des prix: écrire plus d'argent pour lire moins
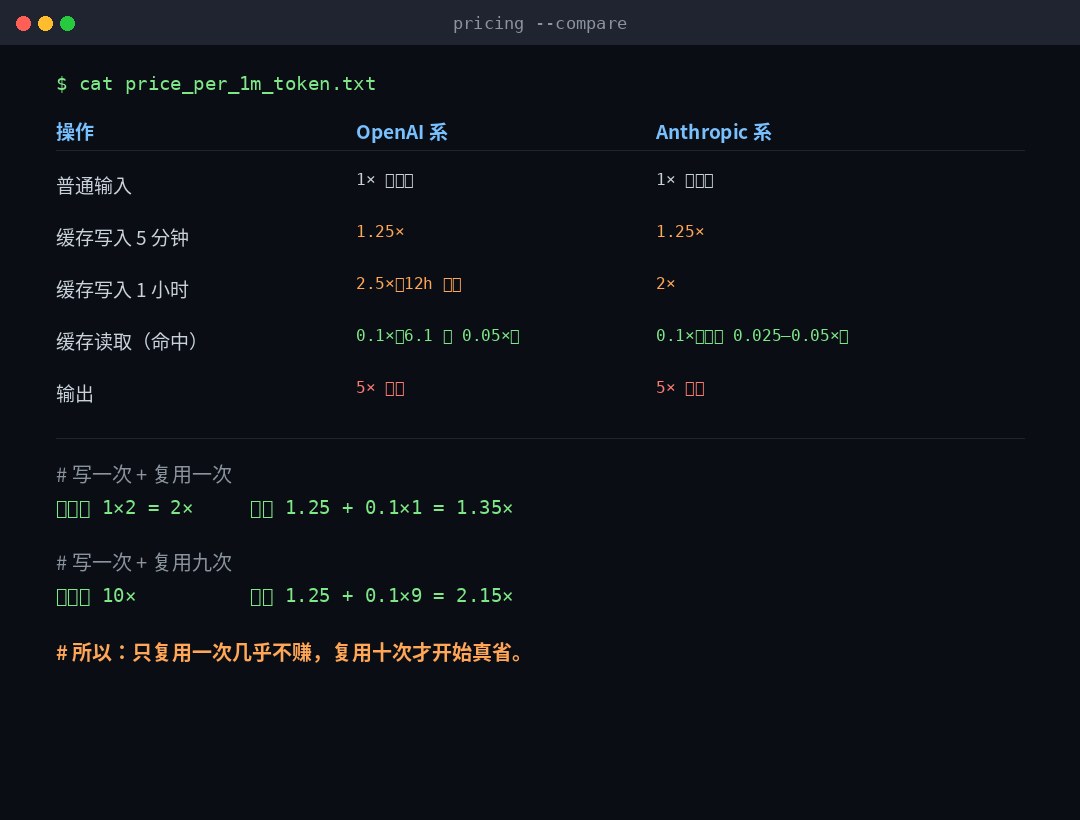
Cache n'est pas libre, et beaucoup l'ont manqué.La première fois que vous écrivez dans le cache, vous devez augmenter le prix, puis le lire avant de faire un rabais.
| Fonctionnement | OpenAI | Anthropique |
|---|---|---|
| Entrée normale | 1x (base) | 1x (base) |
| Cache écrit. Courte fente | 1,25 x (30 minutes) | 1,25 x (5 minutes) |
| Cache à long terme | 2,5 x (12 heures) | 2x (1 heure) |
| Cache Lire (catégorie) | 0,1 x(GPT-6.1 est 0,05 x) | 0,1 x(modèle partiel 0,025 – 0,05 x) |
| Produit | Environ 5x | Environ 5x |
Prenez la normale 0,1 x lire, 1,25 x écrire deux livres:
- Écrire une fois + réutiliser une foisCache 1,25 + 0,1 = 1,35 x; aucun cache n'est 1 + 1 = 2 x.Province 32 %.
- Écrire une fois + répéter neuf foisCache 1,25 + 0,9 = 2.15 x;pas le cache est 10x.Province 78 %.
Cela signifie:Dans un cas, le cache était à peine ou même légèrement perdu; ce n'est que lorsqu'il a été répété plus de dix fois que les économies étaient réelles.Ces « conversations temporaires ponctuelles » ne sont qu'un problème.
Au fait :L'écriture de cache est basée sur le segment des jetons, pas sur le nombre.Le point d'arrêt lui-même est libre, et l'argent dépensé dépend de combien de temps vous avez réellement.
VI. POUVOIRS, POUVOIRS DU SYSTÈME, min
Les deux termes sont souvent mélangés, mais ils sont différents en termes d'établissement des coûts et d'autorisation.
| Dénomination | changements climatiques | Qui l'a écrit ? | Priorité | Attribution des droits |
|---|---|---|---|---|
| Conseil du système | Stymprompt / institutions | Développeur de plateforme ou d'application | Plus haut | Saisissez le jeton |
| Message du développeur | Je ne suis pas sûr de pouvoir le faire. | Appliquer le développeur | Moins (sur les utilisateurs) | Saisissez le jeton |
| Conseil de l'utilisateur | C'est notre affaire. | Utilisateur final | Moins des deux ci-dessus | Saisissez le jeton |
| Message adjoint | Il n'y a aucune raison pour que tu sois là. | Les modèles se génèrent eux-mêmes | Je ne sais pas. | Marque de sortie |
Deux points faciles:
- Le mot "publicité" est un grand mot.Il se réfère en général à toutes les instructions texte que vous envoyez au modèle, et la « pointe systémique » est celle qui est la plus avant et la plus haute priorité. Lorsqu'il s'agit de « publicité trop longue », le vrai problème est souvent que le système est trop long pour les définir.
- Le rôle est également coûteux.Chaque message est une couche
{"role":...,"content":...}Et la couche elle-même compte comme jeton. Quand il y aura beaucoup de messages, ce sera des milliers de choses.
Donc le dialogue de nettoyage fonctionne -- pas le génie, oui.Coupe cette partie de l'histoire.Je ne sais pas. Mais à son tour, il est important de noter qu'après l'éclaircissement, les préfixes historiques du dialogue précédent ne seront pas nécessaires.
Sept ou sept des fosses sur lesquelles j'ai marché, copiez les conclusions.
- Utilisez le mot "caractère" pour estimer le budget chinois.Faux. Le chinois est proche d'un mot, et vous serez deux fois plus court. C'est prêt.
tiktokenDéfinition, ou retour à l'usage. - Je pensais être frappé si je posais une question similaire.Je ne peux pas. Il doit être complètement cohérent depuis le premier jeton.
- Insère un timbre-temps au début de l'indice système.C'est le tueur de cache le plus courant. Passez à la fin.
- C'est pas cher de voir de petites réponses.Le processus de réflexion du modèle de raisonnement est chiffré au prix de sortie, répond 20 mots, charge 900 jeton est normal.
- Cache pour dialogue ponctuel.La réutilisation n'a permis d'économiser que 32 %, mais a ajouté une couche de complexité et de coûts de débogage. Ça vaut au moins trois fois.
- Vous pouvez deviner le taux de succès sans regarder un champ de mesure.Deux.
cached_tokens/cache_read_input_tokensIls sont tous revenus en code clair. - Il a également demandé à utiliser le cache pour augmenter la vitesse.Le cache ne sera pas disponible avant que la première réponse commence, et les demandes pour la même seconde sont largement manquées.
VIII. Une liste des mesures prises
Nous pouvons changer aujourd'hui.
- Définir les conseils et les outils du systèmeTout change.Passez à la fin du message.
- Appuyez sur l'outilOrdre fixeArrête. L'ordre change le préfixe, le préfixe change.
- Premier compte : saisissez le nombre de jetons dans le système + définition de l'outil. Plus de 2.000 vaut la peine d'être optimisés.
Ça vaut une demi-journée.
- Démonter un indice de long système dans un " segment cohérent + variable " , avec une pause cache à la fin du segment constant.
- Faites le tour avec du vrai trafic. Enregistrement.
cached_tokensPourcentage des intrants totaux. Moins de 30% indique des problèmes de conception préfixe. - Appuyez également sur le côté sortie : le "output only" n'est pas autorisé à expliquer, le prix de sortie est cinq fois plus élevé que l'entrée.
Ne fais pas ça.
- N'écrivez pas un bout de neuf trente pour le cache.Cache est de l'argent, pas de la clarté.
- N'ajoutez pas aux scripts ponctuels la logique des caches, qui sont plus compliqués que les économies.
- On ne suppose pas que les caches peuvent être utilisés dans différents modèles.Changer de modèle change de cache, avec zéro hits.
Enfin.
Ces paroles sont prises jusqu'à la fin, et elles ne disent qu'une chose:Le modèle charge « combien il lit » et « combien il écrit », et le cache est le seul mécanisme qui peut refuser « lire ».
Ce n'est pas vraiment beau, n'est-ce pas ?Mettez cette pile de choses qui ne changent pas à chaque fois. Allons-y.Je ne sais pas.
La plupart de l'argent que vous ne pouvez pas économiser n'est pas trop cher. Votre préfixe change à chaque fois.
Je vais vous laisser avec l'action la plus pratique: la prochaine fois que je vois une facture anormale, ne doutez pas de la hausse des prix du modèle. cached_tokens Cette colonne.Ce n'est pas zéro, décide si tu payes pour les maths ou le double.